unordered关联式容器
unordered关联式容器一共有四个,我们将对其中两个unordered_set和unordered_map进行介绍
这两个容器的使用方法几乎与map和set完全一致二叉树,二叉树.
unordered_map
template <class Key,       // unordered_map::key_type
class T,                   // unordered_map::mapped_type
class Hash = hash<Key>,    // unordered_map::hasher
class Pred = equal_to<Key>,// unordered_map::key_equal
class Alloc = allocator< pair<const Key,T> >  // unordered_map::allocator_type
> class unordered_map;unordered_map是存储<key, value>键值对的关联式容器,其允许通过key快速的索引到与其对应的value,所以本质上来说它也是用于查找的工具
它的迭代器只支持单向迭代器
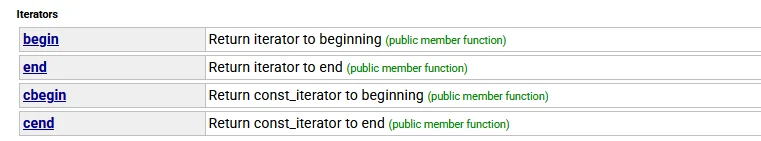
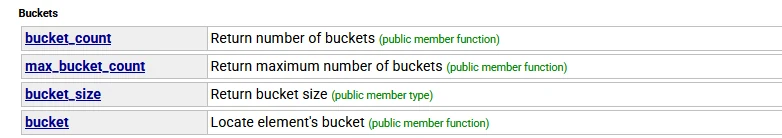
以及有常用的接口
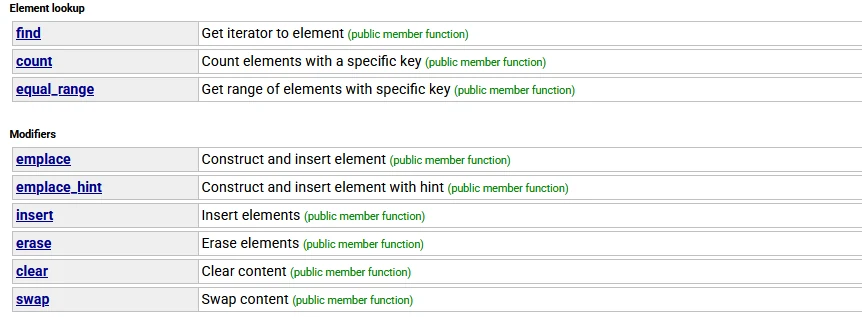
真正涉及到底层的是这几个接口,不过并不常用
void test_unordered_map()
{
	unordered_map<int, int> um;
	um.insert(make_pair(1, 1));
	um.insert(make_pair(3, 3));
	um.insert(make_pair(2, 2));
	um.insert(make_pair(5, 5));
	um.insert(make_pair(1, 1));
	for (auto e : um)
	{
		cout << e.first<<":"<<e.second << " ";
	}
}
可以看到,它可以实现去重,但是不能实现排序
unordered_set
和set也几乎一样
template < class Key,     // unordered_set::key_type/value_type
class Hash = hash<Key>,     // unordered_set::hasher
class Pred = equal_to<Key>, // unordered_set::key_equal
class Alloc = allocator<Key>// unordered_set::allocator_type
> class unordered_set;
它是不按特定顺序存储唯一元素的容器,并且允许根据单个元素的值快速检索各个元素.依然是一个查找工具
它的迭代器依然是单向的
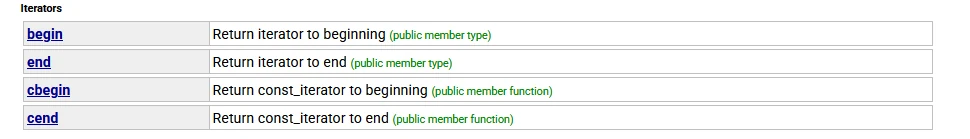
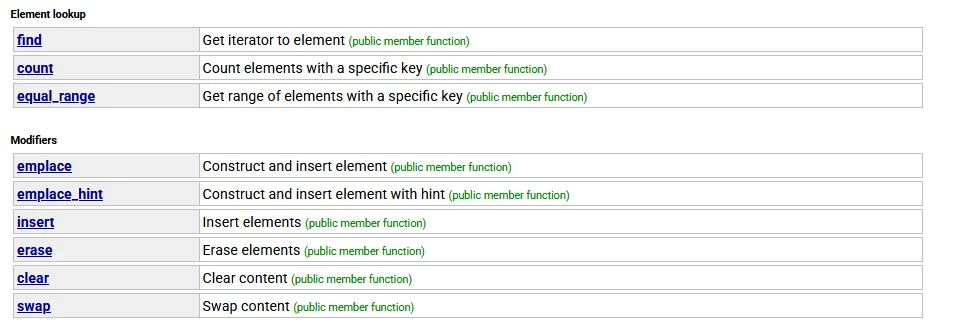
并且有常见接口
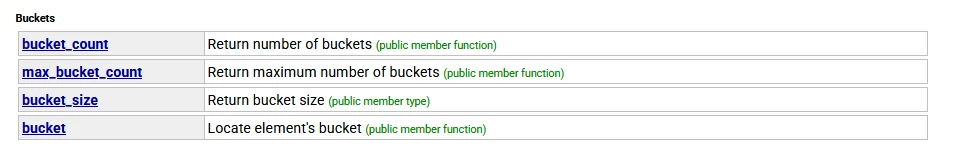
以及哈希桶接口
void test_unordered_set()
{
	unordered_set<int> us;
	us.insert(1);
	us.insert(3);
	us.insert(2);
	us.insert(5);
	us.insert(1);
	for (auto e : us)
	{
		cout << e << " ";
	}
}
得到的结果依然是无序的.
unordered容器和map/set的对比
- 它都可以实现
key和key/value的搜索场景,并且功能和使用基本一样 map/set的底层是使用红黑树实现的,增删查改的效率为\(O(logN)\),而unordered_map/set底层使用的是Hash,增删查改的时间复杂度是\(O(1)\)unordered容器遍历结果是无序的,而map/set则是有序的map/set是双向迭代器,unordered则只是单向迭代器
练习
重复了N次的数据
给你一个整数数组 nums ,该数组具有以下属性:
nums.length == 2 * n.nums包含n + 1个不同的元素,其中n个值在数组中出现 恰好一次.nums中恰有一个元素重复n次
找出并返回重复了 n 次的那个元素.
class Solution {
public:
    int repeatedNTimes(vector<int>& nums) {
        unordered_map<int,int> countMap;
        for(auto e : nums)
        {
            countMap[e]++;
        }
        int N = nums.size()/2;
        for(auto kv : countMap)
        {
            if(kv.second == N)
            {
                return kv.first;
            }
        }
        return -1;
    }
};
两个数组的交集I
给定两个数组 nums1 和 nums2 ,返回 _它们的_ .输出结果中的每个元素一定是 唯一 的.我们可以 不考虑输出结果的顺序
思路:把一个数组的数据存到set中,遍历另外一个,如果在set就是交集元素之一,否则不是.注意需要进行去重
class Solution {
public:
    vector<int> intersection(vector<int>& nums1, vector<int>& nums2) {
        unordered_set<int> countSet1;
        unordered_set<int> countSet2;
        vector<int> ret;
        for(auto e:nums1)
        {
            countSet1.insert(e);
        }
        for(auto e:nums2)
        {
            countSet2.insert(e);
        }
        unordered_set<int>::iterator it;
        for(auto e:countSet2)
        {
            it = countSet1.find(e);
            if(it!=countSet1.end())
            {
                ret.push_back(e);
            }
        }
        return ret;
    }
};
哈希
在顺序结构以及平衡树中,由于元素关键码与存储位置缺乏对应关系,在进行查找的时候不可避免的需要去进行遍历.因此在顺序结构中查找的复杂度为\(O(N)\),树结构复杂度为\(O(log_2N)\).
如果构造一种存储结构,通过某种函数(hashFunc)使元素的存储位置与它的关键码之间能够建立映射的关系,那么在查找时通过该函数可以很快找到该元素,这样查找的复杂度就是\(O(1)\).而这个思路,实际上就是哈希
假设我们存储的数据是1,2,5,9,1000000,888888,23,我们要用这几个数据建立哈希表,就要开辟一个100000大小的数组,然后对应位置+1.这样的建表方式我们称为直接定值法.
哈希函数
但是这显然就不合理,空间浪费太多了.为了解决这个问题,我们引入哈希函数.该函数描述的是数据与数组位置的映射关系
我们可以把哈希函数设置为index = key%capacity,这样的方式就叫做除留余数法.这样数据计算出来余数是多少就放哪个位置.
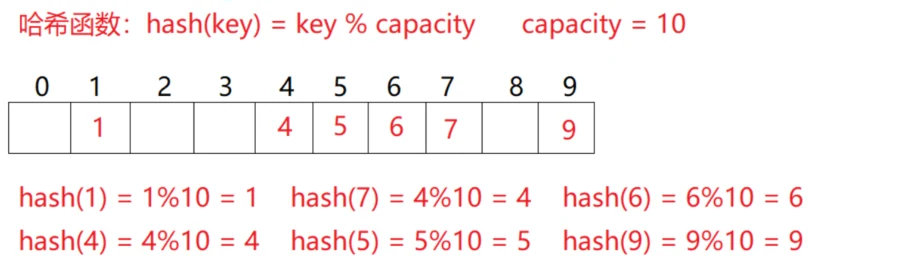
而实际上,哈希函数远不止这几种取法(除留余数法最常用)
- 平方取中法:假设关键字为1234,对它平方就是1522756,抽取中间的3位227作为哈希地址;再比如关键字为4321,对它平方就是18671041,抽取中间的3位671(或710)作为哈希地址.平方取中法比较适合不知道关键字的分布,而位数又不是很大的情况
- 折叠法:折叠法是将关键字从左到右分割成位数相等的几部分(最后一部分位数可以短些),然后将这几部分叠加求和,并按散列表表长,取后几位作为散列地址.折叠法适合事先不需要知道关键字的分布,适合关键字位数比较多的情况
- 随机数法:选择一个随机函数,取关键字的随机函数值为它的哈希地址,即
H(key) = random(key)
哈希冲突
但是这样就会有一些问题,8和18在这个规则下就会被分配到同一个位置,此时就被称为哈希冲突.哈希函数设计的越精妙,产生哈希冲突的可能性就越低,但是无法避免哈希冲突,因此我们必须对哈希冲突进行处理.
闭散列
开放定址法.说人话就是找到下一个空位置存进去.但是这个空位怎么找?
- 线性探测:即挨着往后去找空位置.目标位置为
i,发现已经被存入,就去看i+1.一直往下直到找到为止 - 二次探测:目标位置为
i,发现已经被存入,就去看\(i+k^2\),一直往下直到找到为止
使用二次探测的好处在于让冲突更加分散,一定程度上能够减小冲突的发生.
开散列
开散列也就是哈希桶,之前的思路是遇到冲突就往后找,开散列的思路是遇到冲突后不去抢别人的位置,而是把它挂在这个位置下面
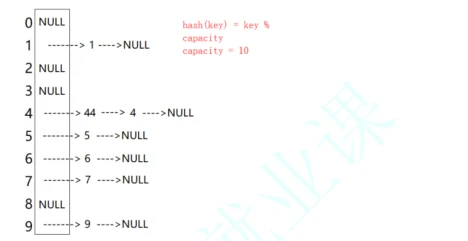
闭散列的模拟实现
哈希表要被封装为map和set,就会有有kv模型,我们可以按照二叉树中定义数组,如果是kv模型,就传入pair.由于可能需要进行增容,我们底层可以直接用一个Vector去实现.并且按照我们之前的操作,比较需要兼容常规类型和pair类型,因此还需要传入仿函数KeyOfT
template<class K,class T,class KeyOfT>
class HashTable
{

private:
	vector<T> _tables;
	size_t _num;  //有效数据个数
};
但是这样也有点问题
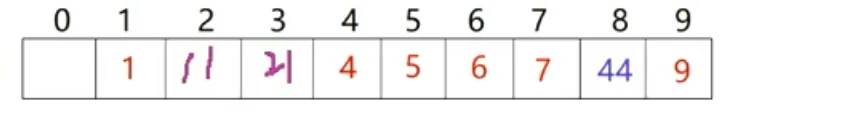
如果我要查找21,21%10=1,去1的位置找发现不对,再往后找就能找到.但是如果我把11删了,去1的位置找发现是空,我就找不到21了.为了解决这个问题我就要整个表全找一遍,效率就下降太多了.所以我们存储的时候还可以多存一个状态.这样我们就把2,3位置标记为存在.当2位置元素被删除后,就标记为删除,这样在访问的时候遇到删除状态就继续往后找.
enum State
{
	EMPTY,
	EXITS,
	DELETE,
};
template <class T>
struct HashData
{
	T _data;
	State _state;
};
这样哈希的基本框架就有了
enum State
{
	EMPTY,
	EXIST,
	DELETE,
};
template <class T>
struct HashData
{
	T _data;
	State _state;
};
//unordered_set ->HashTable<K,K>
//unordered_map->HashTable<K,pair<K,V>>
template<class K,class T>
class HashTable
{
typedef HashData<T> HashData;
public:
private:
	vector<HashData> _tables;
	size_t _num;
};
Insert
然后我们来实现插入
bool Insert(const T& d)
{
	KeyOfT koft;
	//计算在表中的位置
	size_t index = koft(d) % _tables.size();
	while (_tables[index]._state == EXIST)
	{
		if (koft(_tables[index]._data) == koft(d))
			return false;
		index++;
		if (index == _tables.size())
		{
			index = 0;
		}
	}
	_tables[index]._data = d;
	_tables[index]._state = EXIST;
	_num++;
	return true;
}实际上就是根据哈希函数算下标,然后线性探测.但是还没完,表满了怎么办?而对于哈希表,是不能满的.表越满,冲突越多,效率越低.因此哈希表一般来说并不是满了才进行增容.我们引入一个东西叫做负载因子,定义为
\[负载因子=\frac{表中数据}{表长}\]
用于刻画哈希表满的程度.在开放定址法中,一般负载因子达到0.7就要开始增容.
if (10*_num / _tables.size() >= 7)
{
	//增容
}
增容怎么进行?直接开更大的数组表的大小变了,映射关系就变了,这就导致原来的数据映射关系失效了.所以增容要分为三步
- 开一个2倍的空间
- 将旧表的数据重新映射到新表
- 释放旧表的空间
传统的思路是开2倍大小的新表,然后遍历旧表数据,重新计算在新表中的位置.这样就要重复上述全部过程
if (10*_num / _tables.size() >= 7)
{
	//增容
	vector<HashData> newTables;
	newTables.resize(_tables.size() * 2);
	//重新计算
	for (size_t i = 0; i < _tables.size(); i++)
	{
		if (_tables[i]._state == EXIST)
		{
			size_t index = koft(_tables[i]._data) % newTables.size();
			while (newTables[index]._state == EXIST)
			{
				index++;
				if (index == _tables.size())
				{
					index = 0;
				}
			}
			newTables[index] = _tables[i];
		}
	}
	_tables.swap(newTables);
}但是这样会崩,因为一开始vector.size()是0,在计算负载因子的时候会有除0错误.所以还要额外判断一下
bool Insert(const T& d)
{
	KeyOfT koft;
	if (_tables.size() == 0 || 10*_num / _tables.size() >= 7)
	{
		//增容
		vector<HashData> newTables;
		size_t newSize = _tables.size() == 0 ? 10 : _tables.size() * 2;
		newTables.resize(newSize);
		//重新计算
		for (size_t i = 0; i < _tables.size(); i++)
		{
			if (_tables[i]._state == EXIST)
			{
				size_t index = koft(_tables[i]._data) % newTables.size();
				while (newTables[index]._state == EXIST)
				{
					index++;
					if (index == _tables.size())
					{
						index = 0;
					}
				}
				newTables[index] = _tables[i];
			}
		}
		_tables.swap(newTables);
	}

	//计算在表中的位置
	size_t index = koft(d) % _tables.size();
	while (_tables[index]._state == EXIST)
	{
		if (koft(_tables[index]._data) == koft(d))
			return false;
		index++;
		if (index == _tables.size())
		{
			index = 0;
		}
	}
	_tables[index]._data = d;
	_tables[index]._state = EXIST;
	_num++;
	return true;
}
这样就完成了.实际上还有更简洁一些的思路,我直接创建一个新的增容号的哈希表,然后遍历原哈希表进行插入
HashTable<K,T, KeyOfT> newht;
size_t newSize = _tables.size() == 0 ? 10 : _tables.size() * 2;
newht._tables.resize(newSize);
for (size_t i = 0; i < _tables.size(); i++)
{
	if (_tables[i]._state == EXIST)
	{
		newht.Insert(_tables[i]._data);
	}
}
_tables.swap(newht._tables);如果要把线性探测改成二次探测,无非就是把index++变成index+=i*i
size_t start = koft(d) % _tables.size();
size_t index = start;
int i = 1;
while (_tables[index]._state == EXIST)
{
	if (koft(_tables[index]._data) == koft(d))
		return false;
	index = start + i*i;
	i++;
	index %= _tables.size();
}
_tables[index]._data = d;
_tables[index]._state = EXIST;
_num++;
Find
HashData* Find(const K& key)
{
	KeyOfT koft;
	size_t index = key % _tables.size();
	while (_tables[index]._state != EMPTY)
	{
		if (koft(_tables[index]._data) == key)
		{
			if (_tables[index]._state == EXIST)
				return &_tables[index];
			else if (_tables[index]._state == DELETE)
				return nullptr;
		}
		index++;
		if (index == _tables.size())
			index = 0;
	}
	return nullptr;
}查找的逻辑是:首先根据key计算出对应的下标,然后去对应位置向后查看,如果走到状态为空的位置都没有找到,就说明该节点不存在于该表中.如果找到了值相同的位置,还需要检查该位置状态是否为被删除状态.而由于哈希表不可能是满的,所以一定能够找到一共空的位置,因此不会陷入死循环.
Erase
bool Erase(const K& key)
{
	HashData* ret = Find(key);
	if (ret)
	{
		ret->_state = DELETE;
		return true;
	}
	return false;
}删除的实现非常简单,只需要找到对应的位置并将该位置状态改为DELETE即可,由于状态变量的存在,并不需要真的把这个位置的数据删除.
汇总
namespace CLOSE_HASH
{
	enum State
	{
		EMPTY,
		EXIST,
		DELETE,
	};
	template <class T>
	struct HashData
	{
		T _data;
		State _state;
	};

	//unordered_set ->HashTable<K,K>
	//unordered_map->HashTable<K,pair<K,V>>
	template<class K, class T, class KeyOfT>

	class HashTable
	{
		typedef HashData<T> HashData;
	public:
		bool Insert(const T& d)
		{
			KeyOfT koft;
			if (_tables.size() == 0 || 10 * _num / _tables.size() >= 7)
			{
				//增容
			//	vector<HashData> newTables;
			//	size_t newSize = _tables.size() == 0 ? 10 : _tables.size() * 2;
			//	newTables.resize(newSize);
			//	//重新计算
			//	for (size_t i = 0; i < _tables.size(); i++)
			//	{
			//		if (_tables[i]._state == EXIST)
			//		{
			//			size_t index = koft(_tables[i]._data) % newTables.size();
			//			while (newTables[index]._state == EXIST)
			//			{
			//				index++;
			//				if (index == _tables.size())
			//				{
			//					index = 0;
			//				}
			//			}
			//			newTables[index] = _tables[i];
			//		}
			//	}
			//	_tables.swap(newTables);
			//}
				HashTable<K, T, KeyOfT> newht;
				size_t newSize = _tables.size() == 0 ? 10 : _tables.size() * 2;
				newht._tables.resize(newSize);
				for (size_t i = 0; i < _tables.size(); i++)
				{
					if (_tables[i]._state == EXIST)
					{
						newht.Insert(_tables[i]._data);
					}
				}
				_tables.swap(newht._tables);
			}

			//计算在表中的位置
			//线性探测
			size_t index = koft(d) % _tables.size();
			while (_tables[index]._state == EXIST)
			{
				if (koft(_tables[index]._data) == koft(d))
					return false;
				index++;
				if (index == _tables.size())
				{
					index = 0;
				}
			}
			_tables[index]._data = d;
			_tables[index]._state = EXIST;
			_num++;
			//二次探测
			/*size_t start = koft(d) % _tables.size();
			size_t index = start;
			int i = 1;
			while (_tables[index]._state == EXIST)
			{
				if (koft(_tables[index]._data) == koft(d))
					return false;
				index = start + i*i;
				i++;
				index %= _tables.size();
			}
			_tables[index]._data = d;
			_tables[index]._state = EXIST;
			_num++;*/
			return true;
		}
		HashData* Find(const K& key)
		{
			KeyOfT koft;
			size_t index = key % _tables.size();
			while (_tables[index]._state != EMPTY)
			{
				if (koft(_tables[index]._data) == key)
				{
					if (_tables[index]._state == EXIST)
						return &_tables[index];
					else if (_tables[index]._state == DELETE)
						return nullptr;
				}
				index++;
				if (index == _tables.size())
					index = 0;
			}
		}
		bool Erase(const K& key)
		{
			HashData* ret = Find(key);
			if (ret)
			{
				ret->_state = DELETE;
				return true;
			}
			return false;
		}
	private:
		vector<HashData> _tables;
		size_t _num;
	};

	template <class K>
	struct KeyOfSet
	{
		const K& operator()(const K& key)
		{
			return key;
		}
	};
}
开散列的模拟实现
实际上闭散列并不是一个很好的解决方案,因为它的思路是我的位置冲突了就去占据别人的位置,这样的思路会造成冲突的加剧,整体效率都偏低.而开散列的思路是内部消化冲突,不去影响其他数据,这显然是更优的.
它的底层和闭散列有本质上的区别,数组不再是一个一个的元素,而是一个结点的指针(即链表的头指针)
template<class T>
struct HashNode
{
	T _data;
	HashNode<T>* _next;
	HashNode(const T& data)
		:_data(data),_next(nullptr)
	{ }
};
template<class K,class T,class KeyOfT>
class HashTable
{
	typedef HashNode<T>* Node;
private:
	vector<Node*> _tables;
	size_t _num;
};
Insert
插入首先要来计算该元素在表中的位置
KeyOfT koft;
size_t index = koft(data) % _tables.size();
然后再来找该元素是否已经存在在表中,如果不在就进行插入
Node* cur = _tables[index];
while (cur)
{
	if (koft(cur->_data) == koft(data))
		return false;
	else
		cur = cur->_next;
}
Node* newnode = new Node(data);
newnode->_next = _tables[index];
_tables[index] = newnode;
_num++;
return true;
插入的步骤是,遍历链表,如果没有该元素就头插.但是随着元素的增多,这个链表越挂越长,哈希表就失去的原本的意义.所以我们需要对其进行增容,依然是通过负载因子的方式进行.
对于开散列来说,负载因子是能够超过一的.为了让空间利用率高一点,我们可以就控制在1
if (_tables.size() == _nums)
{
	vector<Node*> newtables;
	size_t newsize = _tables.size() == 0 ? 10 : 2 * _tables.size();
	newtables.resize(newsize);
	for (size_t i = 0;i<_tables.size();i++)
	{
		Node* cur = _tables[i];
		while (cur)
		{
			Node* next = cur->_next;
			size_t index = koft(cur->_data)%newtables.size();
			cur->_next = newtables[index];//头插法
			newtables[index] = cur;
			cur = next;
		}
		_tables[i] = nullptr;
	}
	swap(newtables, _tables);
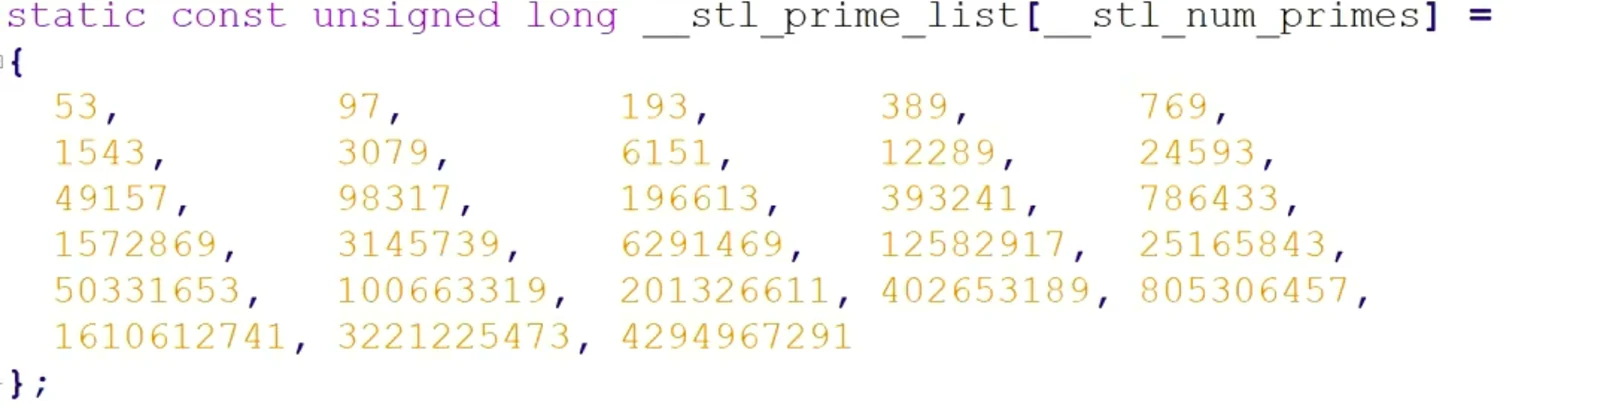
}增容的方法是遍历旧表,把它重新插入到新表.在Java中,当某个结点的链表长度超过了8,就会改成挂红黑树,这就是Java的HashMap的处理方式.实际上经过研究,按素数进行扩容会最大程度的减少冲突.所以在STL中,实际上维护了一张素数表
void TestHashTable2()
{
	OPEN_HASH::HashTable<string, string, OPEN_HASH::KeyOfSet<string>> ht;
	ht.insert("sort");
	ht.insert("string");
	ht.insert("");
}
我们执行了这个函数,然后就编译不通过了
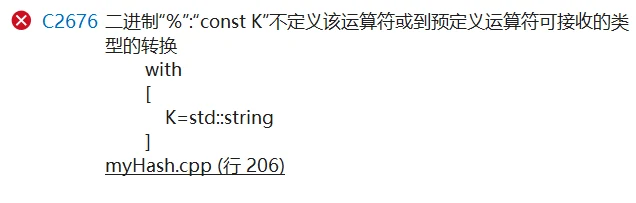
原因是
size_t index = koft(cur->_data)%newtables.size();但是string怎么能取模呢.我们可以再拓展一个仿函数,来把key转换为整形
template<class K,class T,class KeyOfT,class Hash= _Hash<K>>
// ...
size_t HashFunc(const K& key)
{
	Hash hash;
	return hash(key);
}
// ...然后修改下insert的代码
size_t index = HashFunc(koft(cur->_data))%newtables.size();并实现一下这个仿函数_Hash
struct _Hash
{
	const K& key operator()(const K& key)
	{
		return key;
	}
};然后单独对string做处理,我们可以把每个字符的ASCII进行相加后取模
struct _HashString
{
	size_t operator()(const string& key)
	{
		size_t hash = 0;
		for (size_t i = 0; i < key.size(); i++)
		{
			hash += key[i];
		}
		return hash;
	}
};
然后使用的时候不再使用默认,而是显式传入
void TestHashTable2()
{
	OPEN_HASH::HashTable<string, string, OPEN_HASH::KeyOfSet<string>,OPEN_HASH::_HashSring> ht;
	ht.insert("sort");
	ht.insert("string");
	ht.insert("left");
}实际上字符串哈希表有专门的哈希算法,可以尽可能的避免冲突.比如BKDR,SDBM.核心思路是
hash = hash*seed + key;seed是自己设置的一个种子.我们可以采取BKDR方法
struct _HashSring
{
	size_t operator()(const string& key)
	{
		size_t hash = 0;
		for (size_t i = 0; i < key.size(); i++)
		{
			hash *= 131;
			hash += key[i];
		}
		return hash;
	}
};实际上系统是默认支持string的,不需要自己手动传入哈希函数.因为string是经常被作为key的.我们可以让这个模板对string类进行特化模板
template<class K>
struct _Hash
{
	const K& operator()(const K& key)
	{
		return key;
	}
};
template<>
struct _Hash<string>
{
	size_t operator()(const string& key)
	{
		size_t hash = 0;
		for (size_t i = 0; i < key.size(); i++)
		{
			hash *= 131;
			hash += key[i];
		}
		return hash;
	}
};
Find
find的实现非常简单,只需要找到索引然后沿着链表查找即可
Node* Find(const K& key)
{
	KeyOfT koft;
	size_t index = HashFunc(key) % _tables.size();
	Node* cur = _tables[index];
	while (cur)
	{
		if (koft(cur->_data) == key)
			return cur;
		else
			cur = cur->_next;
	}
	return nullptr;
}
Erase
首先按find的逻辑去找这个目标结点,然后按照链表删除的方式去删除该节点.由于需要结点的前驱,所以不能直接调用find.
然后需要对结点类型进行分类讨论,如果删除的是头节点,还要单独处理
bool Erase(const K& key)
{
	KeyOfT koft;
	size_t index = HashFunc(key) % _tables.size();
	Node* cur = _tables[index];
	Node* prev = nullptr;
	while (cur)
	{
		if (koft(cur->_data) == key)
		{
			if (prev == nullptr)
			{
				_tables[index] = cur->_next;
			}
			else
			{
				prev->_next = cur->_next;
			}
			delete cur;
			return true;
		}
		else
		{
			cur = cur->_next;
			prev = cur;
		}
	}
	return false;
}
clear
用于清空容器的数据,实现的思路是遍历这个哈希表,依次对每个桶进行清空
void clear()
{
	for (size_t i = 0; i < _tables.size(); i++)
	{
		Node* cur = _tables[i];
		while (cur)
		{
			Node* next = cur->_next;
			delete cur;
			cur = next;
		}
		_tables[i] = nullptr;
	}
}然后我们就可以实现析构函数,实际上就是在调用clear
~HashTable()
{
	clear();
}
迭代器
哈希表的迭代器本质上还是一个结点指针.遍历一个哈希表的思路是首先找到第一个桶,然后遍历这个桶的所有结点.然后找到下一个桶继续遍历.
template<class K,class T,class KeyOfT>
struct __HashTableIterator
{
	typedef HashNode<T> Node;
	Node* node;
	__HashTableIterator(Node* node)
		:_node(node)
	{

	}
};然后是重载*和->
T& operator*()
{
	return _node->_data;
}
T* operator->()
{
	return &_node->_data;
}最主要的是operator++.如果该节点下一个不为空,就直接往下走.但是如果为空就要去找下一个桶.这个桶怎么找?
iterator operator++()
{
	if (_node->_next != nullptr)
	{
		_node = _node->_next;
	}
	else
	{
		//找下一个桶
	}
}要找桶我们只需要知道当前的值,然后利用哈希函数找到我在第几个桶.我们的迭代器内部需要能够访问这个哈希桶,所以在内部我们创建一个HT* pht,然后在哈希表创建迭代器的时候就把这张表传进来(this指针).同时在创建迭代器的时候可能会需要指定哈希函数,所以我们也添加一个Hash参数
template<class K,class T,class KeyOfT,class Hash>
struct __HashTableIterator
{
	typedef HashNode<T> Node;
	typedef __HashTableIterator<K, T, KeyOfT,Hash> Self;

	typedef HashTable<K, T, KeyOfT> HT
	Node* _node;
	HT* pht;
	__HashTableIterator(Node* node,HT* pht)
		:_node(node),_pht(pht)
	{

	}
	//...
}

//class HashTable()
typedef __HashTableIterator<K, T, KeyOfT,Hash> iterator;
iterator begin()
{
	for (size_t i = 0; i < _tables.size(); i++)
	{
		if (_tables[i])
		{
			return iterator(_tables[i],this);
		}
	}
	return end();
}
iterator end()
{
	return iterator(nullptr,this);
}需要注意的是目前编译器并不认识HashTable,因为HashTable在迭代器类的下方.所以我们还要在前面加上
template<class K,class T,class KeyOfT,class Hash>
class HashTable;
这个东西叫做前置声明
然后我们就可以计算当前的位置了.计算出当前位置,取下一个桶开始遍历跳过非空桶.如果能找到那就是下一个位置,就把_node赋值过去.
Self operator++()
{
	if (_node->_next != nullptr)
	{
		_node = _node->_next;
	}
	else
	{
		KeyOfT koft;
		size_t i = _pht->HashFunc(koft(_node->_data)) % _pht->_tables.size();
		i++;
		for (; i < _pht->_tables.size(); i++)
		{
			Node* cur = _pht->_tables[i];
			if (cur)
			{
				_node = cur;
				return *this;
			}
		}
		_node = nullptr;
		return *this;
	}
}由于在这里面需要对_tables进行访问,所以还要再HashTable里把它声明为友元类和对象.
class HashTable
{
	template<class K1, class T1, class KeyOfT1, class Hash1>
	friend struct __HashTableIterator;
	//...
}
既然迭代器已经实现了,我们就可以修改一下返回值
pair<iterator,bool> insert(const T& data)实际上在真实底层的实现中,迭代器的遍历是有序的.它的实现方式是在插入元素的同时用一个双链表顺序表和链表将所有插入的元素管理起来,并且在创建这个链表的时候保持有序.因此结点的定义还会多一个prev和next
struct HashNode
{
	T _data;
	HashNode<T>* _next;
	HashNode<T>* _linkNext;
	HashNode<T>* _linkPrev;
	HashNode(const T& data)
		:_data(data),_next(nullptr)
	{ }
};
如下图
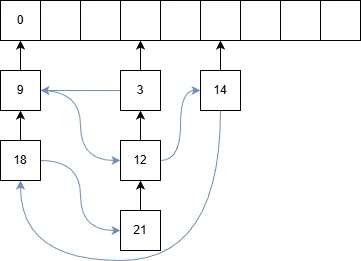
然后迭代器就顺着这个链表(蓝色)走就好
代码汇总
namespace OPEN_HASH
{
	//结点定义
	template<class T>
	struct HashNode
	{
		T _data;
		HashNode<T>* _next;
		HashNode(const T& data)
			:_data(data), _next(nullptr)
		{
		}
	};
	//仿函数定义
	template<class K>
		struct KeyOfSet
	{
		const K& operator()(const K& key)
		{
			return key;
		}
	};
	template<class K>
	struct _Hash
	{
		const K& operator()(const K& key)
		{
			return key;
		}
	};
	template<>
	struct _Hash<string>
	{
		size_t operator()(const string& key)
		{
			size_t hash = 0;
			for (size_t i = 0; i < key.size(); i++)
			{
				hash *= 131;
				hash += key[i];
			}
			return hash;
		}
	};
	//哈希迭代器
	template<class K,class T,class KeyOfT,class Hash>
	class HashTable;
	template<class K,class T,class KeyOfT,class Hash>
	struct __HashTableIterator
	{
		typedef HashNode<T> Node;
		typedef __HashTableIterator<K, T, KeyOfT,Hash> Self;
		typedef HashTable<K, T, KeyOfT,Hash> HT;
		Node* _node;
		HT* _pht;
		__HashTableIterator(Node* node,HT* pht)
			:_node(node),_pht(pht)
		{

		}
		T& operator*()
		{
			return _node->_data;
		}
		T* operator->()
		{
			return &_node->_data;
		}
		Self operator++()
		{
			if (_node->_next != nullptr)
			{
				_node = _node->_next;
			}
			else
			{
				KeyOfT koft;
				size_t i = _pht->HashFunc(koft(_node->_data)) % _pht->_tables.size();
				i++;
				for (; i < _pht->_tables.size(); i++)
				{
					Node* cur = _pht->_tables[i];
					if (cur)
					{
						_node = cur;
						return *this;
					}
				}
				_node = nullptr;
				return *this;
			}
		}
		bool operator!=(const Self& s)
		{
			return _node != s._node;
		}
	};

	//哈希表
	template<class K, class T, class KeyOfT, class Hash = _Hash<K>>
	class HashTable
	{
		typedef HashNode<T> Node;
		template<class K1, class T1, class KeyOfT1, class Hash1>
		friend struct __HashTableIterator;
	public:
		typedef __HashTableIterator<K, T, KeyOfT,Hash> iterator;
		iterator begin()
		{
			for (size_t i = 0; i < _tables.size(); i++)
			{
				if (_tables[i])
				{
					return iterator(_tables[i],this);
				}
			}
			return end();
		}
		iterator end()
		{
			return iterator(nullptr,this);
		}


		~HashTable()
		{
			clear();
		}
		void clear()
		{
			for (size_t i = 0; i < _tables.size(); i++)
			{
				Node* cur = _tables[i];
				while (cur)
				{
					Node* next = cur->_next;
					delete cur;
					cur = next;
				}
				_tables[i] = nullptr;
			}
		}
		pair<iterator,bool> insert(const T& data)
		{
			KeyOfT koft;
			//增容
			if (_tables.size() == _num)
			{
				vector<Node*> newtables;
				size_t newsize = _tables.size() == 0 ? 10 : 2 * _tables.size();
				newtables.resize(newsize);
				for (size_t i = 0; i < _tables.size(); i++)
				{
					Node* cur = _tables[i];
					while (cur)
					{
						Node* next = cur->_next;
						size_t index = HashFunc(koft(cur->_data)) % newtables.size();
						cur->_next = newtables[index];
						newtables[index] = cur;
						cur = next;
					}
					_tables[i] = nullptr;
				}
				swap(newtables, _tables);
			}
			size_t index = HashFunc(koft(data)) % _tables.size();
			Node* cur = _tables[index];
			while (cur)
			{
				if (koft(cur->_data) == koft(data))
					return make_pair(iterator(cur,this),false);
				else
					cur = cur->_next;
			}
			Node* newnode = new Node(data);
			newnode->_next = _tables[index];
			_tables[index] = newnode;
			_num++;
			return make_pair(iterator(newnode, this), true);
		}
		iterator Find(const K& key)
		{
			KeyOfT koft;
			size_t index = HashFunc(key) % _tables.size();
			Node* cur = _tables[index];
			while (cur)
			{
				if (koft(cur->_data) == key)
					return iterator(cur,this);
				else
					cur = cur->_next;
			}
			return this->end();
		}
		bool Erase(const K& key)
		{
			KeyOfT koft;
			size_t index = HashFunc(key) % _tables.size();
			Node* cur = _tables[index];
			Node* prev = nullptr;
			while (cur)
			{
				if (koft(cur->_data) == key)
				{
					if (prev == nullptr)
					{
						_tables[index] = cur->_next;
					}
					else
					{
						prev->_next = cur->_next;
					}
					delete cur;
					return true;
				}
				else
				{
					cur = cur->_next;
					prev = cur;
				}
			}
			return false;
		}
		size_t HashFunc(const K& key)
		{
			Hash hash;
			return hash(key);
		}
	private:
		vector<Node*> _tables;
		size_t _num;
	};
}
unordered set/map的模拟实现
首先定义结构,Map是kv模型,Set则只有key.但是如果我们传入的是个结构体就无法支持取模了,所以要加上仿函数
//map
template<class K,class V,class Hash = _Hash<K>>
class myUnorderedMap
{
	struct MapKOfT
	{
		const K& operator()(const pair<K, V>& kv)
		{
			return kv.first;
		}
	};
private:
	HashTable<K,pair<K,V>,MapKOfT,Hash> _ht
};

//set
template<class K,class Hash = _Hash<K>>
class myUnorderedSet
{
	struct SetKOfT
	{
		const K& operator()(const K& key)
		{
			return key;
		}
	};
private:
	HashTable<K,K,SetKOfT,Hash> _ht
};
然后分别实现迭代器
//Unordered_Set
typedef typename HashTable<K, K, SetKOfT, Hash>::iterator iterator;
iterator begin()
{
	return _ht.begin();
}
iterator end()
{
	return _ht.end();
}
bool insert(const K& key)
{
	return _ht.insert(key);
}

//Unordered_Map
typedef typename HashTable<K, pair<K,V>, MapKOfT, Hash>::iterator iterator;
iterator begin()
{
	return _ht.begin();
}
iterator end()
{
	return _ht.end();
}
bool insert(const pair<K, V>& kv)
{
	return _ht.insert(kv);
}之后是operator[]
//unordered_Set
K& operator[](const K& key)
{
	pair<iterator, bool> ret = _ht.insert(key);
	return *(ret.first);
}
//unordered_Map
V& operator[](const K& key)
{
	pair<iterator,bool> ret = _ht.insert(make_pair(key, V()));
	return ret.first->second;
}
哈希的应用
位图
给定40亿个不重复的无序无符号整形,如何快速判断某个数是否在里面.
在给定的整形数据中,在与不在是两种状态,我们可以用01进行编码,那么这40亿个数据的状态可以用40亿个位进行编码,一共占用500M的空间,远远由于直接将全部数据载入内存.这本质上是哈希直接定址法的思想.
像这样用位进行映射的方法就叫做位图.
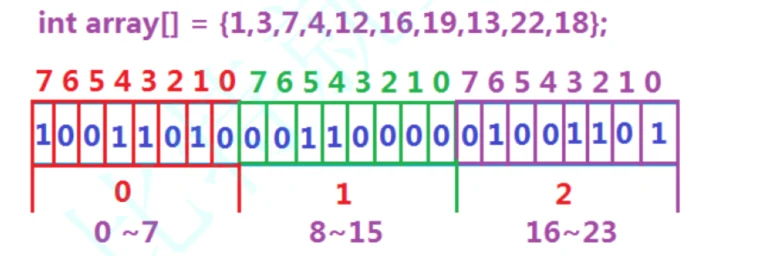
这种方法既节省了空间,又有较高的效率.位图的接口如下
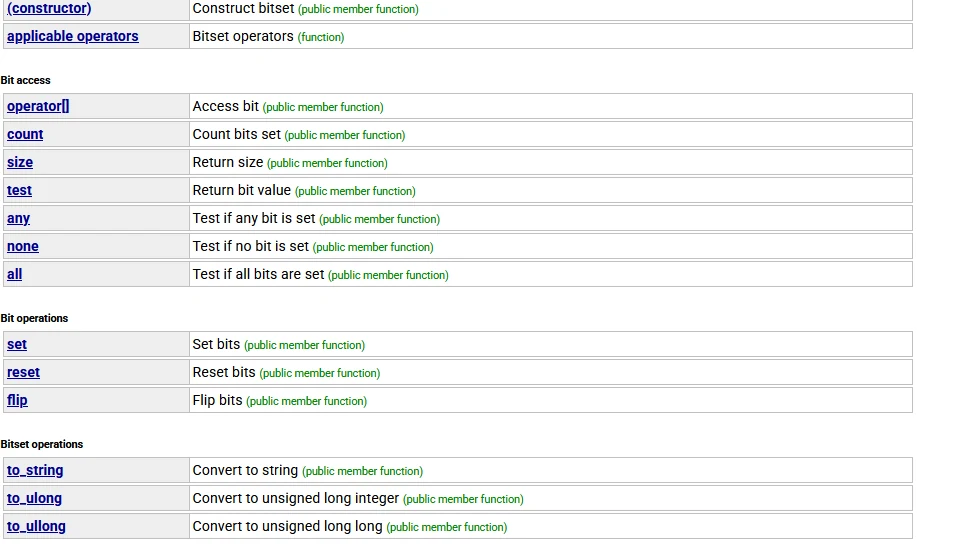
它的定义规则为
bitset<[len]> bs([init_data])比如
bitset<8> bs(5)表示定义一个8位的位图,初始化为5(00000101).
test定义为
bool test (size_t pos) const;返回pos位置是否为1.
set表示置位
bitset& set();
bitset& set (size_t pos, bool val = true);不传参数则全部置为1,传入pos则是把pos位置置为val.reset则与其相同,只不过是置为0
flip表示取反,同样的,可以全部翻转或者取某一位进行翻转
bitset& flip();
bitset& flip (size_t pos);
接下来我们来模拟实现一下位图
class bitset
{
public:
	bitset(size_t N)
	{
		_bits.resize(N,0);
		_num = 0;
	}
private:
	vector<int> _bits;
	size_t _num;
};
如果用数组去模拟实现,我们开辟的是整形,这样位图就失去意义了.一个整形是32位,所以我们可以这样
class bitset
{
public:
	bitset(size_t N)
	{
		_bits.resize(N/32+1,0);
		_num = 0;
	}
private:
	vector<int> _bits;
	size_t _num;
};然后是set,实际上就是把对应的位置置位.我们要做的是先去计算pos所在的整形,然后再算出pos在该整形的第几个位,并利用或运算进行置位
void set(size_t pos)
{
	size_t index = pos / 32;
	size_t j = pos % 32;
	_bits[index] |= (1 << j);
}同样可以实现reset
void reset(size_t pos)
{
	size_t index = pos / 32;
	size_t j = pos % 32;
	_bits[index] &= ~(1 << j);
}然后是test,用来判断某位是否为1.
bool test(size_t pos)
{
	size_t index = pos / 32;
	size_t j = pos % 32;
	return _bits[index] & (1 << j);
}我们用一个只有pos位置为1的数据去和_bits[index]相与,如果该位置为1那结果就不是0,对应布尔值为true,否则为false.
布隆过滤器
我们在使用新闻客户端看新闻时,它会给我们不停地推荐新的内容,它每次推荐时要去重,去掉那些已经看过的内容.问题来了,新闻客户端推荐系统如何实现推送去重的?用服务器记录了用户看过的所有历史记录,当推荐系统推荐新闻时会从每个用户的历史记录里进行筛选,过滤掉那些已经存在的记录.如何快速查找呢?在实际情况下,推荐的有可能是已经看过的内容,但是绝大部分情况下都是没看过的.
我们如果使用哈希表就会非常浪费空间,用位图的话只能处理整形,为了解决这个问题,就引入了布隆过滤器.
它本质上来说也是位图,只不过是利用字符串哈希算法把字符串转为了整形,然后按照位图的方式进行处理.但是会存在哈希冲突的问题.不同的字符串映射到了相同的位置就会导致误判.而且由于位图使用的是直接定址,这个问题解决不了.因此我们只能想办法降低误判的概率.
布隆过滤器的思路是:一个值映射一个位置容易误判,那一个值映射多个就没那么容易误判了
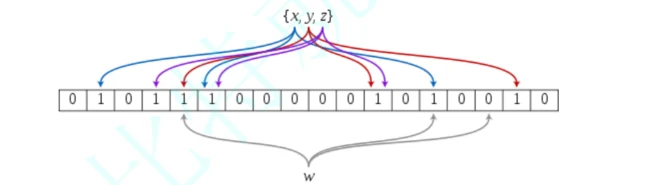
但是一个值映射多个位置意味着占用的空间也会变多.接下来我们来实现一个布隆过滤器.布隆过滤器的底层实际上就是一个位图.我们传入一个数据类型,一个大小,三个哈希函数用于计算一个元素的下标
template <size_t N, class K = string, class H1 = Hash1, class H2 = Hash2, class H3 = Hash3>
class bloomFilter
{
public:

private:
	bitset<N> _bs;
};然后分别实现set(即将元素插入位图)和test(判断某元素是否在位图中).实际上就是用哈希函数算出对应值的下标,去判断下标是否为1
void set(const K& key)
{
    H1 hash1;
    H2 hash2;
    H3 hash3;
    size_t index1 = hash1(key) % N;
    size_t index2 = hash2(key) % N;
    size_t index3 = hash3(key) % N;

    _bs.set(index1);
    _bs.set(index2);
    _bs.set(index3);
}
bool test(const K& key)
{
    H1 hash1;
    H2 hash2;
    H3 hash3;

    size_t index1 = hash1(key) % N;
    size_t index2 = hash2(key) % N;
    size_t index3 = hash3(key) % N;

    return _bs.test(index1) && _bs.test(index2) && _bs.test(index3);
}需要注意的是test不一定能够准确判断,只能降低误判的概率.对于位图而言,常见的元素内容是string.
值得注意的是,布隆过滤器是不允许删除的,因为一旦删除一个元素把对应位置置0就可能导致误删.如果要支持删除,就要给每个比特位加上一个计数器,这样又失去了使用布隆过滤器位操作的优势.
海量数据处理
1.给定100亿个整数,怎么找出只出现一次的整数?
如果使用传统哈希,内存是不够的.我们考虑使用位图.数据一共有三种可能:没有出现,只出现1次,和出现两次及以上的.也就是说我们这里需要3种状态,共需要两个位来进行标识.
- 出现0次-
00 - 出现1次-
01 - 出现两次及以上-
10
这样我们只需要稍微修改一下我们的代码.原来是一个int32位,每位对应一个数据,现在变成两位一个数据,所以
size_t index = pos / 32;
size_t j = pos % 32;
改为
size_t index = pos / 16;
size_t j = pos % 16;然后不能直接_bits[index] |= (1 << j);,而是要判断原来是00还是01还是10.
还有另一种方案,我们基于原有的位图进行封装,我们定义两个位图,一个位图标识一个位
class solution
{
public:
	void set(size_t x)
	{
		if(_bs1.test(x) == 0 && _bs2.test(x) == 0)
		{
			_bs2.set(x);
		}//00->01
		else if(_bs1.test(x) == 0 && _bs2.test(x) == 1)
		{
			_bs1.set(x);
			_bs2.reset(x);
		}//01->10
	}
private:
	bitset<N> _bs1;
	bitset<N> _bs2;
}
2.给两个文件,分别有100亿个整数,只有1G内存,如何找到两个文件交集
思路:将其中一个文件存入位图,去读取另一个文件的整数,去判断是否在位图中.虽然有100亿个整数,但是int的范围就是42亿.说明里面一定有大量重复.无论他有多少,我们的位图就开42亿位.这样内存消耗就是500M
3.一个文件有100亿个int,有1G内存,设计算法找出次数不超过2的所有整数
现在有这几种情况:出现0次,出现1次,出现2次,出现2次以上.一共有4种情况,刚好可以使用2位进行编码.所以和第一题一样
4.给两个文件,分别有100亿个query,我们只有1G内存,如何找到两个文件交集?给出精确算法和近似算法
方案1:将query映射到一个布隆过滤器中,读取文件2的query,判断在不在布隆过滤器中.它的缺陷在于会出现找出的交集可能不是真正的交集的情况,存在误判.
方案2:我们给出一个精确方案:
既然文件那么大,我们就可以把文件进行切割,这样它就可以加载入内存.切出来的文件去和另外一个切出来的文件进行比较找出交集
那么应该切多少份?一般来说切的文件不能太小,否则比较次数会非常多.只需要保证切出来的文件能放入内存即可.
为了提高效率,我们可以把切割出来的A文件存入set,利用搜索树去进行比较.
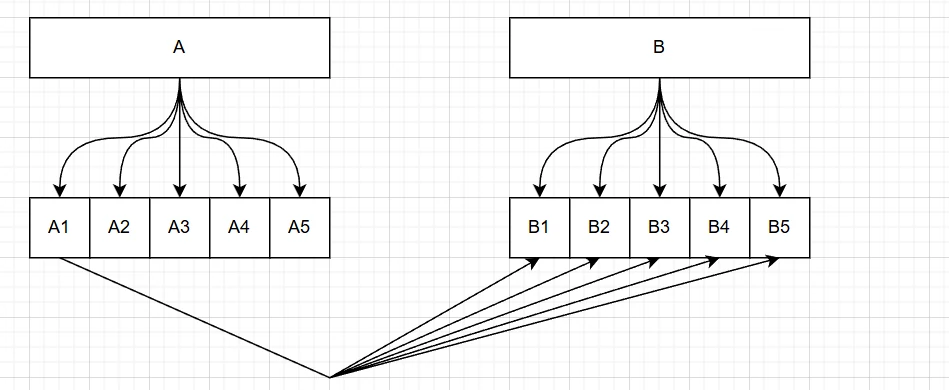
实际上还能继续优化.我们之前的切割是平均切分,现在我们采取哈希切分.它的处理思路是利用字符串哈希函数把query修改为整形,然后模上1000得到i,根据i的数据把它存入Ai.
i = hashstr(query_a)%1000;
A[i] = query_a;同样的,B也这样处理,然后只需要A[i]和B[i]一一进行比较即可
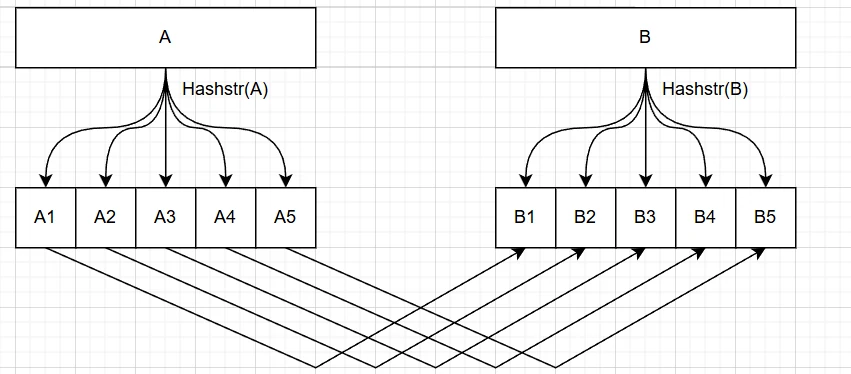
利用哈希分割,我们把哈希值%1000的分到了一组.哈希值%1000不相同的数据一定不可能是相同的数据,这样只需要比较下标相同的两个小文件即可.(1000是分割出的文件的个数).
5.如何让布隆过滤器支持删除
让布隆过滤器每个位变成计数器,但是问题在于应该几个位为一组去作为计数器?如果位数太小就会溢出,多了就浪费太多空间.一般来说用两个字节去做.
6.给一个超过100G的log file,log中存在IP地址,设计算法找出出现次数最多的IP地址.以及如何找出出现次数top K的IP
首先创建1000个小文件,然后读取IP,并对IP进行哈希分割以保证相同IP进入同一个子文件.然后每个文件使用map二叉树对IP出现的次数进行统计,并记录出现次数最多的IP.依次统计每一个子文件,并更新记录,这样就能获得出现次数最多的IP.
如果要找topK,那么就用一个堆树进行统计
一致性哈希
上面的海量数据是指内存存不下的数据,那假设我们要存储的是一整个公司的数据,这样的数据量是非常巨大的.并且数据的管理还要保持高效.那么这样的数据应该怎么存储?这些数据空间的使用量大概在万T级别.
对于单机存储,使用的是数据库,其底层往往使用b树进行.但是这样的数据量一定是使用多机存储的,同时还要满足增删查改的需求.这样的服务器就叫做分布式服务器.
现在,我们要找一个用户的数据,我们应该在哪一台服务器上进行查找?我们假设对每一台机器进行编号,然后将用户数据与机器的编号建立映射关系,比较简单的方法就是
\[index = Hash(Data)\%num\]
在实际的使用中,有一台专门的机器来管理所有服务器的编号和IP.
但是这个方案是有问题的.随着用户量的增长,服务器的数量也就要对应增长这就导致num变了,原来的索引就失效了.而对这么多的数据进行重新索引成本是极其巨大的.为了解决这个问题,就提出了一致性哈希.它的改动是
\[index = Hash(Data)\%2^{32}\]
实际上这个数据是多少都行,只是它取的是整形的最大值,因为一般来说服务器数量也到不了那么大.那问题来了,我只有10台服务器,算出来的index>10怎么办呢?
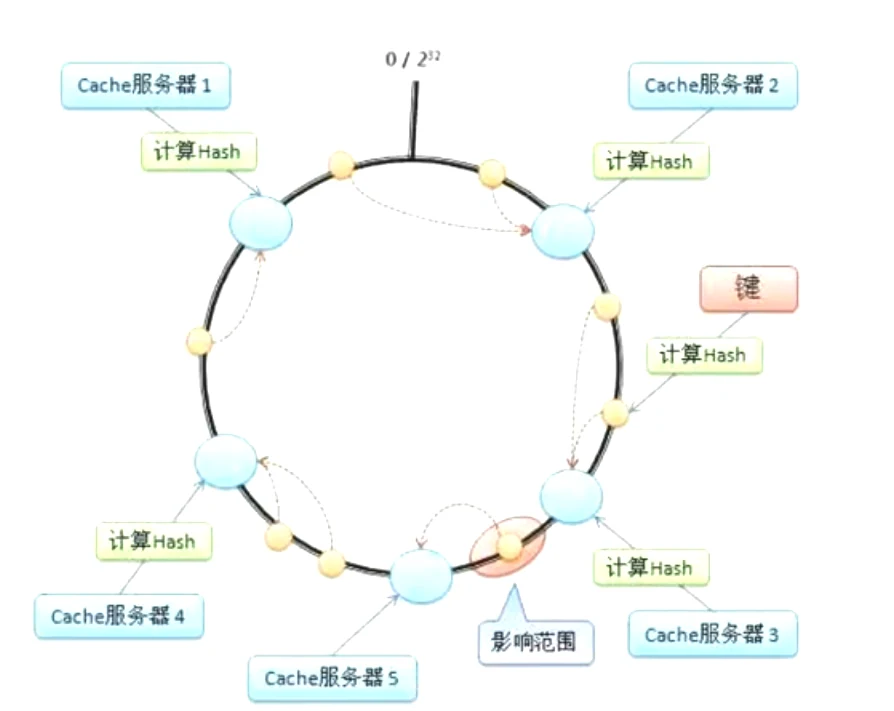
它的解决方案是利用范围取进行映射,index的范围是0~2^32,我把这段范围均分给10台机器,如果我要增加机器,就不再需要全部进行迁移,而是只需要迁移部分负载重的机器上的数据.比如在一个数据范围内映射了某一台机器,这台机器数据量比较大.现在我新增了5台机器,我就把该机器对应的范围拆分给新增的5台,然后把原来那一台机器上的数据一部分迁移到这5台新服务器中.
哈希加密
#补充 本质上是数学的密码学方向