二叉搜索树
二叉搜索树(BST)本质是一棵二叉树,但是需要满足
- 非空左子树的所有键值小于其根结点的键值。
- 非空右子树的所有键值大于其根结点的键值。
- 左、右子树都是二叉搜索树。
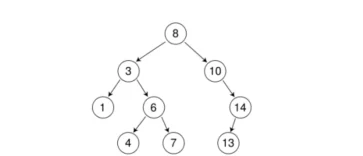
这样的结构非常适合来做搜索,比如我要搜索6,根节点是8,所以6一定在根节点的左树,左树跟结点为3,所以6一定在该节点右子树,于是就找到了.
对于一棵二叉搜索树,任何一个根节点始终满足左孩子<根<右孩子,所以对这棵树进行中序遍历得到的结果是有序的.
二叉搜索树的实现
二叉搜索树的定义
首先定义结点,二叉树结点有左右孩子和数值,所以定义为
template <class K>
struct BTreeNode
{
	BTreeNode<K>* _left;
	BTreeNode<K>* _right;
	K _key;
	BTreeNode(const K& key)
	:_left(nullptr),_right(nullptr),_key(key)
	{}
};由于结点需要new,所以还需要创建构造函数
然后创建一个二叉搜索树类
template <class K>
class BSTree
{
	typedef BTreeNode<K> Node;
public:

private:
	Node* _root=nullptr;
};
插入
首先要编写的接口是Insert,一个数据来了之后,要如何插入BST.作为一棵搜索二叉树,是不能插入已经存在的值的,所以如果该值已经存在,就返回False.假设现在已经有了一棵搜索二叉树,现在要插入一个值.如果树是一棵空树,我们就创建一个新节点,如果不是,它如果比根节点小,就去左子树找,比根节点大就去右子树找,如果一样就说明已经存在,返回False.
bool Insert(const K& key)
{
	if (_root == nullptr)
	{
		_root = new Node(key);
		return true;
	}
	Node *cur = _root;
	Node* prev = cur;
	while (cur)
	{
		if (cur->_key < key)
		{
			prev = cur;
			cur = cur->_right;
		}
		else if(cur->_key > key)
		{
			prev = cur;
			cur = cur->_left;
		}
		else
		{
			return false;
		}
	}
	cur = new Node(key);
	//把结点连起来
	if (prev->_key > key)
	{
		prev->_left = cur;
	}
	else
	{
		prev->_right = cur;
	}
	return true;
}
遍历
然后来编写中序遍历
void InOrder(Node* root)
{
	if (root == nullptr)
	{
		return;
	}
	InOrder(root->_left);
	cout << root->_key << " ";
	InOrder(root->_right);
}
看似没啥问题,然鹅当调用的时候
t.InOrder();这个参数咋办?所以这里更好的方案是写一个子函数
void _InOrder(Node* root)
{
	if (root == nullptr)
	{
		return;
	}
	_InOrder(root->_left);
	cout << root->_key << " ";
	_InOrder(root->_right);
}
void InOrder()
{
	_InOrder(_root);
}因为最大的问题是在类外根本访问不到_root.
查找
然后是查找Find,和插入是类似的思路
bool Find(const K& key)
{
	Node* cur = _root;
	while (cur)
	{
		if (key > cur->_key)
		{
			cur = cur->_right;
		}
		else if (key < cur->_key)
		{
			cur = cur->_left
		}
		else
		{
			return true;
		}
	}
	return false;
}
删除
然后是删除,BST删除一个结点后依然要保证剩下的树是一棵BST,
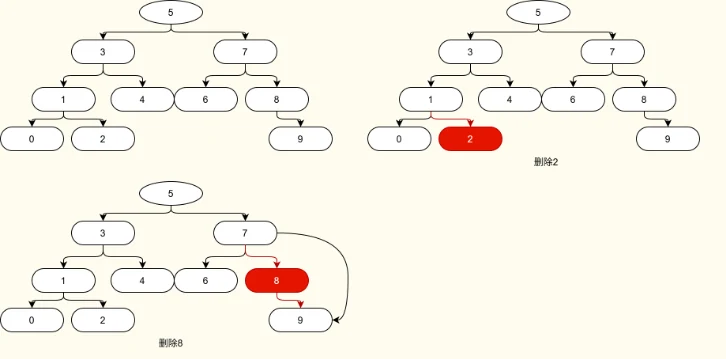
如果目标节点只有一个孩子或者没有孩子是非常好处理的,直接让父节点接上就可以.但是如果我要删的结点有两个孩子该怎么办,比如5,3这类的.
这个时候不能直接删除而是使用替换法.比如我们要删5,我们需要找一个能够放到5位置的数.这个数要满足比左孩子及左树所有节点大,比右孩子及右树所有结点小,所以就是左树的最大结点和右树的最小结点.而左子树和右子树都是BST,所以左子树的最大结点实际上就是左树的最右结点,右子树的最小结点实际上就是右树的最小结点.
所以首先找到目标结点和目标结点的前驱
while (cur != nullptr)
{
	if (cur->_key > key)
	{
		prev = cur;
		cur = cur->_left;
	}
	else if (cur->_key < key)
	{
		prev = cur;
		cur = cur->_right;
	}
	else
	{
		//找到了,开始删除
	}
}删除的时候又要分为三种情况:cur的左为空,右为空和左右都不为空,同时还需要确定cur是prev的左孩子还是右孩子
if (cur->_left == nullptr)
{
	if (prev->_left == cur)
	{
		prev->_left = cur->_right;
	}
	else
	{
		prev->_right = cur->_right;
	}
	delete cur;
	cur = nullptr;
}
else if (cur->_right == nullptr)
{
	if (prev->_left == cur)
	{
		prev->_left = cur->_left;
	}
	else
	{
		prev->_right = cur->_left;
	}
	delete cur;
	cur = nullptr;
}
else
{

}
最后来处理左右都不为空的情况,我们需要找左子树的最大结点(即最右结点)或右子树的最小结点(即最左结点)去代替该节点.我们以右子树的最左结点为例
Node *rightMin = cur->_right;
Node *rightMinPrev = cur;
while (rightMin->_left != nullptr)
{
	rightMinPrev = rightMin;
	rightMin = rightMin->_left;
}
cur->_key = rightMin->_key;
rightMinPrev->_left = rightMin->_right;
delete rightMin;
rightMin = nullptr;
这样就完成了吗?并不对,如果我一上来就删除7
程序就出现问题了,因为
rightMinPrev->_left = rightMin->_right;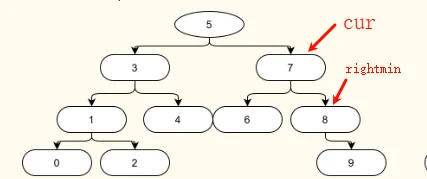
因为现在指向的rightMin是父亲的右孩子,而之前一直往左找,我们默认了找到的结点是父亲的左孩子,这是不合理的,所以我们需要做额外判断.
if (rightMin == rightMinPrev->_left)
{
	rightMinPrev->_left = rightMin->_right;
}
else
{
	rightMinPrev->_right = rightMin->_right;
}
还有问题,如果左子树被删完了,变成了
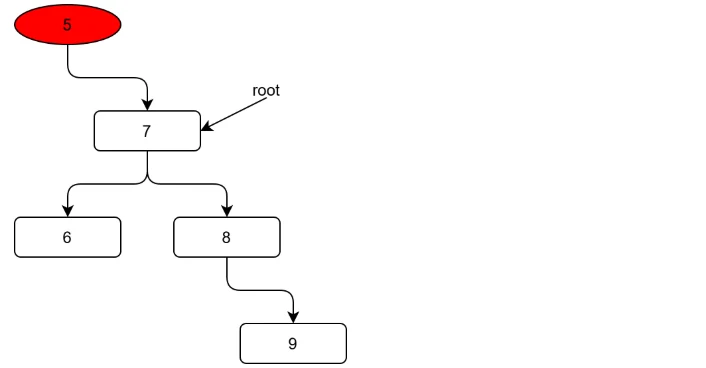
此时如果要删除5结点,原来的代码就错了,这个时候删除的方式应该是直接把根节点替换为7,然后删除5
if (cur->_left == nullptr)
{
	if (cur == _root)
	{
		_root = cur->_right;
	}
	else
	{
		if (prev->_left == cur)
		{
			prev->_left = cur->_right;
		}
		else
		{
			prev->_right = cur->_right;
		}
	}
	delete cur;
	cur = nullptr;
}
else if (cur->_right == nullptr)
{
	if (cur == _root)
	{
		_root = cur->_right;
	}
	else
	{
		if (prev->_left == cur)
		{
			prev->_left = cur->_left;
		}
		else
		{
			prev->_right = cur->_left;
		}
	}
	delete cur;
	cur = nullptr;
}
所以最终代码为
bool erase(const K& key)
{
	Node *cur = _root;
	Node *prev = cur;
	while (cur != nullptr)
	{
		if (cur->_key > key)
		{
			prev = cur;
			cur = cur->_left;
		}
		else if (cur->_key < key)
		{
			prev = cur;
			cur = cur->_right;
		}
		else
		{
			//找到了,开始删除
			if (cur->_left == nullptr)
			{
				if (cur == _root)
				{
					_root = cur->_right;
				}
				else
				{
					if (prev->_left == cur)
					{
						prev->_left = cur->_right;
					}
					else
					{
						prev->_right = cur->_right;
					}
				}
				delete cur;
				cur = nullptr;
			}
			else if (cur->_right == nullptr)
			{
				if (cur == _root)
				{
					_root = cur->_right;
				}
				else
				{
					if (prev->_left == cur)
					{
						prev->_left = cur->_left;
					}
					else
					{
						prev->_right = cur->_left;
					}
				}
				delete cur;
				cur = nullptr;
			}
			else
			{
				Node *rightMin = cur->_right;
				Node *rightMinPrev = cur;
				while (rightMin->_left != nullptr)
				{
					rightMinPrev = rightMin;
					rightMin = rightMin->_left;
				}
				cur->_key = rightMin->_key;
				if (rightMin == rightMinPrev->_left)
				{
					rightMinPrev->_left = rightMin->_right;
				}
				else
				{
					rightMinPrev->_right = rightMin->_right;
				}
				delete rightMin;
				rightMin = nullptr;
			}
			return true;
		}
	}
	return false;
}现在有了增删查,但是没有”改”.原因是二叉搜索树的key应当是不允许被修改的,一旦修改受,搜索树的结构就被破坏了.但是key对应的value是允许修改的
二叉搜索树的应用
- K模型:只有key作为关键码,判断key是否存在于二叉搜索树
- Key/Value模型:通过key去检索value,即python速成.
利用搜索树不再需要挨个遍历,所以效率非常高.
我们以KV模型为例,既然引入了Key和Value,我们的结点定义就要多加上Value的定义
struct BTreeNode
{
	K _key;
	V _value;
	BTreeNode<K,V>* _left;
	BTreeNode<K,V>* _right;
	BTreeNode(const K& key, const V& value)
		:_left(nullptr),_right(nullptr),_key(key),_value(value)
	{

	}
};那么多引入了一个变量,我们的插入需要更改,创造结点的时候连value一起构造
bool Insert(const K& key,const V& value)
{
	if (_root == nullptr)
	{
		_root = new Node(key,value);//原来是new Node(key)
		return true;
	}
	Node *cur = _root;
	Node* prev = cur;
	while (cur)
	{
		if (cur->_key < key)
		{
			prev = cur;
			cur = cur->_right;
		}
		else if(cur->_key > key)
		{
			prev = cur;
			cur = cur->_left;
		}
		else
		{
			return false;
		}
	}
	cur = new Node(key,value);
	if (prev->_key > key)
	{
		prev->_left = cur;
	}
	else
	{
		prev->_right = cur;
	}
	return true;
}查找的时候也不能返回bool了,而是返回目标结点
Node* Find(const K& key)
{
	Node* cur = _root;
	while (cur)
	{
		if (key > cur->_key)
		{
			cur = cur->_right;
		}
		else if (key < cur->_key)
		{
			cur = cur->_left;
		}
		else
		{
			return cur;
		}
	}
	return nullptr;
}
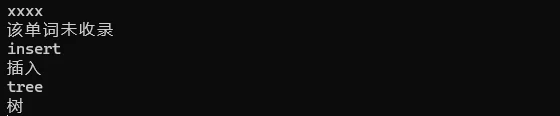
现在我们利用KV模型写一个简单的中英互译
void translate()
{
	BSTree<string, string> dic;
	dic.Insert("sort","排序");
	dic.Insert("string","字符串");
	dic.Insert("vector","线性表");
	dic.Insert("list","列表");
	dic.Insert("tree","树");
	dic.Insert("insert","插入");
	string str;
	while (cin >> str)
	{
		BTreeNode<string, string>* ret = dic.Find(str);
		if (ret)
		{
			cout << ret->_value << endl;
		}
		else
		{
			cout << "该单词未收录" << endl;
		}
	}
}
再比如,现在我想确定某个字符串在该数组中出现了多少次,我们依然可以用二叉搜索树来解决
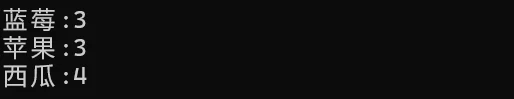
string strArr[] = { "西瓜","苹果","蓝莓","西瓜","苹果","西瓜", "西瓜","苹果","蓝莓","蓝莓"};我要查找每种水果出现几次,我们可以这样做.首先创建一棵二叉搜索树,类型为BSTree<string, int>.遍历这个数组,并依次查找这个水果是不是第一次出现.如果是第一次出现,就让他插入,数值改为1.如果不是,那么就对应水果的数值+1.这样在遍历完成后,所有的水果都进了二叉搜索树,并且次数随之进行了统计
void Times()
{
	string strArr[] = { "西瓜","苹果","蓝莓","西瓜","苹果","西瓜", "西瓜","苹果","蓝莓","蓝莓"};
	BSTree<string, int> countTrees;
	for (auto str : strArr)
	{
		BTreeNode<string, int>* ret = countTrees.Find(str);
		if (ret == nullptr)
		{
			countTrees.Insert(str,1);
		}
		else
		{
			ret->_value++;
		}
	}
}
二叉搜索树的性能分析
一般来说,二叉搜索树的性能还是很不错的,它让搜索不再是单纯的暴力搜索.正常情况下,搜索的复杂度就是O(logN).但是如果插入的数据是有序的,或者说是接近有序的,那么搜索树的效率就完全没办法保证了.
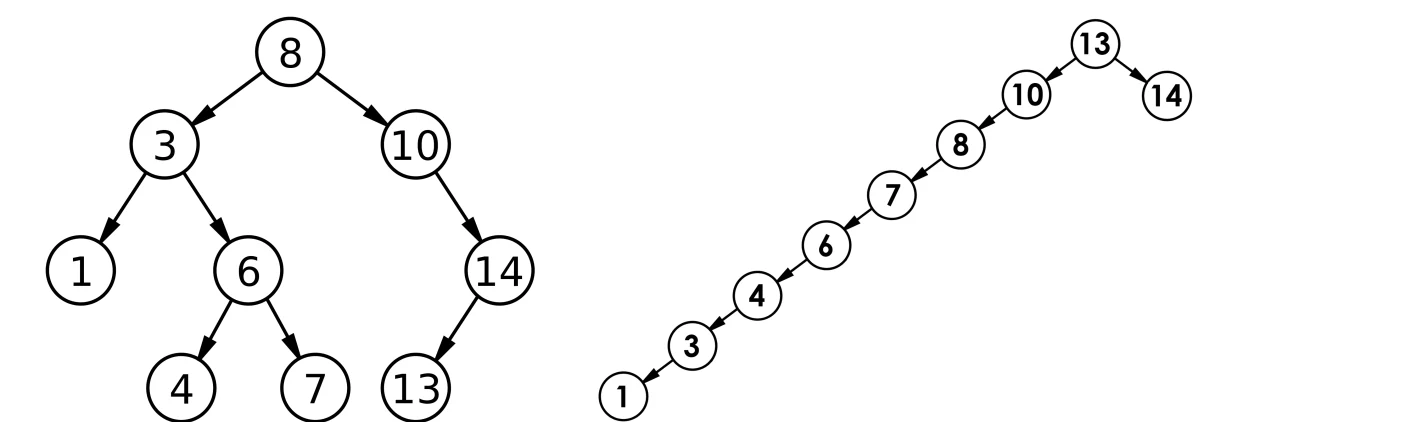
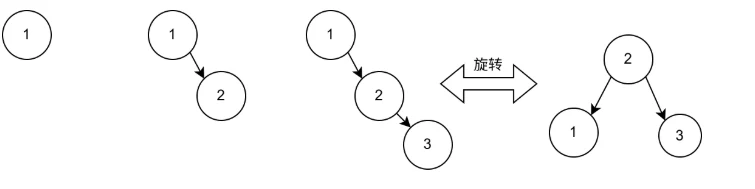
此时效率就是O(N)了.那么如何解决?造成这样问题的原因是一棵树的分支远远长于另一个分支,如果让它变得”平衡”一些,效率就不会下降到O(N).这就是我们后面要说的AVL树和红黑树.大概解决思路是利用旋转让树的两边尽可能保持平衡
练习
二叉树创建字符串
给你二叉树的根节点 root ,请你采用前序遍历的方式,将二叉树转化为一个由括号和整数组成的字符串,返回构造出的字符串。
空节点使用一对空括号对 "()" 表示,转化后需要省略所有不影响字符串与原始二叉树之间的一对一映射关系的空括号对。
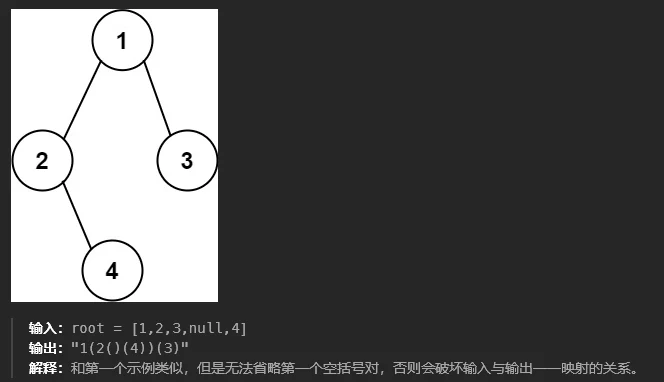
思路:我们用一个str来存储每一层新增的内容,并对其进行返回.如果到达根节点,就返回.每个结点要做的事情是:
- 存储当前结点的值
- 向左遍历
- 向右遍历
str += to_string(root->val);
if(root->left)
{
	str += "(";
	str += tree2str(root->left);
	str += ")";
}
else if(root->right)
{
	str += "()";
}
if(root->right)
{
	str += "(";
	str += tree2str(root->right);
	str += ")";
}注意特殊情况:当左为空,右不为空的时候,将字符串加上一个();
完整代码如下:
class Solution {
public:
    string tree2str(TreeNode* root) {
        string str;
        if(root == nullptr)
            return str;
        str += to_string(root->val);
        if(root->left)
        {
            str += "(";
            str += tree2str(root->left);
            str += ")";
        }
        else if(root->right)
        {
            str += "()";
        }
        if(root->right)
        {
            str += "(";
            str += tree2str(root->right);
            str += ")";
        }
        return str;
    }
};
二叉树的层序遍历
给你二叉树的根节点 root ,返回其节点值的 层序遍历 。 (即逐层地,从左到右访问所有节点)。
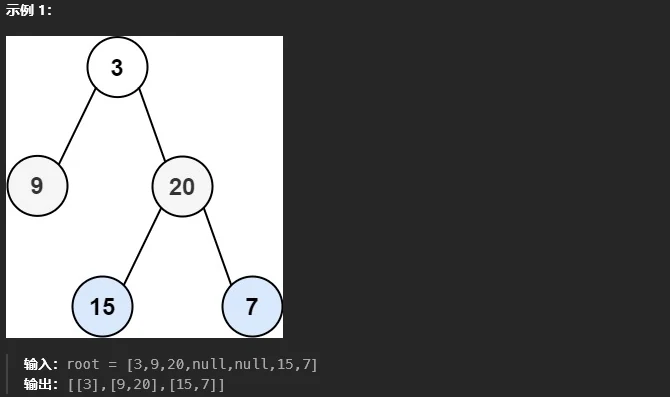
原理:层序遍历的思路已经讲过,利用队列,根节点进队列,带它的左右孩子进队列,然后根节点出队列,依次往下.
首先我们完成层序遍历
vector<vector<int>> levelOrder(TreeNode* root) {
	vector<vector<int>> vv;
	queue<TreeNode*> q;
	if(root)
	{
		q.push(root);
	}
	while(!q.empty())
	{
		TreeNode *front=q.front();
		q.pop();
		cout<<front->val<<" ";
		if(front->left) q.push(front->left);
		if(front->right) q.push(front->right);
	}
	return vv;
}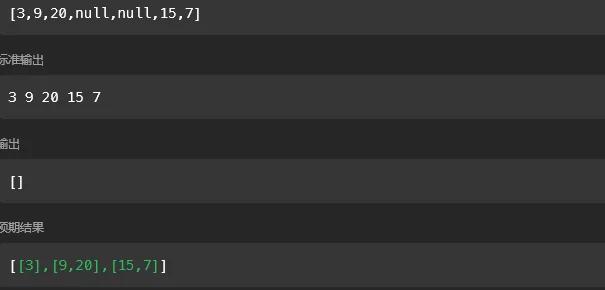
现在输出没啥问题,但是怎么做到分层输出呢?我们可以再给出一个队列,每入一个queue就在leveq里面记录这个数据的层数.另一个思路则是利用循环进行控制,第一层出完第二层也就入完了.第二层出完第三层也就入完了,所以我们可以用循环控制,一层一层的出.这样q.size()就是n+1层的数据个数.循环再继续处理.
class Solution {
public:
    vector<vector<int>> levelOrder(TreeNode* root) {
        vector<vector<int>> vv;
        queue<TreeNode*> q;
        if(root)
        {
            q.push(root);
        }
        while(!q.empty())
        {
            int leveSize = q.size();
            vector<int> content;
            for(size_t i=0;i<leveSize;i++)
            {
                TreeNode *front=q.front();
                content.push_back(front->val);
                q.pop();
                if(front->left) q.push(front->left);
                if(front->right) q.push(front->right);
            }
            vv.push_back(content);
        }
        return vv;
    }
};
二叉树的层序遍历II
给你二叉树的根节点 root ,返回其节点值 自底向上的层序遍历 。 (即按从叶子节点所在层到根节点所在的层,逐层从左向右遍历)
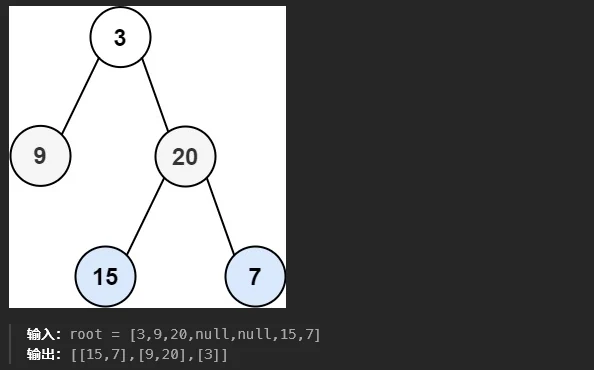
思路:简单粗暴,把上一道题做一个reverse即可
reverse(vv.begin(),vv.end());class Solution {
public:
vector<vector<int>> levelOrderBottom(TreeNode* root) {
vector<vector<int>> vv;
queue<TreeNode*> q;
if(root)
{
q.push(root);
}
while(!q.empty())
{
int leveSize = q.size();
vector<int> content;
for(size_t i=0;i<leveSize;i++)
{
TreeNode *front=q.front();
content.push_back(front->val);
q.pop();
if(front->left) q.push(front->left);
if(front->right) q.push(front->right);
}
vv.push_back(content);
}
reverse(vv.begin(),vv.end());
return vv;
}
};二叉树的最近公共祖先
给定一个二叉树, 找到该树中两个指定节点的最近公共祖先。
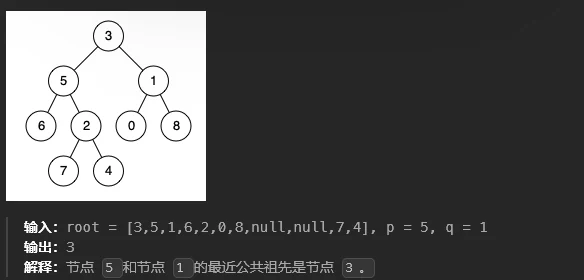
注意:公共祖先可以是结点本身,比如5和4的公共祖先是5.
我们先来考虑两个结点p和q的公共祖先满足的特征
- p是q的孩子,则q是共同祖先
- p和q分别是某一个结点左右子树中的结点,则该节点是共同祖先
我们的思路是:
如果这个树是一棵二叉搜索树,只需要对比结点的数值和根的数值,依次比较即可
- 如果两个结点一个比根小,一个比根大,那么根就是最近祖先
- 如果都比根小/大,就往对应方向递归查找祖先.
如果这个树是三叉链树,直接让两个结点沿着分支往上走,去找两个结点的交点.类似于顺序表和链表.
如果只是一棵普通二叉树
- 一个在左子树,一个在右子树,则根结点就是祖先.
- 如果都在左树/右树,则递归到对应树中查找.
本题确定了这是一棵二叉树.函数定义为
TreeNode* lowestCommonAncestor(TreeNode* root, TreeNode* p, TreeNode* q)先考虑特殊情况
if(root == nullptr)
{
	return nullptr;
}
if(root == p || root == q)
{
	return root;
}然后我们要判断p,q分别在什么位置.所以我们可以写一个Find函数,去左右子树进行查找
bool pInLeft,pInRight,qInLeft,qInRight;
pInLeft = Find(root->left,p);
pInRight = !pInLeft;
qInLeft = Find(root->left,q);
qInRight = !qInLeft;然后再分类讨论.如果p,q在两边,那么根节点就是最近的公共祖先.
if((pInLeft&&qInRight)||(pInRight&&qInLeft))
{
	return root;
}如果p,q在同侧,就往对应侧递归.
if(pInLeft && qInLeft)
{
	return lowestCommonAncestor(root->left,p,q);
}
if(pInRight && qInRight)
{
	return lowestCommonAncestor(root->right,p,q);
}
return nullptr;最后只差一个Find函数
bool Find(TreeNode* root,TreeNode* target)
{
	if(root == nullptr)
		return false;
	return root==target || Find(root->left,target) || Find(root->right,target);
}
于是完整代码为
class Solution {
public:
    bool Find(TreeNode* root,TreeNode* target)
    {
        if(root == nullptr)
            return false;
        return root==target || Find(root->left,target) || Find(root->right,target);
    }
    TreeNode* lowestCommonAncestor(TreeNode* root, TreeNode* p, TreeNode* q) {
        if(root == nullptr)
        {
            return nullptr;
        }
        if(root == p || root == q)
        {
            return root;
        }
        bool pInLeft,pInRight,qInLeft,qInRight;
        pInLeft = Find(root->left,p);
        pInRight = !pInLeft;
        qInLeft = Find(root->left,q);
        qInRight = !qInLeft;
        if((pInLeft&&qInRight)||(pInRight&&qInLeft))
        {
            return root;
        }
        if(pInLeft && qInLeft)
        {
            return lowestCommonAncestor(root->left,p,q);
        }
        if(pInRight && qInRight)
        {
            return lowestCommonAncestor(root->right,p,q);
        }
        return nullptr;
    }
};
实际上这是两层深搜的嵌套,复杂度有\(O(N^2)\).实际上一层深搜就能搞定.
class Solution {
public:
    TreeNode* lowestCommonAncestor(TreeNode* root, TreeNode* p, TreeNode* q) {
        if(root == p || root == q || root == nullptr)
        {
            return root;
        }
        TreeNode* left = lowestCommonAncestor(root->left,p,q);
        TreeNode* right = lowestCommonAncestor(root->right,p,q);
        if(left == nullptr) return right;
        if(right == nullptr) return left;
        return root;
    }
};按照递归,搜索,回溯算法的思路,我坚信这个函数可以帮助我找到p,q的最近公共祖先.所以我先往左找p,q的公共祖先,得到left,然后再往右找p,q的公共祖先,得到right如果p,q分在root的两侧,那么root一定就是最近公共祖先,否则有一边会找不到,而对应的,另一边就是公共祖先.
二叉搜索树与双向链表
输入一棵二叉搜索树,将该二叉搜索树转换成一个排序的双向链表。如下图所示
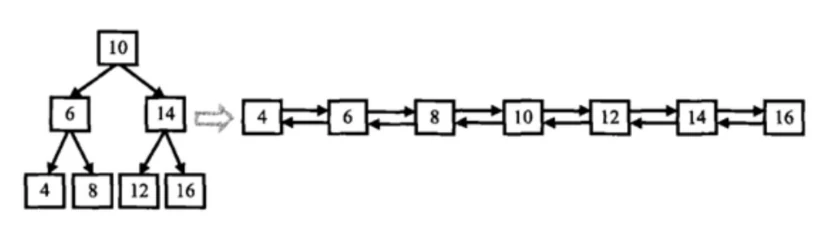
要求:空间复杂度\(O(1)\)(即在原树上操作),时间复杂度 \(O(n)\).
不能创建任何新的结点,只能调整树中结点指针的指向。当转化完成以后,树中节点的左指针需要指向前驱,树中节点的右指针需要指向后继.
我们的思路是:这是一棵二叉搜索树,为了保证遍历得到的结果是有序的,我们需要使用中序遍历.到了一个结点后,我需要做的是:把该节点的左改为前驱,该节点的右改为后继.所以在写函数头的时候,除了传入当前结点,还需要传入当前结点的前驱结点
void ConvertList(TreeNode* cur,TreeNode* prev)然后考虑进了函数后要做什么事情。我们的问题是把一棵二叉树变成一个双链表,我坚信我的函数能够帮助我实现这个目的,那么现在我处于cur节点,我要做的事情为:
- 把左子树变成双链表
- 把当前节点和
prev链接 - 再把右子树搞好
ConvertList(cur->left,prev);
cur->left = prev;
if(prev)
	prev->right = cur;
prev = cur;
ConvertList(cur->right,prev);然后我们要做的是直接让cur变为新的前驱,递归去进行下一次链接.这样下一个结点就会与这个prev进行连接.
但是有个问题,我们的链接是在左子树递归的回溯的过程中完成的
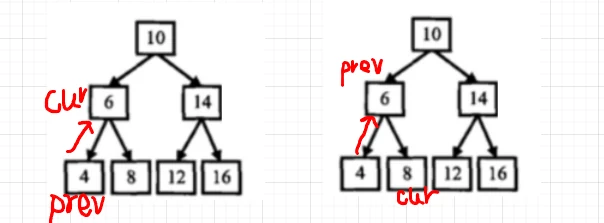
这就意味着下一层对prev的更新返回到上一层,这样才能对右边进行连接,因此,我们不能使用传值调用,而是需要传入引用.
void ConvertList(TreeNode* cur,TreeNode* &prev)完整代码为
class Solution {
public:
	void ConvertList(TreeNode* cur,TreeNode* &prev)
	{
		if(cur==nullptr)
			return;
		ConvertList(cur->left, prev);
		cur->left = prev;
		if(prev)
			prev->right = cur;
		prev = cur;
		ConvertList(cur->right, prev);
	}
    TreeNode* Convert(TreeNode* pRootOfTree) {
		TreeNode* prev = nullptr;
		ConvertList(pRootOfTree,prev);
		TreeNode* head = pRootOfTree;
		while(head && head->left)
			head = head->left;
		return head;
    }
};
从前序与中序遍历构造二叉树
给定两个整数数组 preorder 和 inorder ,其中 preorder 是二叉树的先序遍历, inorder 是同一棵树的中序遍历,请构造二叉树并返回其根节点。
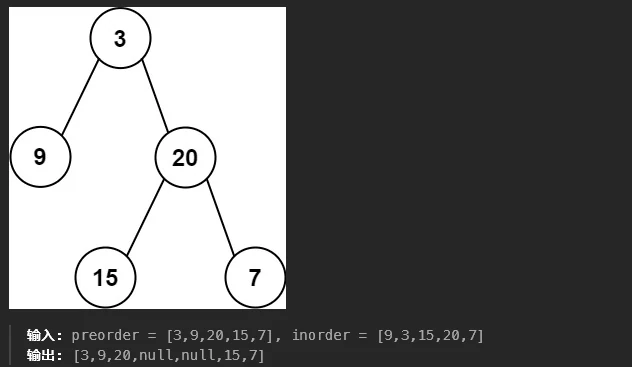
前序是:根,左子树,右子树.中序是:左子树,根,右子树.所以我们可以通过前序确定树的根(前序的第一个结点).然后按照该节点,把中序遍历的结果从根结点分为左右两部分,这两部分分别是左右子树中序遍历的结果.
而对于前序遍历,根后面跟着的就是左子树的前序结果,所以前序遍历第一个就是左子树的根.
所以核心思路是:
- 1.前序确定根
- 2.中序确定左子树的中序区间 和 右子树的中序区间
- 3.使用左子树的前序和左子树的中序区间递归构建左子树
- 4.使用右子树的前序和右子树的中序区间递归构建左子树
所以我要的东西有:前序遍历拿到的根,和中序遍历拿到的中序区间,所以我的函数头设计为
TreeNode* _buildTree(vector<int>& preorder, vector<int>& inorder,int prei,int inbegin,int inend)这个函数我希望它实现的功能是输入前序遍历的结果和中序遍历的结果,前序遍历的得到的根节点的位置和中序遍历的区间,能够给我返回一棵建立好的树的根节点.
我坚信这个函数能完成这个功能,那么我们就可以利用这个函数获取左树和右树.但是每一次获取都需要更新prei和中序区间
TreeNode* root = new TreeNode(preorder[prei]);
int rooti = inbegin;
while(rooti<=inend)
{
	if(inorder[rooti] == preorder[prei])
		break;
	else
		rooti++;
}
TreeNode* left = _buildTree(preorder,inorder,++prei,inbegin,rooti-1);
TreeNode* right = _buildTree(preorder,inorder,++prei,rooti+1,inend);但是需要额外判断一下,万一inbegin都比rooti-1小了呢?
if(inbegin <= rooti - 1)
	root->left = _buildTree(preorder,inorder,++prei,inbegin,rooti-1);
else
	root->left = nullptr;
if(rooti + 1 <= inend)
	root->right = _buildTree(preorder,inorder,++prei,rooti+1,inend);
else
	root->right = nullptr;
到这里还是同样的问题,我们希望的是左子树构建完以后自然而然的就能去构建右子树.对于前序来说,只有当左节点遍历完才能遍历到右节点.因此在
_buildTree(preorder,inorder,++prei,inbegin,rooti-1);返回后,我希望能保存prei的变化,所以prei要以引用的形式传入.
class Solution {
public:
    TreeNode* _buildTree(vector<int>& preorder, vector<int>& inorder,int& prei,int inbegin,int inend)
    {
        TreeNode* root = new TreeNode(preorder[prei]);
        int rooti = inbegin;
        while(rooti<=inend)
        {
            if(inorder[rooti] == preorder[prei])
                break;
            else
                rooti++;
        }
        if(inbegin <= rooti - 1)
            root->left = _buildTree(preorder,inorder,++prei,inbegin,rooti-1);
        else
            root->left = nullptr;
        if(rooti + 1 <= inend)
            root->right = _buildTree(preorder,inorder,++prei,rooti+1,inend);
        else
            root->right = nullptr;
        return root;
    }
    TreeNode* buildTree(vector<int>& preorder, vector<int>& inorder) {
        int prei = 0;
        int inbegin = 0;
        int inend = inorder.size()-1;
        return _buildTree(preorder,inorder,prei,inbegin,inend);
    }
};
从中序与后续遍历构造二叉树
给定两个整数数组 inorder 和 postorder ,其中 inorder 是二叉树的中序遍历, postorder 是同一棵树的后序遍历,请你构造并返回这颗二叉树 。
思路:和上道题几乎一模一样.只不过现在给出的是后序遍历:左-右-根.所以上道题我们一开始找到的根节点在最左边,而这道题我们的根节点在最右边
int prei = postorder.size()-1;
int inbegin = 0;
int inend = inorder.size()-1;
并且由于遍历顺序是左-右-根,所以我们的构造顺序变成从后往前,就是根-右-左.
if(inend>=rooti+1)
	root->right = _buildTree(inorder,postorder,--prei,rooti+1,inend);
else
	root->right = nullptr;
if(inbegin<=rooti-1)
	root->left = _buildTree(inorder,postorder,--prei,inbegin,rooti-1);
else
	root->left = nullptr;
所以整个题目的流程是:
- 1.后序找到根
- 2.根据根节点将中序分为左右两个部分
- 3.构建右子树
- 4.构建左子树
class Solution {
public:
    TreeNode* _buildTree(vector<int>& inorder, vector<int>& postorder,int& prei,int inbegin,int inend)
    {
        TreeNode* root = new TreeNode(postorder[prei]);
        int rooti = inbegin;
        while(rooti <= inend)
        {
            if(inorder[rooti] == postorder[prei])
            {
                break;
            }
            else
                rooti++;
        }
        if(inend>=rooti+1)
            root->right = _buildTree(inorder,postorder,--prei,rooti+1,inend);
        else
            root->right = nullptr;
        if(inbegin<=rooti-1)
            root->left = _buildTree(inorder,postorder,--prei,inbegin,rooti-1);
        else
            root->left = nullptr;
        return root;
    }
    TreeNode* buildTree(vector<int>& inorder, vector<int>& postorder) {
        int prei = postorder.size()-1;
        int inbegin = 0;
        int inend = inorder.size()-1;
        return _buildTree(inorder,postorder,prei,inbegin,inend);
    }
};
二叉树的前序遍历
给你二叉树的根节点 root ,返回它节点值的前序遍历。
递归方法不做过多解释
class Solution {
public:
    vector<int> ret;
    void dfs(TreeNode* root)
    {
        if(root == nullptr)
        {
            return;
        }
        ret.push_back(root->val);
        dfs(root->left);
        dfs(root->right);
    }
    vector<int> preorderTraversal(TreeNode* root) {
        dfs(root);
        return ret;
    }
};
现在我们来考虑非递归形式.要用非递归实现前序遍历需要借助一个栈.
前序遍历的过程是根-左子树-右子树.以这棵树为例
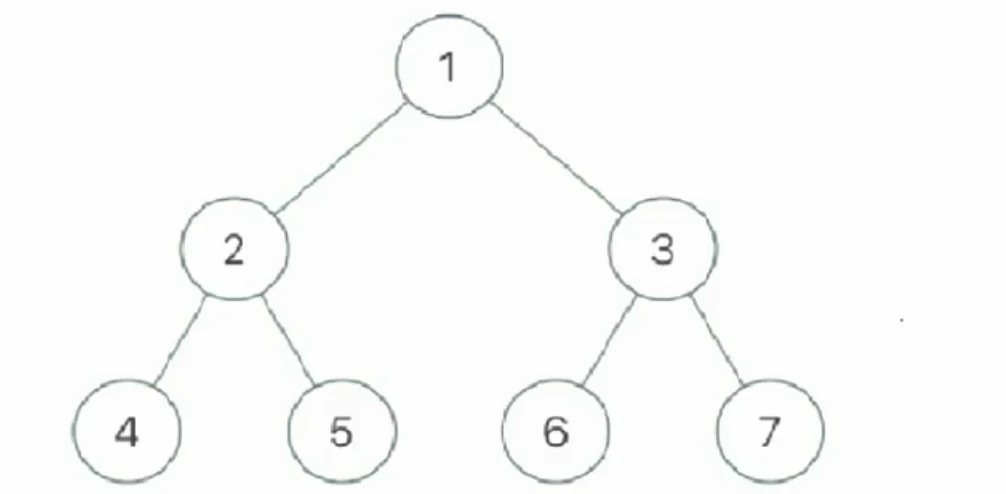
尽管要使用非递归实现,它的实现过程本质上来说还是在模拟递归的进行.对于这棵树而言,第一批访问的结点是[1,2,4],即该树的左路结点.剩下的部分是:左路节点的右子树.
所以在访问这棵树的时候,我们可以把它分为左路节点和其右树.访问一个结点就让该结点入栈,并存到vector中.当下一个访问为空的时候,说明左路结点就访问完成了.而需要访问右树的结点现在都在栈中,所以依次取栈中的结点取访问右树即可.
那么现在的问题是如何对右子树进行访问?右子树本质上来说是一棵树,所以又可以被分为左路结点和右树,这里就使用了递归的思想.我取出一个结点,然后去访问它的右树cur=cur->right,然后依次访问它的左节点并入栈cur=cur->left,这样右树的左路结点也就访问完了.然后再重复上述过程访问右树
以根节点为例,我要访问它的右树,现在的栈中只有[1].现在出栈,并访问其右节点,栈中为[3].然后访问左路结点,栈中为[3,6].6的左右节点为空,所以出栈返回,[3],然后访问3的右子树,3出栈,7入栈[7].这样就完成了1的右子树的访问,访问顺序为[3,6,7],符合前序遍历.
我们要做的事情实际上就是
- 1.访问左路结点
- 2.访问每个结点的右子树
接下来是代码实现,首先访问一棵树的左路结点
//访问左路结点
while(cur)
{
	ret.push_back(cur->val);
	st.push(cur);
	cur = cur->left;
}
然后去访问每一个左路节点的右树.每一次循环都让一个结点出栈.如果这个结点存在右树,就把右树结点入栈,这样下一次循环就会自动遍历该节点的左路节点.
//访问右子树结点
TreeNode *top = st.top();
st.pop();
cur = top->right;
最终代码如下
class Solution {
public:
    vector<int> ret;
    stack<TreeNode*> st;
    vector<int> preorderTraversal(TreeNode* root) {
        TreeNode *cur = root;
        while(cur || !st.empty())
        {
            //访问左路结点
            while(cur)
            {
                ret.push_back(cur->val);
                st.push(cur);
                cur = cur->left;
            }
            //访问右路结点
            TreeNode *top = st.top();
            st.pop();
            cur = top->right;
        }
        return ret;
    }
};
二叉树的中序遍历
给定一个二叉树的根节点 root ,返回它的 [中序遍历]() 。
依旧不对递归做过多解释
class Solution {
public:
    vector<int> ret;
    void dfs(TreeNode* root)
    {
        if(root==nullptr) return;
        dfs(root->left);
        ret.push_back(root->val);
        dfs(root->right);
    }
    vector<int> inorderTraversal(TreeNode* root) {
        dfs(root);
        return ret;
    }
};
我们来考虑迭代,中序遍历是左-根-右.我需要先遍历到树的最左端才能开始访问,所以我们可以用一个栈来帮助我进行回溯.
到达最左端后访问该节点,完成后出栈到上一个结点进行访问,然后再访问其右子树.完成后依次回溯
我们发现,思路和上一题几乎一模一样,要做的事情还是
- 1.访问左路结点
- 2.访问每个结点的右子树
不过区别在于:访问结点的时间从递归过程变成了回溯过程.接下来是代码实现
首先访问左路结点
while(cur)
{
	st.push(cur);
	cur = cur->left;
}然后在回溯(出栈)过程中对该节点进行访问(入vector).
TreeNode* top = st.top();
st.pop();
ret.push_back(top->val);
该节点访问完成后进入该节点右子树重复上述访问过程
if(top->right) cur = top->right;最终代码如下
class Solution {
public:
    vector<int> ret;
    stack<TreeNode*> st;
    vector<int> inorderTraversal(TreeNode* root) {
        TreeNode* cur = root;
        while(cur || !st.empty())
        {
            while(cur)
            {
                st.push(cur);
                cur = cur->left;
            }
            TreeNode* top = st.top();
            st.pop();
            ret.push_back(top->val);
            if(top->right)  cur = top->right;
        }
        return ret;
    }
};
二叉树的后序遍历
给你一棵二叉树的根节点 root ,返回其节点值的后序遍历。
递归方法依然不做详细介绍
class Solution {
public:
    vector<int> ret;
    void dfs(TreeNode* root)
    {
        if(root==nullptr) return;
        dfs(root->left);
        dfs(root->right);
        ret.push_back(root->val);
    }
    vector<int> postorderTraversal(TreeNode* root) {
        dfs(root);
        return ret;
    }
};
我们来看非递归后序遍历.后序遍历是左-右-根,这棵树依然可以被看成左路结点和右子树.这三道题的区别在于访问根节点的时机不同
首先遍历左路节点,依次入栈,遍历到最左结点以后还需要遍历它的右树,仍然使用栈记录全部过程.直到右树完成遍历后才能开始出栈,并对结点进行访问.
但是真实写代码的时候就会发现问题,当遍历[1,2,4]的时候,然后发现4是个叶子结点,可以进行访问并出栈.此时栈中为[1,2]此时第一次遇到结点2.然后发现这个结点右也不为空,所以往右遍历,将5入栈,此时栈中为[1,2,5].5结点为叶子结点,所以我们对其进行访问并出栈,此时栈中为[1,2].我们第二次遍历到结点2.这个时候结点2的左右都完成了访问,我们才可以对2进行访问.
这就导致如果我们不做特殊处理,2发现右边有东西就往右走,返回的时候再次判断发现右边的东西依然在哪,这样就死循环了.
if(top->right == nullptr)  {
	ret.push_back(st.top()->val);
	st.pop();
}
else
{
	cur = top->right;
}当结点2的右已经访问过时,代码并不知道,就会反复进入if和else.所以核心的问题是,如何确定右子树是否已经访问过.本质上来说,我们需要添加一个判断条件
if(top->right == nullptr || 右子树已经被访问) 那么现在就是考虑如何刻画右子树是否被访问的问题.一个传统的解决方案是定义一个标志位.但是在这个地方并解决不了.因为如果右子树后面还有右子树,就会被这个标志位干扰,因为整个递归过程都共用了同一个标志位.
有一个简单一些的思路是用双指针.利用另一个指针记录上一个访问的结点.而在后序遍历中,访问顺序是左-右-根.所以最后被访问的是根,上一个被访问的结点就会是这棵树的右孩子.
所以代码变为:当右树为空或者被访问过后,就可以对当前结点进行访问.
if(top->right == nullptr || lastNode == top->right)  {
	ret.push_back(top->val);
	lastNode = top;
	st.pop();
}
else
{
	cur = top->right;
}
最终代码如下
class Solution {
public:
    vector<int> ret;
    stack<TreeNode*> st;
    TreeNode *lastNode = nullptr;//最近访问的结点
    vector<int> postorderTraversal(TreeNode* root) {
        TreeNode* cur = root;
        while(cur || !st.empty())
        {
            while(cur)
            {
                st.push(cur);
                cur = cur->left;
            }
            TreeNode* top = st.top();
            if(top->right == nullptr || lastNode == top->right)  {
                ret.push_back(top->val);
                lastNode = top;
                st.pop();
            }
            else
            {
                cur = top->right;
            }
        }
        return ret;
    }
};
map和set是两种关联式容器,我们之前学习的Stack&Queue就是两种关联式容器.
set
set的底层就是一棵二叉树.(实际上是红黑树,一种自平衡的二叉搜索树).
template < class T, class Compare = less<T>, class Alloc = allocator<T> > class set;它有三个参数,第一个参数是参数类型,第二个参数则是一个仿函数Stack&Queue.
set的构造
explicit set (const key_compare& comp = key_compare(), const allocator_type& alloc = allocator_type());

template <class InputIterator>  set (InputIterator first, InputIterator last, const key_compare& comp = key_compare(), const allocator_type& alloc = allocator_type());

set (const set& x);
和其他容器一样,只需要传入正确的参数即可完成构造
set<int> s;同时也支持拷贝构造.由于底层是一棵树,它的拷贝构造是深拷贝类和对象
set的访问
由于set不再是之前简单的顺序结构,因此也不再支持随机访问,只能使用迭代器进行遍历.
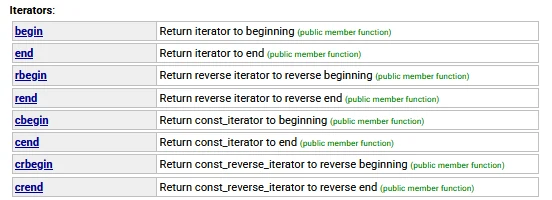
set<int>::iterator it = s.begin();
while (it != s.end())
{
	cout << *it << " ";
	it++;
}
虽然已经是树形结构,但是遍历方式几乎没有区别.
作为一棵搜索树,一种元素只能插入一次.对set进行遍历本质上是对set进行中序遍历.所以输出的结果是有序的.

既然支持迭代器,就必然支持范围for.
for(auto e:s)
{
	cout << e << " ";
}
set的容量操作
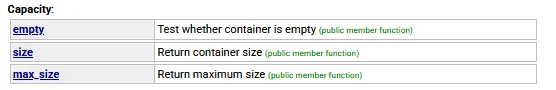
和之前的容器完全一致
set的操作接口
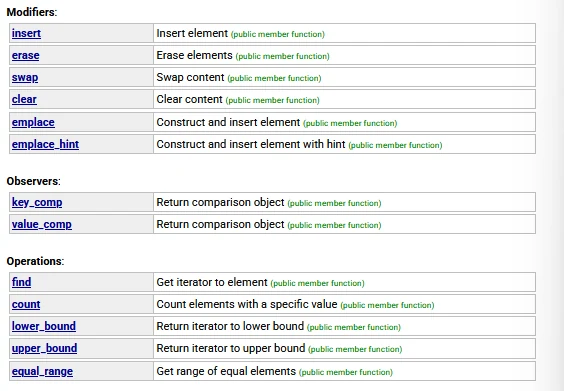
insert:插入数据
pair<iterator,bool> insert (const value_type& val);
iterator insert (iterator position, const value_type& val);
template <class InputIterator>  void insert (InputIterator first, InputIterator last);
可以直接插入一个数据,也可以传入一个迭代器位置,然后插入一个数据.或者直接插入一个迭代器区间.
erase:删除
void erase (iterator position);
size_type erase (const value_type& val);
void erase (iterator first, iterator last);可以直接传入值,删除set中的特定值.也可以传入迭代器位置,删除set的特定位置.传入迭代器往往会结合find使用
假设我要删除val为5的点,我可以调用
s.erase(5);也可以找到5的位置进行删除
set<int>::iterator del = s.find(5);
s.erase(del);但是这样写是不好的,如果我要删的元素在set中不存在,就会触发assert fail造成程序崩溃.因为find没找到元素返回了一个set::end.而end()是一个非法的位置,调用erase就崩了.所以正确的写法是
set<int>::iterator del = s.find(5);
if(del != s.end())
s.erase(del);那么这两种删除方案是否有区别?给值删除时如果该值不存在于set中,它就不会进行删除.而在底层,erase(val)实际上也是先查找再删除,二者无本质区别
find:查找特定位置,返回迭代器
iterator find (const value_type& val) const;如果没有找到,就返回set::end().
这个find是在set中直接实现的,而我们之前用的find是在算法库中实现的.这两个find有区别吗?
显然作为一棵搜索树,它的搜索效率是\(O(log_2N)\).而传统的find函数是一个模板函数,靠迭代器遍历全部元素进行搜索,搜索效率就下降到了\(O(N)\).
clear:删除所有元素
swap:两个容器进行交换
两个set交换实际上就是根节点的互换.
map
pair
map的定义如下
template < class Key,class T,class Compare = less<Key>, class Alloc =allocator<pair<const Key,T> > > class map;它除了有个Key以外,还有一个T,也就是常见的val.在正式介绍map前,我们先介绍一下pair.
typedef pair<const Key, T> value_type;pair我们一般认为是KV键值对的结构体.其定义如下
template <class T1, class T2>
struct pair
{
    typedef T1 first_type;
    typedef T2 second_type;

    T1 first;
    T2 second;
    pair(): first(T1()), second(T2())
    {}

    pair(const T1& a, const T2& b): first(a), second(b)
    {}
};该结构体有两个指针:first和second.
在进行插入,删除等操作的时候,都是按照键值对为最小单位进行操作.比如
map<int,int> m;
m.insert(1, 1);//error
m.insert(pair<int, int>(1, 1));为什么要这样做呢?这和它的迭代器有关.对于map来说,它存在Key和Val需要返回,但是C/C++并不允许一次返回多个参数,所以只能将这两个东西定义到一个结构体里面, 以结构体的方式进行返回.所以访问的时候也要按照结构体的方式进行访问
while (it != m.end())
{
	cout << (*it).first << ":" << (*it).second << " ";
	it++;
}
map的构造
explicit map (const key_compare& comp = key_compare(), const allocator_type& alloc = allocator_type());

template <class InputIterator>  map (InputIterator first, InputIterator last, const key_compare& comp = key_compare(), const allocator_type& alloc =allocator_type());

map (const map& x);
map的访问
map的访问也只能依靠迭代器进行.
由于pair的存在,迭代器返回的内容是一个结构体,因此需要按照结构体的方式去进行访问
map<int, int>::iterator it = m.begin();
while (it != m.end())
{
	cout << (*it).first << ":" << (*it).second << " ";
	it++;
}
而实际上,我们更习惯于去这样访问
map<int, int>::iterator it = m.begin();
while (it != m.end())
{
	cout << (it->first << ":" << it->second << " ";
	it++;
}it本身是个指针,指向树的结点,然后需要第二个箭头去访问key和val,所以真实的写法是
it->->first然而写的访问可读性太差了,所以省略了一个
支持迭代器,必然也就支持范围for,不过范围for返回的东西也是结构体,依然需要按照结构体的方式进行访问
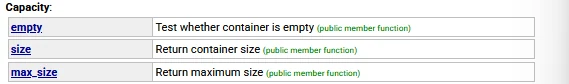
map的容量操作
map的操作接口
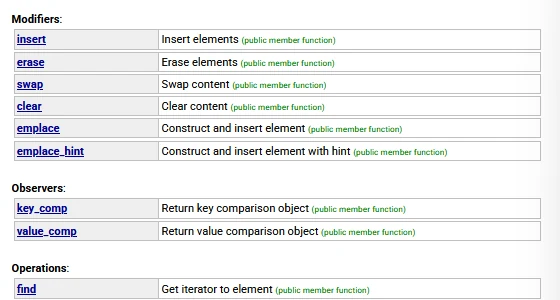
insert的定义如下
pair<iterator,bool> insert (const value_type& val);关于插入,我们也必须以pair的形式进行插入.
m.insert(pair<int, int>(1, 1));这里pair<int,int>(1,1)实际上是构造了一个匿名对象类和对象.有的时候也会用make_pair构造一个pair对象
template <class Tl, class T2>
pair<T1,T2> make_pair (T1 x, T2 y)
{
	return (pair<T1, T2>(x, y) ) ;
}
m.insert(make_pair(1, 1));insert的返回值为pair<iterator,bool>类型,它的first是一个迭代器,这个迭代器指向最新被插入的元素;而second是一个bool值,返回插入是否成功.
删除和find与上面set无异.
利用map,我们可以实现之前用KV模型实现过的出现次数的统计
void Times()
{
	string strArr[] = { "西瓜","苹果","蓝莓","西瓜","苹果","西瓜", "西瓜","苹果","蓝莓","蓝莓"};
	map<string, int> countTimes;
	for (auto str : strArr)
	{
		map<string, int>::iterator it = countTimes.find(str);
		if (it == countTimes.end())//没找到,插入
		{
			countTimes.insert(make_pair(str,1));
		}
		else
		{
			it->second++;
		}
	}
}
map的operator[]
之前我们学过的operator[]都是用于随机访问,而在map中,它的作用是传入key会返回对应值的引用.所以前面的代码可以简化为
for (auto& str : strArr)
{
	countTimes[str]++;
} 而operator[]的底层实际上是通过调用inser实现的.
mapped_type& operator[] (const key_type& k)
{
    return (*((this->insert(make_pair(k, mapped_type()))).first)).second;
}由于insert返回值的存在,直接调用插入k,如果k存在于map内,就会返回该位置的pair<iterator,bool>,所以这一部分是获取了目标位置的迭代器
this->insert(make_pair(k, mapped_type()))).first然后迭代器返回的也是一个pair对象,访问它的second就是我们需要的数值.
所以使用operator[]的时候,如果查找的k不存在map中,就会调用插入插入一个pair<k,T>,并且因为返回的是引用,还可以直接进行修改.
multiset和multimap
在前面的set中,不能出现重复的元素,而有的特殊场景下,需要这样的情况,此时就需要使用multiset
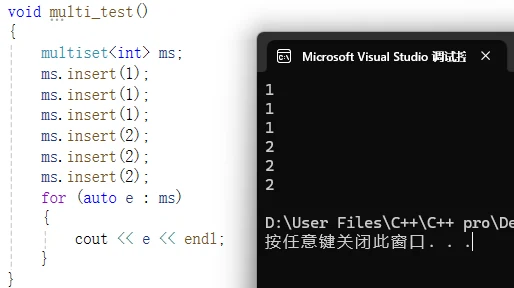
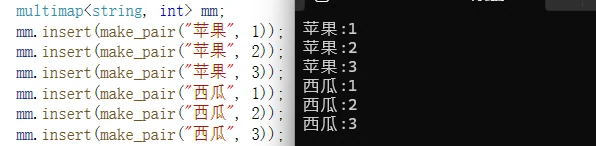
对于multimap来说,可以出现重复的key了,其他的使用方式和map也保持一致,区别在于
- insert的返回值变成了单独的
iterator,因为无论怎么插入都不会失败,所以不需要再返回bool - 不再有
operator[],因为当有多个相同key时,不知道改返回哪一个.
练习
前K个高频单词
给定一个单词列表 words 和一个整数 k ,返回前 k 个出现次数最多的单词。
返回的答案应该按单词出现频率由高到低排序。如果不同的单词有相同出现频率,按字典顺序 排序。
首先可以创建一个map来统计次数
map<string,int> countMap;
for(auto e:words)
{
	countMap[e]++;
}但是现在这个map是按key进行排序,我们要的是根据val进行排序.
我们可以考虑使用优先级队列Stack&Queue,也可以直接排序,取前k个.那么这就会遇到两个问题
- 键值对
pair<string,int>,需要按照值进行排序,所以需要一个仿函数Stack&Queue. - 如果出现次数相同,还需要对次数相同的按字典顺序排
sort是快排实现的,不稳定
还有另外一种方法,直接使用map来排.那么次数可能是重复的,所以就需要创建multimap.
multimap<int,string> sortMap;
for(auto kv : countMap)
{
	sortMap.insert(make_pair(kv.second,kv.first));
}
这棵树的从小到大排序的,并且插入顺序和字典顺序是一致的.要最大的两个可以直接从后往前取.但万一出现相同,直接从后往前去顺序就反了.
我们回顾一下map的定义
template < class Key,class T,class Compare = less<Key>, class Alloc =allocator<pair<const Key,T> > > class map;可以看到是有一个Compare参数的,默认传入less.multimap的定义也是一样的.所以我们可以手动传入这个仿函数.
multimap<int,string,greater<int>> sortMap;这样排的就是降序了,然后直接取前k个即可
vector<string> ret;
auto it = sortMap.begin();
while(it!=sortMap.end())
{
	if(k == 0) break;
	ret.push_back(it->second);
	it++;
	k--;
}
完整代码如下
class Solution {
public:
    vector<string> topKFrequent(vector<string>& words, int k) {
        map<string,int> countMap;
        for(auto e:words)
        {
            countMap[e]++;
        }
        multimap<int,string,greater<int>> sortMap;
        for(auto kv : countMap)
        {
            sortMap.insert(make_pair(kv.second,kv.first));
        }
        vector<string> ret;
        auto it = sortMap.begin();
        while(it!=sortMap.end())
        {
            if(k == 0) break;
            ret.push_back(it->second);
            it++;
            k--;
        }
        return ret;
    }
};
AVL树
AVL树,即平衡二叉搜索树,这棵树实际上就是map的底层结构.AVL树本质上是一棵二叉搜索树,但是新增了一个要求:该树任意结点的左右子树高度差不超过1.
为了便于实现,我们引入平衡因子的概念.
\[平衡因子=右子树高度-左子树高度\]
这样平衡因子为1代表右边高,为-1代表左边高,为0则左右高度相同,这样高度基本就可以控制在\(log_2N\).
AVL的定义
要实现这样的一棵树,首先我们先定义结点,以KV模型为例
template<class K,class V>
struct AVTreeNode
{
	AVTreeNode* <K, V>* _left;
	AVTreeNode* <K, V>* _right;
	AVTreeNode* <K, V>* _parent;
	int _bf;//平衡因子
	pair<K, V> _kv;
	AVTreeNode(const pair<K,V>& kv)
	:_left(nullptr),_right(nullptr),_parent(nullptr),_bf(0),_kv(kv)
	{ }
};和二叉搜索树不同的是,这棵树的组织结构变为了三叉链,多了一个指向父节点的指针,还多了一个平衡因子_bf.
AVL的插入与旋转
首先我们来写一个插入.如果根节点为空,就创建一个结点
if (_root == nullptr)
{
	_root = new Node(kv);
	return true;
}
否则,就找到正确的位置,比根大往右走,比跟小往左走
while (cur)
{
	if (cur->_kv.first > kv.first)
	{
		parent = cur;
		cur = cur->_left;
	}
	else if (cur->_kv.first < kv.first)
	{
		parent = cur;
		cur = cur->right;
	}
	else
		return false;
}
找到正确的位置之后创建一个新节点并进行插入
cur = new Node(kv);
if (kv.first > parent->_kv.first)
{
	parent->_right = cur;
	cur->_parent = parent;
}
else
{
	parent->_left = cur;
	cur->_parent = parent;
}由于是三叉链,还需要把_parent进行链接.到这里,就完成了二叉搜索树的插入,但这并不是AVL树.因为我们要保证是平衡二叉树,所以我们需要控制平衡.那么怎么来控制平衡?我们的思路是
- 按二叉搜索树的方式插入
- 更新平衡因子
- 检查平衡因子是否合规,如果没有则插入结束,否则进行旋转处理.
而是否出问题实际上就是在找有没有平衡因子大于\(\pm 1\)的结点
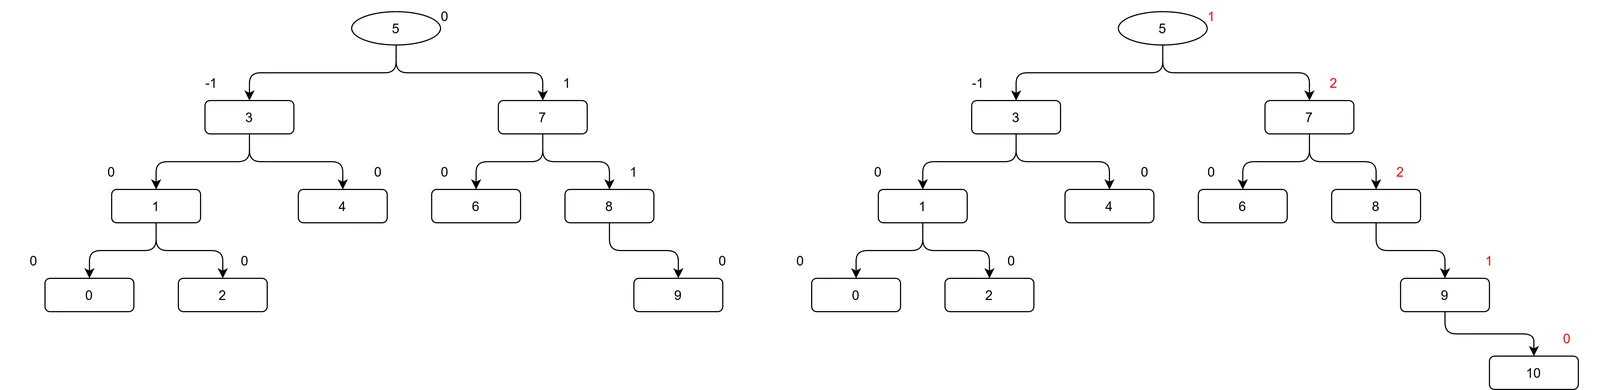
在右边执行了一次插入以后,该树不再属于AVL树,此时更新平衡因子,发现受到影响都是右边的一片.即:一个结点的插入只会影响该结点的祖先的平衡因子.所以当插入一个结点的时候
- 如果该节点是
parents的左,parents->_bf-- - 如果该节点是
parents的右,parents->_bf++
再想,假设我在8的左边进行插入
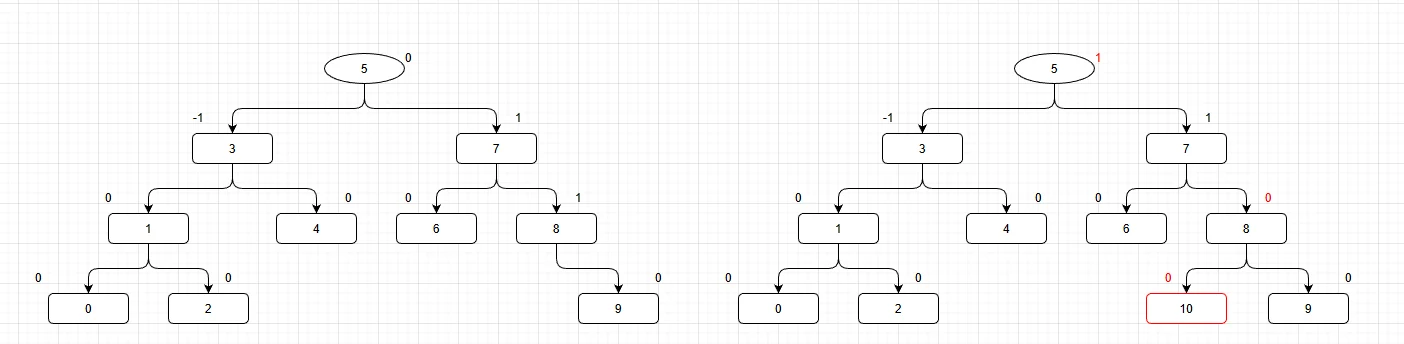
此时该插入的结点只对parents的平衡因子产生影响,因为插入该节点后,树的高度不变.换句话说,原本parents的平衡因子是\(\pm 1\),现在变为0了,说明该新插入的结点把原来矮的一边填上了,所以高度肯定不变.
反过来想,如果parents->_bf == 1 或 -1,只能是平衡因素从0变为1了,说明有一边变高了,树的高度变了,就会对上一层有影响,所以需要继续往上更新
最后一种情况,如果parents->_bf == 2或-2,说明平衡被打破,此时就需要旋转处理.
总结所有条件,插入一个结点后
- 如果该节点是
parents的左,parents->_bf-- - 如果该节点是
parents的右,parents->_bf++
if (cur == parent->_right)
{
	parent->_bf++;
}
else
{
	parent->_bf--;
}
完成插入后更新旋转因子
- 更新完成后如果
parents->_bf == 0,说明高度未发生改变,此时插入完成 - 更新完成后如果
parents->_bf == 1或-1,说明高度变了,就继续往上更新. - 如果
parents->_bf == 2或-2,说明平衡被打破,此时就需要旋转处理
if (parent->_bf == 0)
{
	break;
}
else if(parent->_bf ==1 || parent->_bf == -1)
{
	cur = parent;
	parent = parent->_parent;
}
else
{
	//出现问题,需要旋转处理
}
最后来处理旋转的问题.我们要旋转的往往只是出问题的部分子树,实际上也就这几种情况
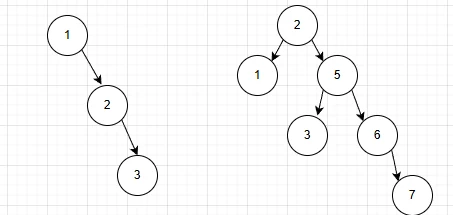
我们旋转需要保证两件事
- 旋转后左右高度差不超过1
- 旋转后依然保证是一棵二叉搜索树.
而旋转的思路非常简单,我们只需要把高的那边按下去即可
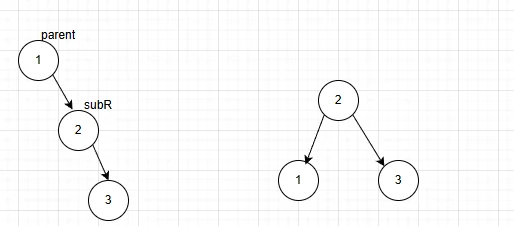
它的旋转过程是这样的
- 把
subR的_left给parent->_right - 把
parent给subR->_left
这个过程叫做左单旋,原理是subR的左一定比parents大,所以subR的左一定能够作为parent的右.而parent一定小于subR,所以parent可以作为subR的左.
而实际上,这个旋转规则是满足左单旋所有情况的.
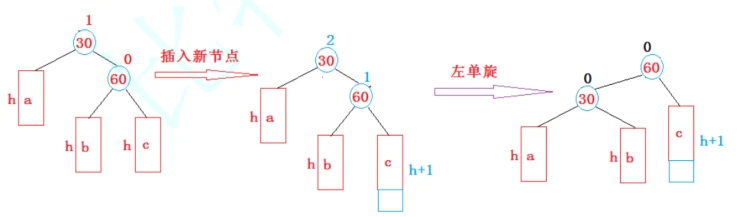
void RotateL(Node* parent)
{
	Node* subR = parent->_right;
	parent->_right = subR->_left;
	subR->_left = parent;
}而这样写并不正确,因为我们的树是用三叉链表存储的,所以我们还需要调整parent结点的指向.首先:原来b在经过
parent->_right = subR->_left;后,父亲由30变为了60,所以我们要更新b的父亲
Node* subR = parent->_right;
Node* subRL = subR->_left;
parent->_right = subRL;
if (subRL)
{
	subRL->parent = parent;
}
然后30由根节点变为了60的子树.所以30的父亲也要进行更新
subR->_left = parent;
Node* ppNode = parent->_parent;//提前进行保存
parent->_parent = subR;最后60变成了新的根,这个根可能是整棵树的根,也可能是子树的根.如果是整棵树的根就直接让它作为根,如果不是则要把该节点与30原来parent的父节点进行连接.所以分类讨论
if (_root == parent)
{
	_root = subR;
	subR->_parent = nullptr;
}
//parent是子树的根.
else
{
	if (ppNode->_left == parent)
		ppNode->_left = subR;
	else
		ppNode->_right = subR;
	subR->_parent = ppNode;
}最后还要更新平衡因子,旋转只会影响parent和subR的平衡因子,在旋转后,两个的平衡因子都会变为0
parent->_bf = 0;
subR->_bf = 0;
至此我们就完成了旋转
void RotateL(Node* parent)
{
	Node* subR = parent->_right;
	Node* subRL = subR->_left;
	parent->_right = subRL;
	if (subRL)
	{
		subRL->_parent = parent;
	}
	subR->_left = parent;
	Node* ppNode = parent->_parent;//提前进行保存
	parent->_parent = subR;
	//parent是整个树的根
	if (_root == parent)
	{
		_root = subR;
		subR->_parent = nullptr;
	}
	//parent是子树的根.
	else
	{
		if (ppNode->_left == parent)
			ppNode->_left = subR;
		else
			ppNode->_right = subR;
		subR->_parent = ppNode;
	}
	parent->_bf = 0;
	subR->_bf = 0;
}
而既然有左旋,就会有右旋,二者是完全对称的
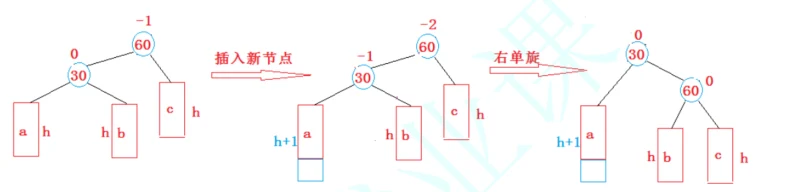
void RotateR(Node* parent)
{
	Node* subL = parent->_left;
	Node* subLR = subL->_right;
	parent->_left = subLR;
	if (subLR)
		subLR->_parent = parent;
	subL->_right = parent;
	Node* ppNode = parent->_parent;
	parent->_parent = subL;
	if (_root == parent)
	{
		_root = subL;
		subL->_parent = nullptr;
	}
	else
	{
		if (ppNode->_left == parent)
		{
			ppNode->_left = subL;
		}
		else
		{
			ppNode->_right = subL;
		}
		subL->_parent = ppNode;
	}
	parent->_bf = 0;
	subL->_bf = 0;
}
而实际上,还会有双旋的可能,我们插入端和根不再是一条直线,而是一条折线.那么我们的处理方式就应该是先把它旋转为直线的情况.
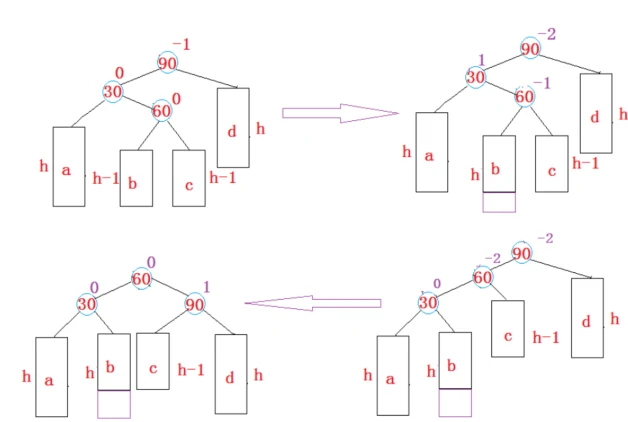
处理这种情况,我们可以先在30的位置进行左单旋,然后再在90的位置进行右单旋.
Node* subL = parent->_left;
Node* subLR = subL->_right;
int bf = subLR->_bf;
RotateL(parent->_left);
RotateR(parent);
旋转完成后需要对平衡因子进行处理.但是我们发现,插在b上和插在c上都需要进行左单旋处理,但是平衡因子的处理却出现了不同.如果一开始插在b上,30为0,90为1;一开始插在c上,则30为-1,90为0.所以我们还要考虑一开始插入的位置.
if (bf == -1)//说明一开始是在b插入
{
	parent->_bf = 1;
	subL->_bf = 0;
	subLR->_bf = 0;
}
else if (bf == 1)//一开始在c插入
{
	parent->_bf = 0;
	subL->_bf = -1;
	subRL->_bf = 0;
}
最后还有一种特殊情况
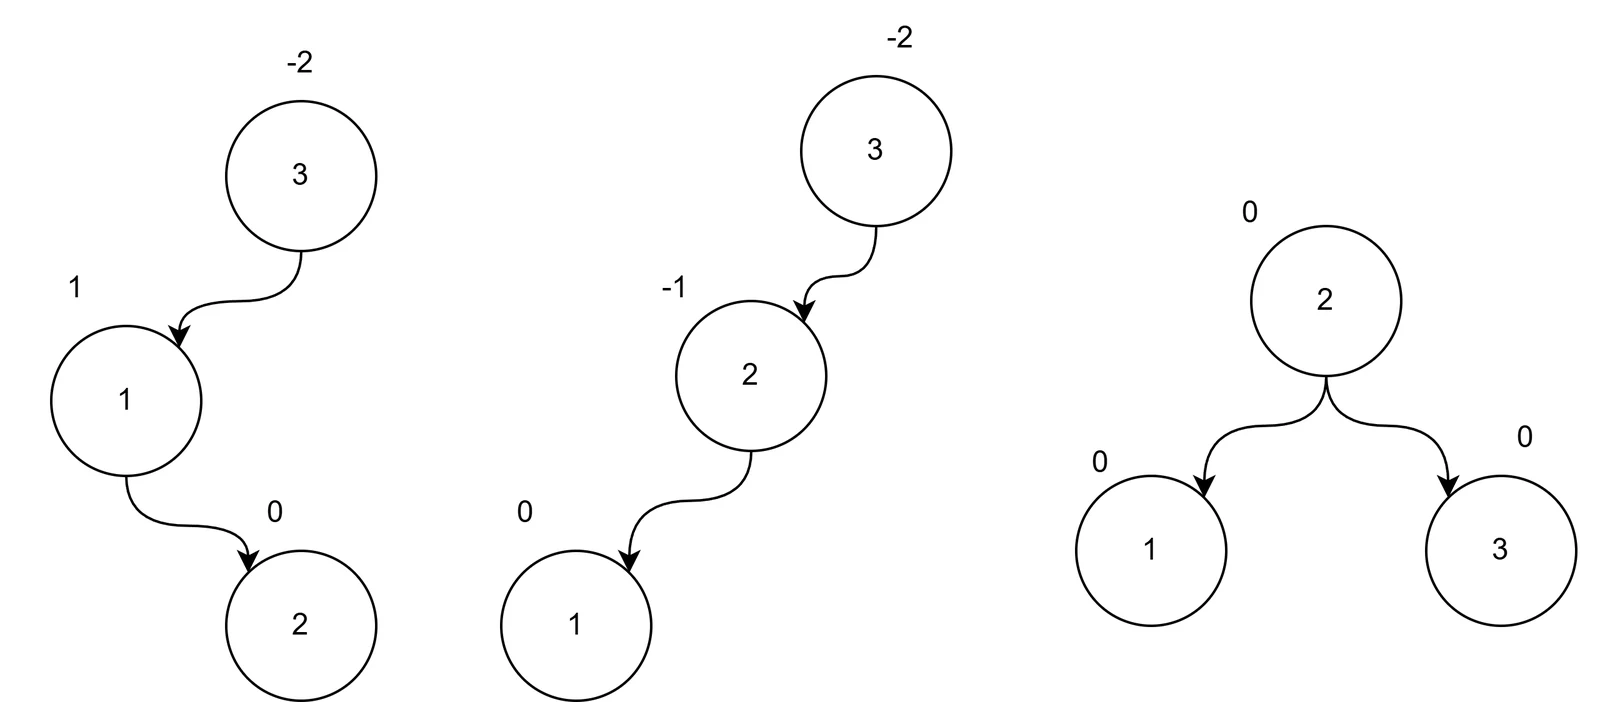
else if (bf == 0)
{
	parent->_bf = 0;
	subL->_bf = 0;
	subLR->_bf = 0;
}
此时三者的平衡因子均为0
void RotateLR(Node* parent)
{
	Node* subL = parent->_left;
	Node* subLR = subL->_right;
	int bf = subLR->_bf;
	RotateL(parent->_left);
	RotateR(parent);
	if (bf == -1)//说明一开始是在b插入
	{
		parent->_bf = 1;
		subL->_bf = 0;
		subLR->_bf = 0;
	}
	else if (bf == 1)//一开始在c插入
	{
		parent->_bf = 0;
		subL->_bf = -1;
		subLR->_bf = 0;
	}
	else if (bf == 0)
	{
		parent->_bf = 0;
		subL->_bf = 0;
		subLR->_bf = 0;
	}
}
同样的,双旋也有对称的情况
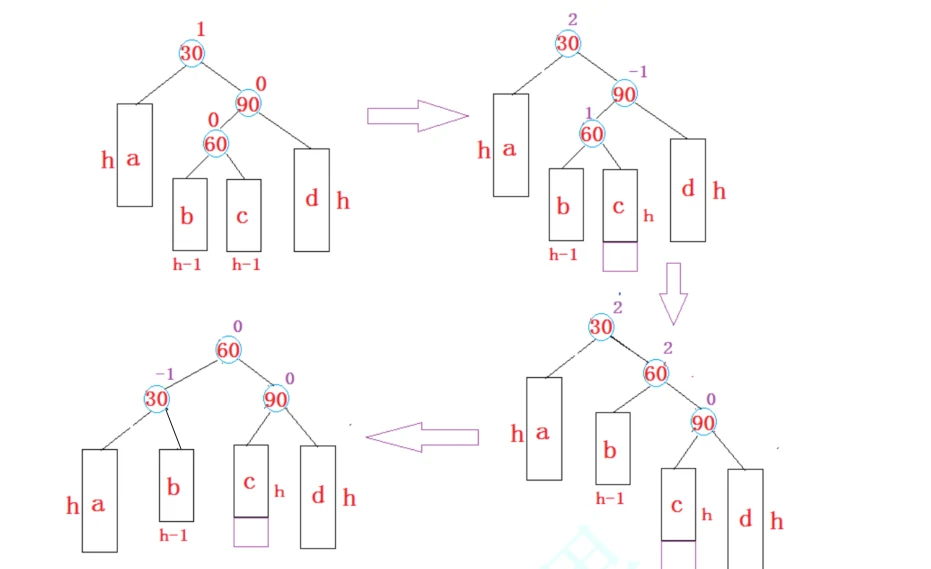
当根节点为2,右子树为-1的时候,我们的处理方式是先在90进行右单旋,再在30进行左单旋.
观察这两种旋转情况,本质上都是60的左右分别变成了30和90的左右,60作为了新的根.
void RotateRL(Node* parent)
{
	Node* subR = parent->_right;
	Node* subRL = subR->_left;
	int bf = subRL->_bf;
	RotateR(parent->_right);
	RotateL(parent);
	if (bf == -1)//说明一开始是在b插入
	{
		parent->_bf = 0;
		subR->_bf = 1;
		subRL->_bf = 0;
	}
	else if(bf == 1)//一开始在c插入
	{
		parent->_bf = -1;
		subR->_bf = 0;
		subRL->_bf = 0;
	}
	else if(bf == 0)
	{
		parent->_bf = 0;
		subR->_bf = 0;
		subRL->_bf = 0;
	}
}
那么我们如何把写好的旋转方法与我们的插入链接在一起,实际上只需要通过条件判断
else
{
	//出现问题,需要旋转处理
	if (parent->_bf == 2)
	{
		if (cur->_bf == 1) RotateL(parent);
		else if (cur->_bf == -1) //双旋
		{
			RotateRL(parent);
		}
	}
	if (parent->_bf == -2)
	{
		if (cur->_bf == -1) RotateR(parent);
		else if (cur->_bf == 1)
		{
			RotateLR(parent);
		}
	}
	break;
}
在旋转完成后,子树的高度恢复到了插入结点前的高度,所以完成旋转后的树一定是一个已经平衡的树,就对上一层不再产生影响,所以更新就结束了.于是我们就完成了插入的编写
void RotateL(Node* parent)
{
	Node* subR = parent->_right;
	Node* subRL = subR->_left;
	parent->_right = subRL;
	if (subRL)
	{
		subRL->_parent = parent;
	}
	subR->_left = parent;
	Node* ppNode = parent->_parent;//提前进行保存
	parent->_parent = subR;
	//parent是整个树的根
	if (_root == parent)
	{
		_root = subR;
		subR->_parent = nullptr;
	}
	//parent是子树的根.
	else
	{
		if (ppNode->_left == parent)
			ppNode->_left = subR;
		else
			ppNode->_right = subR;
		subR->_parent = ppNode;
	}
	parent->_bf = 0;
	subR->_bf = 0;
}
void RotateR(Node* parent)
{
	Node* subL = parent->_left;
	Node* subLR = subL->_right;
	parent->_left = subLR;
	if (subLR)
		subL->_parent = parent;
	subL->_right = parent;
	Node* ppNode = parent->_parent;
	parent->_parent = subL;
	if (_root == parent)
	{
		_root = subL;
		subL->_parent = nullptr;
	}
	else
	{
		if (ppNode->_left == parent)
		{
			ppNode->_left = subL;
		}
		else
		{
			ppNode->_right = subL;
		}
		subL->_parent = ppNode;
	}
	parent->_bf = 0;
	subL->_bf = 0;
}
void RotateRL(Node* parent)
{
	Node* subR = parent->_right;
	Node* subRL = subR->_left;
	int bf = subRL->_bf;
	RotateR(parent->_right);
	RotateL(parent);
	if (bf == -1)//说明一开始是在b插入
	{
		parent->_bf = 0;
		subR->_bf = 1;
		subRL->_bf = 0;
	}
	else if(bf == 1)//一开始在c插入
	{
		parent->_bf = -1;
		subR->_bf = 0;
		subRL->_bf = 0;
	}
	else if(bf == 0)
	{
		parent->_bf = 0;
		subR->_bf = 0;
		subRL->_bf = 0;
	}
}
void RotateLR(Node* parent)
{
	Node* subL = parent->_left;
	Node* subLR = subL->_right;
	int bf = subLR->_bf;
	RotateL(parent->_left);
	RotateR(parent);
	if (bf == -1)//说明一开始是在b插入
	{
		parent->_bf = 1;
		subL->_bf = 0;
		subLR->_bf = 0;
	}
	else if (bf == 1)//一开始在c插入
	{
		parent->_bf = 0;
		subL->_bf = -1;
		subLR->_bf = 0;
	}
	else if (bf == 0)
	{
		parent->_bf = 0;
		subL->_bf = 0;
		subLR->_bf = 0;
	}
}
bool Insert(const pair<K, V>& kv)
{
	if (_root == nullptr)
	{
		_root = new Node(kv);
		return true;
	}
	Node *parent = nullptr;
	Node* cur = _root;
	while (cur)
	{
		if (cur->_kv.first > kv.first)
		{
			parent = cur;
			cur = cur->_left;
		}
		else if (cur->_kv.first < kv.first)
		{
			parent = cur;
			cur = cur->_right;
		}
		else
			return false;
	}
	cur = new Node(kv);
	if (kv.first > parent->_kv.first)
	{
		parent->_right = cur;
		cur->_parent = parent;
	}
	else
	{
		parent->_left = cur;
		cur->_parent = parent;
	}
	//更新平衡因子
	while (parent)
	{
		if (cur == parent->_right)
		{
			parent->_bf++;
		}
		else
		{
			parent->_bf--;
		}
		if (parent->_bf == 0)
		{
			break;
		}
		else if(parent->_bf ==1 || parent->_bf == -1)
		{
			cur = parent;
			parent = parent->_parent;
		}
		else
		{
			//出现问题,需要旋转处理
			if (parent->_bf == 2)
			{
				if (cur->_bf == 1) RotateL(parent);
				else if (cur->_bf == -1) //双旋
				{
					RotateRL(parent);
				}
			}
			if (parent->_bf == -2)
			{
				if (cur->_bf == -1) RotateR(parent);
				else if (cur->_bf == 1)
				{
					RotateLR(parent);
				}
			}
			break;
		}
	}
	return true;
}
AVL的删除
我们插入的步骤为
- 按二叉搜索树的方式进行插入
- 更新平衡因子
- 旋转处理不合法结点
那么删除也是类似的
- 按搜索树的规则进行删除
- 更新平衡因子
- 旋转处理不合法结点
首先我们按照二叉搜索树的方式进行删除,首先找到待删除结点
bool Erase(const K& key)
{
	Node* cur = _root;
	Node* parent = nullptr;
	while (cur != nullptr)
	{
		if (cur->_kv.first > key)
		{
			parent = cur;
			cur = cur->_left;
		}
		else if (cur->_kv.first < key)
		{
			parent = cur;
			cur = cur->_right;
		}
		else
		{
			//找到了,开始删除
		}
	}
}找到了后,分三类讨论:左为空,右为空,左右均不为空.由于删除的结点是左还是右会影响平衡因子的更新,所以我们还需要一个变量isLeft来进行记录
首先考虑左为空的情况,首先判断该节点是不是根,如果是根的话,就只剩下了右子树,如果部署,要删除结点的左为空,就把该节点的右给该节点的父亲.给父亲的时候还要判断下该节点是父亲的左还是右.
bool isLeft = false;
if (parent != nullptr)
{
	isLeft = (parent->_left == cur);
}
if (cur->_left == nullptr)
{
	if (cur == _root)
	{
		_root = cur->_right;
		if (_root) _root->_parent = nullptr;
	}
	else
	{
		if (parent->_left == cur)
		{
			parent->_left = cur->_right;
			if (cur->_right) cur->_right->_parent = parent;
		}
		else
		{
			parent->_right = cur->_right;
			if (cur->_right) cur->_right->_parent = parent;
		}
	}
	delete cur;
	cur = nullptr;
}
如果右为空也同理
else if (cur->_right == nullptr)
{
	if (cur == _root)
	{
		_root = cur->_left;
		if (_root) _root->_parent = nullptr;
	}
	else
	{
		if (parent->_left == cur)
		{
			parent->_left = cur->_left;
			cur->_left->_parent = parent;
		}
		else
		{
			parent->_right = cur->_left;
			cur->_left->_parent = parent;
		}
	}
	delete cur;
	cur = nullptr;
}然后是两边都不为空的情况,此时使用替换删除法,去找右子树的最左节点来替换该节点,因为右子树的最左结点一定是右子树的最小的结点,这个结点会比cur大,但是比右子树所有结点都小,就可以保证不会破坏该树的搜索树规则.
else
{
	Node* rightMin = cur->_right;
	Node* rightMinPrev = cur;
	while (rightMin->_left != nullptr)
	{
		rightMinPrev = rightMin;
		rightMin = rightMin->_left;
	}
	cur->_kv = rightMin->_kv;
	isLeft = (rightMin == rightMinPrev->_left);
	if (rightMin == rightMinPrev->_left)
	{
		rightMinPrev->_left = rightMin->_right;
	}
	else
	{
		rightMinPrev->_right = rightMin->_right;
	}
	if (rightMin->_right) rightMin->_right->_parent = rightMinPrev;
	delete rightMin;
	rightMin = nullptr;
	parent = rightMinPrev;
}需要注意的是,在这里真正删除的结点是rightMin,所以更新isLeft的时候更新的应该是rightMin是否是rightMinPrev的左
isLeft = (rightMin == rightMinPrev->_left);并且,我们关注的parent结点是被删除结点的父节点,因此最后还要对parent结点进行更新.
至此删除就完成了,接下来我们需要根据isLeft对树的平衡因子进行更新.
它的平衡因子更新规则与插入基本相反:
- 右边删除父亲平衡因子
--,左边删除父亲平衡因子`++
if (isLeft)//删除了左子树,bf++
{
	parent->_bf++;
}
else
{
	parent->_bf--;
}- 删除后,父亲的平衡因子变成0,说明父亲所在的树的高度变了(原来是1或者-1,删完之后把高的那边删了),继续更新,此时需要把
isLeft回溯为上一层的isLeft.
if (parent->_bf == 0)//说明原本是1或者-1,删了一个后变平了.需要继续往上调整
{
	Node* grandparent = parent->_parent;
	if (grandparent)
	{
		isLeft = (parent == grandparent->_left);
	}
	parent = grandparent;
}- 删除后父亲的平衡因子变成\(\pm 1\),这说明父亲所在的树高度没变,对上层不会有影响,更新结束
else if (parent->_bf == 1 || parent->_bf == -1)//说明原本是0,删除结点后高度没变
{
	break;
}- 删除后父亲的平衡因子变为\(\pm 2\),此时不平衡,进行旋转处理
else
{
	//出现问题,需要旋转处理
	Node* grandparent = parent->_parent;
	if (grandparent)
	{
		isLeft = (parent == grandparent->_left);
	}
	if (parent->_bf == 2)//右树太高
	{
		Node* subR = parent->_right;
		if (subR->_bf == 1) RotateL(parent);//右树高,左旋
		else if (subR->_bf == -1) //双旋
		{
			RotateRL(parent);
		}
		else if (subR->_bf == 0)
		{
			RotateL(parent);
			subR->_bf = -1;
			parent->_bf = 1;
			break;
		}
	}
	else if (parent->_bf == -2)
	{
		Node* subL = parent->_left;
		if (subL->_bf == -1) // 纯左偏
		{
			RotateR(parent);
		}
		else if (subL->_bf == 1) // 左子树右偏
		{
			RotateLR(parent);
		}
		else if (subL->_bf == 0)
		{
			RotateR(parent);
			subL->_bf = 1;
			parent->_bf = -1;
			break;
		}
	}
	parent = grandparent;
}
特别情况是:遍历到达结点它的左右子树是平衡的,如下图
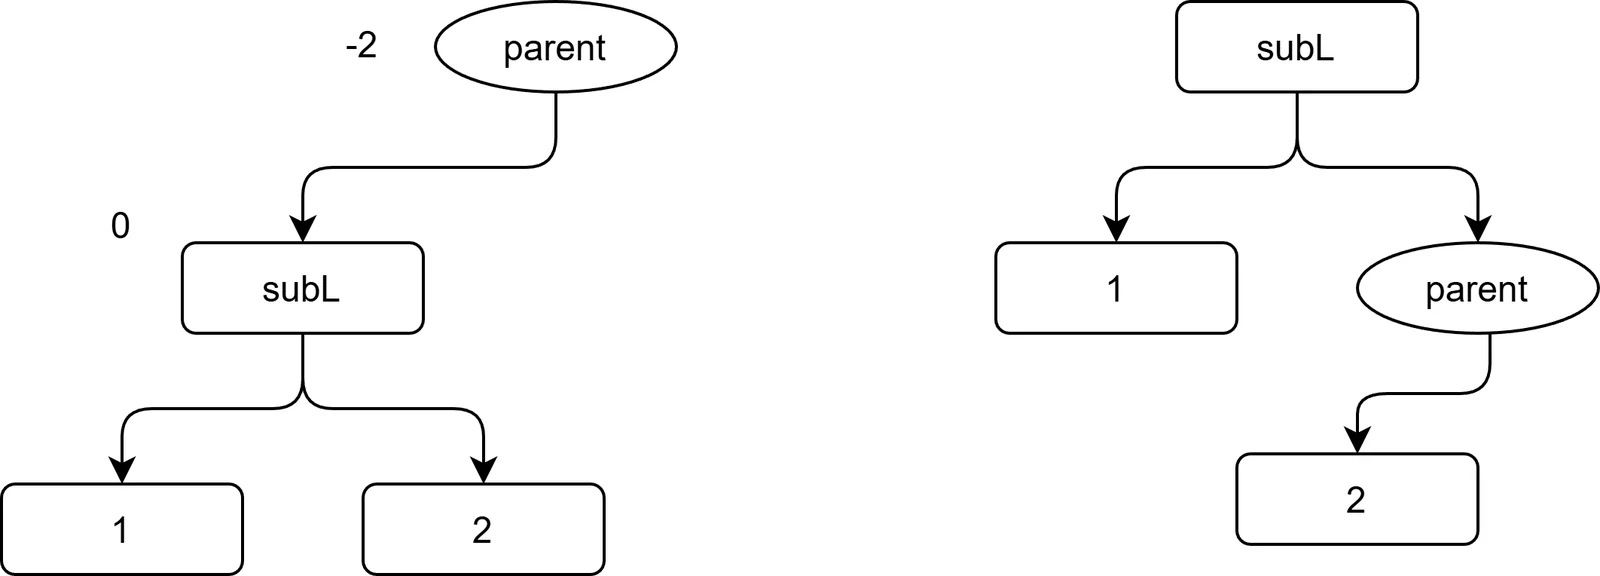
此时只需要进行一次右单旋,反向同理.最后再向上遍历,直到检查更新完成.
bool Erase(const K& key)
{
	Node* cur = _root;
	Node* parent = nullptr;
	while (cur != nullptr)
	{
		if (cur->_kv.first > key)
		{
			parent = cur;
			cur = cur->_left;
		}
		else if (cur->_kv.first < key)
		{
			parent = cur;
			cur = cur->_right;
		}
		else
		{
			//找到了,开始删除
			bool isLeft = false;
			if (parent != nullptr)
			{
				isLeft = (parent->_left == cur);
			}
			if (cur->_left == nullptr)
			{
				if (cur == _root)
				{
					_root = cur->_right;
					if (_root) _root->_parent = nullptr;
				}
				else
				{
					if (parent->_left == cur)
					{
						parent->_left = cur->_right;
						if (cur->_right) cur->_right->_parent = parent;
					}
					else
					{
						parent->_right = cur->_right;
						if (cur->_right) cur->_right->_parent = parent;
					}
				}
				delete cur;
				cur = nullptr;
			}
			else if (cur->_right == nullptr)
			{
				if (cur == _root)
				{
					_root = cur->_left;
					if (_root) _root->_parent = nullptr;
				}
				else
				{
					if (parent->_left == cur)
					{
						parent->_left = cur->_left;
						cur->_left->_parent = parent;
					}
					else
					{
						parent->_right = cur->_left;
						cur->_left->_parent = parent;
					}
				}
				delete cur;
				cur = nullptr;
			}
			else
			{
				Node* rightMin = cur->_right;
				Node* rightMinPrev = cur;
				while (rightMin->_left != nullptr)
				{
					rightMinPrev = rightMin;
					rightMin = rightMin->_left;
				}
				cur->_kv = rightMin->_kv;
				isLeft = (rightMin == rightMinPrev->_left);
				if (rightMin == rightMinPrev->_left)
				{
					rightMinPrev->_left = rightMin->_right;
				}
				else
				{
					rightMinPrev->_right = rightMin->_right;
				}
				if (rightMin->_right) rightMin->_right->_parent = rightMinPrev;
				delete rightMin;
				rightMin = nullptr;
				parent = rightMinPrev;
			}
			//完成删除,更新平衡因子
			while (parent)
			{
				if (isLeft)//删除了左子树,bf++
				{
					parent->_bf++;
				}
				else
				{
					parent->_bf--;
				}
				if (parent->_bf == 0)//说明原本是1或者-1,删了一个后变平了.需要继续往上调整
				{
					Node* grandparent = parent->_parent;
					if (grandparent)
					{
						isLeft = (parent == grandparent->_left);
					}
					parent = grandparent;
				}
				else if (parent->_bf == 1 || parent->_bf == -1)//说明原本是0,删除结点后高度没变
				{
					break;
				}
				else
				{
					//出现问题,需要旋转处理
					Node* grandparent = parent->_parent;
					if (grandparent)
					{
						isLeft = (parent == grandparent->_left);
					}
					if (parent->_bf == 2)//右树太高
					{
						Node* subR = parent->_right;
						if (subR->_bf == 1) RotateL(parent);//右树高,左旋
						else if (subR->_bf == -1) //双旋
						{
							RotateRL(parent);
						}
						else if (subR->_bf == 0)
						{
							RotateL(parent);
							subR->_bf = -1;
							parent->_bf = 1;
							break;
						}
					}
					else if (parent->_bf == -2)
					{
						Node* subL = parent->_left;
						if (subL->_bf == -1) // 纯左偏
						{
							RotateR(parent);
						}
						else if (subL->_bf == 1) // 左子树右偏
						{
							RotateLR(parent);
						}
						else if (subL->_bf == 0)
						{
							RotateR(parent);
							subL->_bf = 1;
							parent->_bf = -1;
							break;
						}
					}
					parent = grandparent;
				}
			}
			return true;
		}
	}
	return false;
}
删除结点完成了,最后只需要再写个析构函数就可以,注意树的结构,只可以后序析构
void DestroyTree(Node* node)
{
	if (node == nullptr) return;
	DestroyTree(node->_left);
	DestroyTree(node->_right);
	delete node;
}
~AVLTree()
{
	DestroyTree(_root);
	_root = nullptr;
}
AVL的其他操作接口
首先,我们提供中序遍历接口,方法与二叉搜索树中的保持一致
void _InOrder(Node* root)
{
	if (root == nullptr)
	{
		return;
	}
	_InOrder(root->_left);
	cout << root->_kv.first << ":"<< root->_kv.second << " ";
	_InOrder(root->_right);
}
void InOrder()
{
	_InOrder(_root);
}
AVL树作为一棵搜索树,中序的结果一定是有序的.此外,为了证明我们实现的树是一棵平衡树,每个节点左右子树高度差是否小于2.
bool _IsBalance(Node* root)
{
	if (root == nullptr)
		return true;
	int leftHeight = Height(root->_left);
	int rightHeight = Height(root->_right);
	return abs(leftHeight - rightHeight) < 2 && _IsBalance(root->_left)&& _IsBalance(root->_right);
}
bool IsBalance()
{
	return _IsBalance(_root)
}
还要补充高度接口
int Height(Node* root)
{
	if (root == nullptr)
		return 0;
	int leftHeight = Height(root->_left);
	int rightHeight = Height(root->_right);
	return leftHeight > rightHeight ? leftHeight + 1 : rightHeight + 1;
}
查找则按照正常搜索树进行查找即可
Node* Find(K key)
{
	Node* cur = _root;
	while (cur != nullptr)
	{
		if (cur->_kv.first > key)
			cur = cur->_left;
		else if (cur->_kv.first < key)
			cur = cur->_right;
		else
			return cur;
	}
	return nullptr;
}修改只允许修改val,所以找到对应结点进行修改即可.
红黑树
二叉搜索树的问题是在极端情况下,二叉搜索树的搜索效率会降级到\(O(N)\).为了避免这样的情况,就有人提出AVL树,利用树左右子树的高度差作为平衡要求,从而避免了这种情况.而实际上,AVL树也并非我们常用的树,红黑树才是现在常用的,至于为什么,我们在介绍完红黑树再说.
红黑树也是一棵二叉搜索树,但是在每一个结点上增加了存储位来存储颜色,而它的颜色不是红色就是黑色
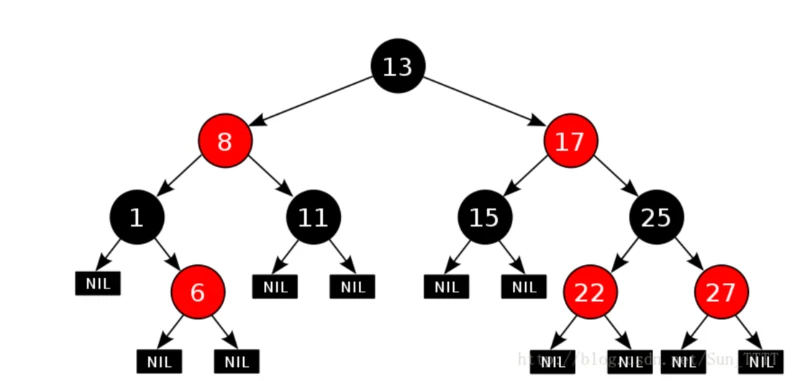
它的要求是:树的最长路径不超过最短路径的2倍,所以说AVL是严格的平衡二叉搜索树,而红黑树只是一种近似的平衡.而它的实现实际上只需要满足如下规则
- 1.每个结点不是红色就是黑色
- 2.根节点是黑色的
- 3.如果一个节点是红色的,则它的两个孩子结点是黑色的(不会出现连续红结点,但是可以出现连续的黑色结点)
- 4.对于每个结点,从该结点到其所有后代叶结点的简单路径上,均包含相同数自的黑色结点
- 5.每个叶子结点都是黑色的(此处的叶子结点指的是空结点)
为什么满足这些规则就可以实现近似的平衡?
我们考虑:一棵红黑树的最短的路径一定长于全黑路径,而全黑路径每两个黑节点之间都可以插入一个红结点,所以最长路径一定短于红黑交替.所以
\[\frac{最长}{最短}\leq 2\]
对于红黑树,增删查改的时间复杂度是\(O(log_2N)\),对于最短路径是\(O(log_2N)\),对于最长路径则是\(2*O(log_2N)\).从理论上分析,它的效率要比AVL树略差,但是对于现在的CPU而言,这点差异完全可以忽略不计.
而既然二者效率差不多,为什么红黑树用的更多?原因就是红黑树插入过程中的旋转更少,因为它的要求没有那么严格
红黑树的定义
依旧是使用KV模型对红黑树进行定义,首先进行结点定义,与之前多了一个颜色结点定义
enum Color
{
	BLACK,
	RED
};
template<class K, class V>
struct RBTreeNode
{
	RBTreeNode<K, V>* _left;
	RBTreeNode<K, V>* _right;
	RBTreeNode<K, V>* _parent;
	pair<K, V> _kv;
	Color _col;
	RBTreeNode(const pair<K, V>& kv)
	:_left(nullptr),_right(nullptr),_parent(nullptr),_kv(kv),_col(RED)
	{ }
};
然后是定义红黑树
template<class K, class V>
class RBTree
{
	typedef RBTreeNode<K,V> Node;
public:
private:
	Node* _root = nullptr;
};
红黑树的插入
红黑树的插入首先做的还是按照二叉搜索树的规则进行插入.用cur去遍历整棵树,插入值比当前值大往右插,比当前小往左插,相同则返回
bool Insert(const pair<K, V>& kv)
{
	if (_root == nullptr)
	{
		_root = new Node(kv);
		return true;
	}
	Node *parent = nullptr;
	Node* cur = _root;
	while (cur)
	{
		if (cur->_kv.first > kv.first)
		{
			parent = cur;
			cur = cur->_left;
		}
		else if (cur->_kv.first < kv.first)
		{
			parent = cur;
			cur = cur->_right;
		}
		else
			return false;
	}
	cur = new Node(kv);
	if (parent->_kv.first > kv.first)
	{
		parent->_left = cur;
		cur->_parent = parent;
	}
	else
	{
		parent->_right = cur;
		cur->_parent = parent;
	}
	return true;
}
而我们要实现树的最长路径不超过最短路径的2倍,只需要遵循上面五条规则即可.
1.根节点是黑的:
if (_root == nullptr)
{
	_root = new Node(kv);
	_root->_col = BLACK;
	return true;
}
2.没有连续的红结点
3.对于每个结点,从该结点到其所有后代叶结点的简单路径上,均包含相同数目的黑色结点
那么我们新插入的结点该赋什么值,无论赋为什么值,都会破坏2,3中的一条,显然,规则3更加复杂,所以我们赋为红色,别破坏规则三会更方便
cur->_col = RED;此时如果该节点父亲是黑色就不用处理;如果父亲是红色,就需要进行额外处理.那么为了能够维持住性质3的前提下,解决性质2带来的冲突,我们的思路是直接在原子树上调整个别结点的色值,并且保证变色后子树的根节点到叶子结点的路径上黑色结点个数与原来一致
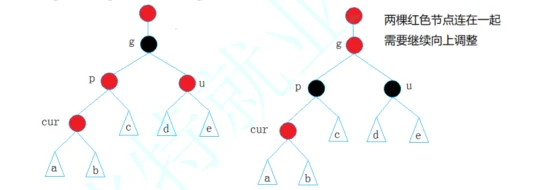
首先看第一种情况:cur为红,p为红,g为黑,u存在且为红
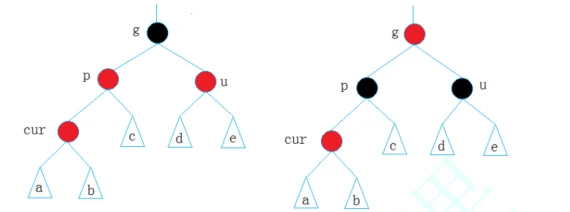
为了解决cur和p的冲突,我们把p的色值进行翻转,此时g的左树黑色结点多了一个,为了保证一致,右树也应该有一个结点的色值进行翻转,我们就选择u结点.这样这颗子树的左右黑色结点路径就保持一致了,对比原来多了一个黑色结点.为了不影响子树的上层,我们要把多的这个黑色结点减去,所以就把g也进行色值翻转.
那么这颗子树已经搞完了,那么可能给上层的树带来哪些问题?
- 第一:如果g是整棵树的根,根节点就被我们染成红色了,此时就要把根节点染回黑色.而染回黑色后,根的左右子树在变完色后同时多了一个黑色结点,并没有造成性质3的冲突
- 第二:g不是根,被染成红色后发现g的父亲是红色的,这样又造成了性质2的冲突,此时我们就需要把g当作
cur,把g->_parent当作p,继续往上调整
第二种情况:cur为红,p为红,g为黑,u不存在/u存在且为黑
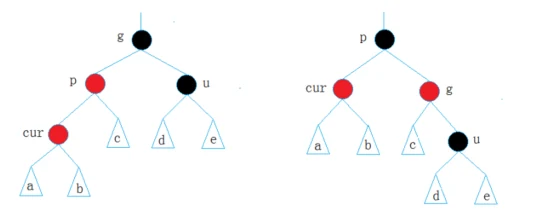
如果u不存在,此时cur一定是新插入的结点.如果u存在且为黑,那么cur一定不是新增结点,因为右树有两个黑,而左树只有一个,这说明cur原来就存在且为黑,但是被子树进行了修改变为了红色.
这两种情况此时无法单纯通过调整色值解决,就必须进行旋转.而这个旋转,有可能是单旋,也有可能是双旋.
进行旋转以后,把p变黑作为该子树新的根,把g变红,这样依旧保证了该子树左路径与右路径黑色结点数量的一致性.
第三种情况:cur为红,p为红,g为黑,u不存在/u存在且为黑
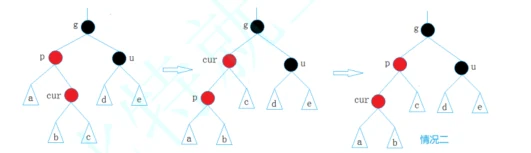
第三种情况实际上是第二种情况的变形,需要进行双旋,旋转一次后就变成了情况二
观察上面三种情况,我们发现红黑树的调节主要在看叔叔结点(u结点)
对于这种情况,我们需要分类讨论一下父节点到底是祖父结点的左子树还是右子树.而左右的处理实际上就是旋转的对称的.
//父节点为红色,才需要处理
while (parent && parent->_col == RED)
{
	Node* grandfather = parent->_parent;
	if (parent == grandfather->_left)
	{
		Node* uncle = grandfather->_right;
		if (uncle && uncle->_col == RED)
		{
			//情况1
			parent->_col = BLACK;
			uncle->_col = BLACK;
			grandfather->_col = RED;
			//继续往上处理
			cur = grandfather;
			parent = cur->_parent;
		}
	}
}
_root->_col = BLACK;但是如果第一种情况下的grandfather是根,就会导致根节点变为红色,所以在循环外面还要粗暴处理.
否则就是另外一种情况:叔叔不存在或存在且为黑,此时要做的就是旋转+变色.那么旋转的方向就取决于cur的方向和parent的方向.
else
{
	//情况三:双旋 -->变为单旋
	if (cur == parent->_right)
	{
		RotateL(parent);
		swap(parent, cur);
	}
	//情况二(有可能是从情况三变下来的)
	RotateR(grandfather);
	grandfather->_col = RED;
	parent->_col = BLACK;
	break;
}接下来考虑parent是grandparent的左的情况,实际上和前面的完全对称
else
{
	//相反情况
	//情况1
	Node* uncle = grandfather->_left;
	if (uncle && uncle->_col == RED)
	{
		parent->_col = BLACK;
		uncle->_col = BLACK;
		grandfather->_col = RED;
		cur = grandfather;
		parent = cur->_parent;
	}
	else
	{
		//情况3
		if (cur == parent->_left)
		{
			RotateR(parent);
			swap(cur, parent);
		}
		//情况2
		RotateL(grandfather);
		grandfather->_col = RED;
		parent->_col = BLACK;
		break;
	}
}
最后再来补充一下旋转,和AVL树的旋转一模一样,只是不需要再修改平衡因子了
void RotateR(Node* parent)
{
	Node* subL = parent->_left;
	Node* grandparent = parent->_parent;
	parent->_left = subL->_right;
	if (subL->_right != nullptr)
		subL->_right->_parent = parent;
	subL->_parent = grandparent;
	if (grandparent != nullptr)
	{
		if (grandparent->_left == parent)
			grandparent->_left = subL;
		else
			grandparent->_right = subL;
	}
	else
	{
		_root = subL;
	}
	subL->_right = parent;
	parent->_parent = subL;

}
void RotateL(Node* parent)
{
	Node* subR = parent->_right;
	Node* grandparent = parent->_parent;
	parent->_right = subR->_left;
	if (subR->_left != nullptr)
		subR->_left->_parent = parent;
	subR->_parent = grandparent;
	if (grandparent != nullptr)
	{
		if (grandparent->_left == parent)
			grandparent->_left = subR;
		else
			grandparent->_right = subR;
	}
	else
	{
		_root = subR;
	}
	subR->_left = parent;
	parent->_parent = subR;
}
这样我们的插入就完成了
void RotateR(Node* parent)
{
	Node* subL = parent->_left;
	Node* grandparent = parent->_parent;
	parent->_left = subL->_right;
	if (subL->_right != nullptr)
		subL->_right->_parent = parent;
	subL->_parent = grandparent;
	if (grandparent != nullptr)
	{
		if (grandparent->_left == parent)
			grandparent->_left = subL;
		else
			grandparent->_right = subL;
	}
	else
	{
		_root = subL;
	}
	subL->_right = parent;
	parent->_parent = subL;

}
void RotateL(Node* parent)
{
	Node* subR = parent->_right;
	Node* grandparent = parent->_parent;
	parent->_right = subR->_left;
	if (subR->_left != nullptr)
		subR->_left->_parent = parent;
	subR->_parent = grandparent;
	if (grandparent != nullptr)
	{
		if (grandparent->_left == parent)
			grandparent->_left = subR;
		else
			grandparent->_right = subR;
	}
	else
	{
		_root = subR;
	}
	subR->_left = parent;
	parent->_parent = subR;
}
bool Insert(const pair<K, V>& kv)
{
	if (_root == nullptr)
	{
		_root = new Node(kv);
		_root->_col = BLACK;
		return true;
	}
	Node *parent = nullptr;
	Node* cur = _root;
	while (cur)
	{
		if (cur->_kv.first > kv.first)
		{
			parent = cur;
			cur = cur->_left;
		}
		else if (cur->_kv.first < kv.first)
		{
			parent = cur;
			cur = cur->_right;
		}
		else
			return false;
	}
	cur = new Node(kv);
	if (parent->_kv.first > kv.first)
	{
		parent->_left = cur;
		cur->_parent = parent;
	}
	else
	{
		parent->_right = cur;
		cur->_parent = parent;
	}
	cur->_col = RED;
	//父节点为红色,才需要处理
	while (parent && parent->_col == RED)
	{
		Node* grandfather = parent->_parent;
		if (parent == grandfather->_left)
		{
			Node* uncle = grandfather->_right;
			if (uncle && uncle->_col == RED)
			{
				//情况1
				parent->_col = BLACK;
				uncle->_col = BLACK;
				grandfather->_col = RED;
				//继续往上处理
				cur = grandfather;
				parent = cur->_parent;
			}
			else
			{
				//情况三:双旋 -->变为单旋
				if (cur == parent->_right)
				{
					RotateL(parent);
					swap(parent, cur);
				}
				//情况二(有可能是第三种造成的)
				RotateR(grandfather);
				grandfather->_col = RED;
				parent->_col = BLACK;
				break;
			}
		}
		else
		{
			//相反情况
			//情况1
			Node* uncle = grandfather->_left;
			if (uncle && uncle->_col == RED)
			{
				parent->_col = BLACK;
				uncle->_col = BLACK;
				grandfather->_col = RED;
				cur = grandfather;
				parent = cur->_parent;
			}
			else
			{
				//情况3
				if (cur == parent->_left)
				{
					RotateR(parent);
					swap(cur, parent);
				}
				//情况2
				RotateL(grandfather);
				grandfather->_col = RED;
				parent->_col = BLACK;
				break;
			}
		}
	}
	_root->_col = BLACK;
	return true;
}
红黑树的删除
#补充 红黑树的删除和后序遍历析构
红黑树的其他接口
首先,我们提供中序遍历接口,方法与二叉搜索树中的保持一致
void _InOrder(Node* root)
{
	if (root == nullptr)
	{
		return;
	}
	_InOrder(root->_left);
	cout << root->_kv.first << ":"<< root->_kv.second << " ";
	_InOrder(root->_right);
}
void InOrder()
{
	_InOrder(_root);
}
红黑树的查找和之前的类似
Node* Find(const K& key)
{
	Node* cur = _root;
	while (cur)
	{
		if (cur->_kv.first > key)
		{
			cur = cur->_right;
		}
		else if (cur->_kv.first < key)
		{
			cur = cur->_left;
		}
		else
		{
			return cur;
		}
	}
	return nullptr;
}
map和set的模拟实现
map和set的框架
map和set的实现实际上使用的是一棵红黑树,其框架如下
template <class Key, class T>
class map {
    typedef Key key_type;
    typedef pair<const Key, T> value_type;
private:
    typedef rb_tree<key_type, value_type> rep_type;
    rep_type t;  // red-black tree representing map
};

template <class Key>
class set {
    typedef Key key_type;
    typedef Key value_type;
private:
    typedef rb_tree<key_type, value_type> rep_type;
    rep_type t;  // red-black tree representing set
};我们的value_type可以改为一个数或者一个pair,这样我们就可以一个红黑树适配两个数据结构
因此,我们红黑树的结点也需要修改一下
template<class T>
struct RBTreeNode
{
	RBTreeNode<T>* _left;
	RBTreeNode<T>* _right;
	RBTreeNode<T>* _parent;
	T _data;
	Color _col;
	RBTreeNode(const T& data)
	:_left(nullptr),_right(nullptr),_parent(nullptr),_data(data),_col(RED)
	{ }
};其中T代表数据类型,既可以是key,也可以是pair.
问题来了,我们在插入的时候,传入后需要对数据进行比较,如果传入的只是个键值,那当然可以比较.但如果是个pair,是不能直接比较的.并且pair的比较已经被系统重载,所以我们也不能进行重载.所以此时,我们就要使用仿函数Stack&Queue.
//Set
template<class K>
class my_set
{
public:
	struct SetKeyOfValue
	{
		const K& operator()(const K& key)
		{
			return key;
		}
	};
private:
	RBTree<K, K> _t;
};
//Map
template<class K,class V>
class my_map
{
public:
	struct MapKeyOfValue
	{
		const K& operator()(const pair<K, V>& kv)
		{
			return kv.first;
		}
	};
private:
	RBTree<K, pair<K, V>> _t;
};
要使用仿函数,红黑树也要增加一个参数
template<class K, class T,class KOfT>并且所有比较相关的都要去改为仿函数返回值,比如
KOfT koft;
Node *parent = nullptr;
Node* cur = _root;
while (cur)
{
	if (koft(cur->_data) > koft(data))
	{
		parent = cur;
		cur = cur->_left;
	}
	else if (koft(cur->_data) < koft(data))
	{
		parent = cur;
		cur = cur->_right;
	}
	else
		return false;
}
简单总结一下,我们对红黑树的模板参数定义为
template<class K, class T,class KOfT>如果是set,则传入的T参数就是键值;如果是map,那么传入的T参数是一个pair,然后我们通过仿函数KOfT去获取键值pair.first.
那么K参数是用来干什么的?实际上有的接口只需要使用键值,比如Find,Erase这类接口,为了避免繁琐,我们专门给红黑树留出键值的接口,所以我们还可以再优化一下原有的Find接口
Node* Find(const K& key)
{
	Node* cur = _root;
	KOfT koft;
	while (cur)
	{
		if (koft(cur->_data) > key)
		{
			cur = cur->_right;
		}
		else if (koft(cur->_data) < key)
		{
			cur = cur->_left;
		}
		else
		{
			return cur;
		}
	}
	return nullptr;
}这样做的好处非常明显,如果构造了一个对象my_map<int, string>,现在我要对键值为1的内容进行查找,按照原本的方法,我需要make_pair(1,"xxx"),然后把这个pair对象传入参数才能进行查找,这是无意义的.但是有了K参数,我就可以把1直接传入.
实际上,到这里我们的map和set的模拟实现就搞定了,因为我们现在可以直接调用红黑树的方法来实现我们需要的功能
//Set
bool Insert(const K& kv)
{
	return _t.Insert(kv);
}
//Map
bool Insert(const pair<K, V>& kv)
{
	return _t.Insert(kv);
}
这样实现的实际上是一个更高维度的泛型.
迭代器
为了实现map和set的迭代器,我们本质上需要实现的就是红黑树的迭代器.迭代器的本质就是对树的指针进行封装,所以我们需要对解引用进行重载.而由于map和set的数据类型并不相同,所以我们依然使用T参数
template<class T>
class __TreeIterator
{
	typedef RBTreeNode<T> Node;
	Node* _node;
	T& operator*()
	{
		return _node->_data;
	}
	T& operator->()
	{
		return &_node->_data;
	}
};然后还有指针的移动++,--,为了使用方便,我们把名字typedef一下
typedef __TreeIterator<T> Self;所以迭代器的框架就有了
template<class T>
class __TreeIterator
{
public:
	typedef RBTreeNode<T> Node;
	typedef __TreeIterator<T> Self;
	Node* _node;
	__TreeIterator(Node* node)
	: _node(node)
	{
	}
	T& operator*()
	{
		return _node->_data;
	}
	T* operator->()
	{
		return &_node->_data;
	}
	Self operator++()
	{

	}
	Self operator--()
	{

	}
	bool operator!=(const Self&s)
	{
		return _node != s._node;
	}
};
然后我们就可以在红黑树中定义迭代器
typedef __TreeIterator<T> iterator;
iterator begin()
{
	Node* cur = _root;
	while (cur && cur->_left) cur = cur->_left;
	return iterator(cur);
}
iterator end()
{
	return iterator(nullptr);
}对于迭代器来说,遍历得到的就是中序遍历,所以begin实际上是最左结点.进一步我们可以在map和set中对迭代器进行定义
//set中的迭代器
typedef RBTree<K, K, SetKeyOfValue>::iterator iterator;
iterator begin()
{
	return _t.begin();
}
iterator end()
{
	return _t.end();
}
//map中的迭代器
typedef RBTree<K, pair<K,V>, MapKeyOfValue>::iterator iterator;
iterator begin()
{
	return _t.begin();
}
iterator end()
{
	return _t.end();
}所以说,map和set就是红黑树的一层封装.但是到这里没完
typedef RBTree<K, K, SetKeyOfValue>::iterator iterator;
typedef RBTree<K, pair<K,V>, MapKeyOfValue>::iterator iterator;这两个typedef编译不通过,iterator是RBTree<K, K, SetKeyOfValue>::iterator的重命名,但是RBTree<K, K, SetKeyOfValue>::iterator这个类型是内嵌在红黑树里面的,编译器找不到,因为它并没有发生实例化,就找不到这个类.为了让它通过编译,我们可以前面增加typename
typedef typename RBTree<K, K, SetKeyOfValue>::iterator iterator;
typedef typename RBTree<K, pair<K,V>, MapKeyOfValue>::iterator iterator;
它的作用是告诉编译器,这里就是一个类型的名称,别的你别管了.
剩下的就是迭代器++,--的实现了.对于++,我们考虑右树不为空,根据中序左中右的顺序,此时我所在的结点已经访问完成了,下一个结点就该是右子树的最左结点,所以
Self operator++()
{
	if (_node->_right)
	{
		//如果右节点不为空,那么中序的下一个就是右子树的最左结点
		Node* subLeft = _node->_right;
		while (subLeft && subLeft->_left) subLeft = subLeft->_left;
		_node = subLeft;
	}
	else
	{
		//右节点为空
	}
	return *this;
}然后是右树为空的情况:右树为空说明该节点所在的子树已经访问完成,该往回找了,但是往回找不一定下个结点就是父亲,因为如果该节点是父亲结点的右节点,说明该节点的父亲在上一轮就已经被访问过了,就要继续往上找.总结一下就是去找祖先中孩子是父亲的左的祖先,这样说明这个祖先一定没被访问过.
Self operator++()
{
	if (_node->_right)
	{
		//如果右节点不为空,那么中序的下一个就是右子树的最左结点
		Node* subLeft = _node->_right;
		while (subLeft && subLeft->_left) subLeft = subLeft->_left;
		_node = subLeft;
	}
	else
	{
		//如果右树为空,表示node所在子树已经完成,就要祖先去找.
		Node* cur = _node;
		Node* parent = cur->_parent;
		while (parent && cur == parent->_right)
		{
			//说明该父节点已经被访问
			cur = parent;
			parent = cur->_parent;
		}
		_node = parent;
	}
	return *this;
}这本质上是一种非递归的遍历,但是它的前提是需要parent结点.--与上面的几乎相反
#补充 --迭代器实现.
为了实现const迭代器,我们完全可以复制一份,加上const,但是这样就太过冗余,所以我们可以对模板参数进行调整
template<class T,class Ref,class Ptr>
class __TreeIterator
{
public:
	typedef __TreeIterator<T,Ref,Ptr> Self;
}
这样的操作我们在之前已经做过List.
然后我们就可以分别定义两种迭代器
typedef __TreeIterator<T,T&,T*> iterator;
typedef __TreeIterator<const T, const T&, const T*> const_iterator;
operator []
我们之前讲过,operator[]是借助insert实现的,其返回值是一个迭代器+布尔值,所以我们修改一下我们insert的返回值
pair<iterator,bool> Insert(const T& data)如果插入成功,则返回插入结点的迭代器和true,然后调用make_pair去构造返回即可.但是需要注意的是:我们红黑树的插入思路是构建一棵二叉搜索树后再进行调整,而调整的时候我们的cur就会发生改变,导致指向的结点最终不是真实插入的结点.为了能够返回该结点,我们需要提前对该结点进行保存
cur = new Node(data);
Node* newnode = cur;这样我们就可以实现operator[]了
V& operator[](const K& key)
{
	pair<iterator, bool> ret = _t.Insert(make_pair(key, V()));
	return ret.first->second;
}