vector实际上就是顺序表和链表.本质上就是一个可以改变大小的数组.相较于string,vector更倾向于多项数据的存储,而string一般用于存储单项数据.那么string和vector<char>是否有区别.有,一个是vector<char>末尾不含\0,并且不支持+=,比较大小等,因为vector不仅仅存储char类型.
vector的构造
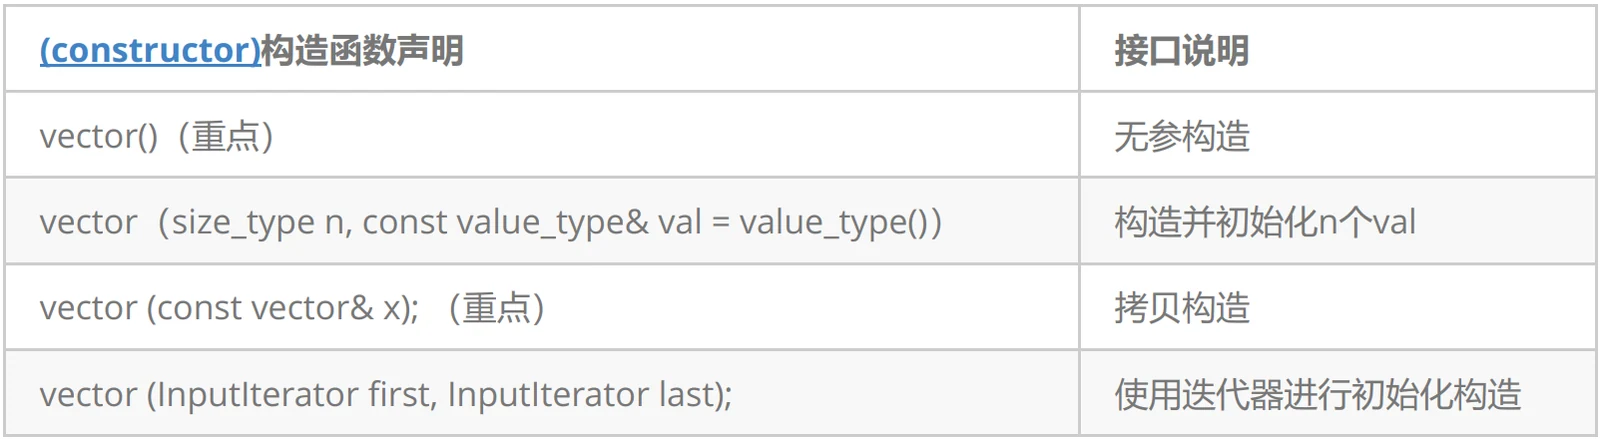
void test()
{
    vector<int> v1;//创建一个int类型的线性表
    v1.push_back(1);
    v1.push_back(2);
    v1.push_back(3);
    vector<int> v2(v1);//拷贝构造v2
    for (size_t i = 0; i < v1.size(); i++)
    {
        cout << v1[i] << " ";
    }
    for (size_t i = 0; i < v2.size(); i++)
    {
        cout << v2[i] << " ";
    }
}
vector的访问
vector的访问与string类似
operator[]
vector类中也对[]进行了重载

利用.size()就可以实现遍历
for (size_t i = 0; i < v1.size(); i++)
{
    cout << v1[i] << " ";
}
迭代器
迭代器分为三种类型:
1.普通迭代器,正向遍历,可读可写
vector<int>::iterator it = v1.begin();
while (it != v1.end())
{
    cout << *it << " ";
    it++;
}
2.只读迭代器:有的时候会出现只读的情况,比如
void print(const vector<int>& vt)
{
	vector<int>::iterator it = vt.begin();
	while (it != vt.end())
	{
	    cout << *it << " ";
	    it++;
	}
}
这样就会报错,因为const对象只读的,需要调用const类型的迭代器
void print(const vector<int>& vt)
{
	vector<int>::const_iterator it = vt.begin();
	while (it != vt.end())
	{
	    cout << *it << " ";
	    it++;
	}
}
3.倒序迭代器,用于反着遍历
vector<int>::reverse_iterator it = v1.rbegin();
while (it != v1.rend())
{
    cout << *it << " ";
    it++;
}
4.const反向迭代器
void reverse_print(const vector<int>& vt)
{
    vector<int>::const_reverse_iterator it = vt.rbegin();
    while (it != vt.rend())
    {
        cout << *it << " ";
        it++;
    }
}
迭代器失效
void test()
{
    vector<int> v1;//创建一个int类型的线性表
    v1.push_back(1);
    v1.push_back(2);
    v1.push_back(3);
    v1.push_back(4);
    v1.push_back(5);
    vector<int>::iterator it = v1.begin();
    v1.push_back(6);
    v1.push_back(7);
    v1.push_back(8);
    while (it != v1.end())
    {
        cout << *it << " ";
        it++;
    }
}
插入6并没有报错,但是插入7,8后开始报错
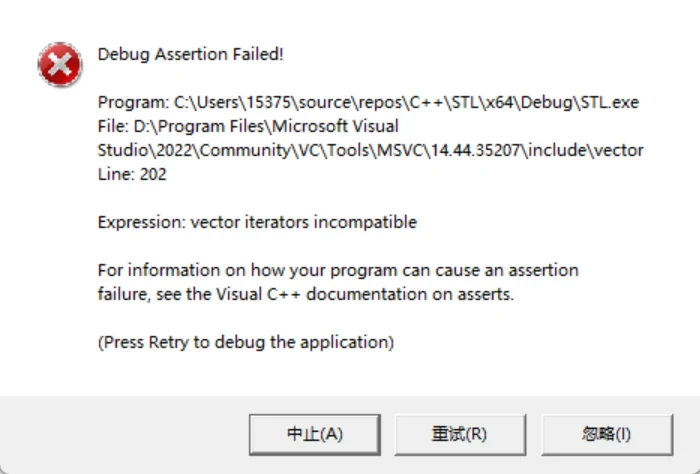
原因是一开始这个vector里面有6个空间,所以插入6以后没有问题,在插入7后发生扩容.而扩容做的是把原来的内容拷贝到一个新空间,然后把旧的空间释放,然后再插入7.这就导致it指向的空间是一段被释放的空间,此时迭代器就失效了.
不仅仅是尾插,所有可能造成扩容(reserve,resize,insert,push_back)都可能造成迭代器失效
void test()
{
    vector<int> v1;//创建一个int类型的线性表
    v1.push_back(1);
    v1.push_back(2);
    v1.push_back(3);
    v1.push_back(4);
    v1.push_back(5);
    v1.push_back(6);
    //要求删除所有偶数
    vector<int>::iterator it = v1.begin();
    while (it != v1.end())
    {
        if (*it % 2 == 0)
            v1.erase(it);
        it++;
    }
    for (auto e : v1)
        cout << e << " ";
}
程序又报错了,报错内容是:迭代器不可加.
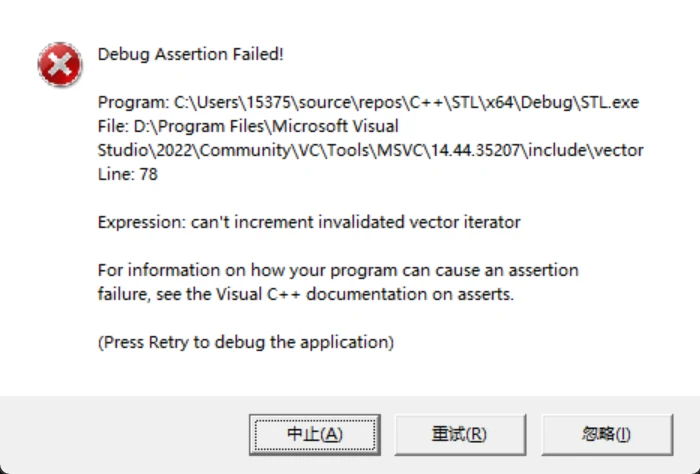
本来是123456,在删除第一个偶数后变成了13456,然后it++,于是it就指向4了,相当于把3漏了.本来不会报错,但是VS对这个做了检查,VS认为删除后it已经失效了,所以进行报错.在gcc下就不会报错,但是程序有可能结果错误.
为了解决这个问题,我们可以使用erase的返回值
iterator erase (iterator position);iterator erase (iterator first, iterator last);erase会返回一个迭代器,这个迭代器会指向被删除元素的下一个元素.
void test()
{
    vector<int> v1;//创建一个int类型的线性表
    v1.push_back(1);
    v1.push_back(2);
    v1.push_back(3);
    v1.push_back(4);
    v1.push_back(5);
    v1.push_back(6);
    //要求删除所有偶数
    vector<int>::iterator it = v1.begin();
    while (it != v1.end())
    {
        if (*it % 2 == 0)
            it=v1.erase(it);
        else
	        it++;
    }
    for (auto e : v1)
        cout << e << " ";
}
范围for
for (auto e : v1)
{
    cout << e << " ";
}
范围for本质上是由迭代器支持的.该段代码会被替换为上面的代码.
at
at实际上和[]是一样的,区别在于at会抛异常.现在如果我的vector有四个元素,我执行
v[4]得到的结果是断言错误
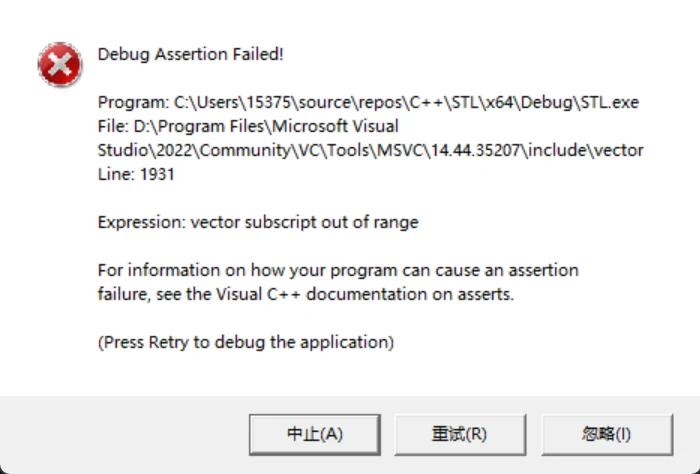
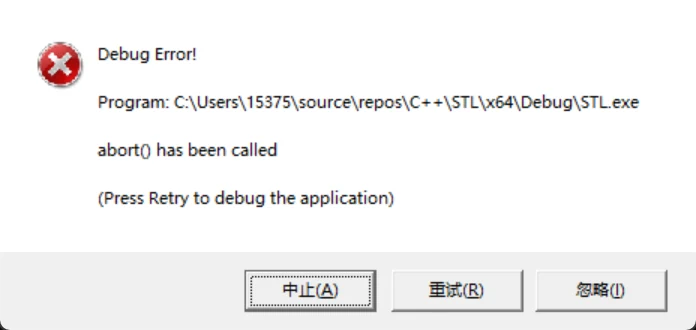
如果使用
v.at(4);则是抛出异常,实际上基本都使用[].
C++11
front/end
返回首元素/尾元素
vector的容量
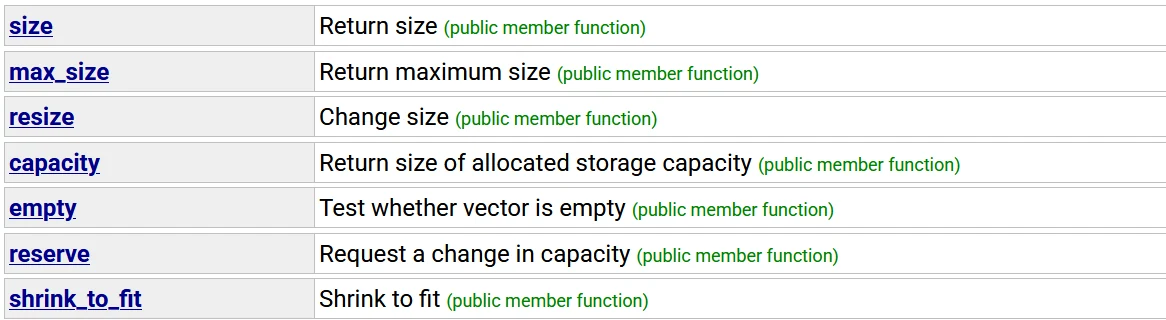
vector中有一个size,有一个capacity,增容倍数取决于编译器,在visual studio中使用的是1.5倍增容.
cout << v1.size() << endl;
cout << v1.capacity() << endl;
以2倍增容效率更高,因为增容次数会更小,但是相对的,增容后浪费的空间会更多.所以为了解决这个问题,提供了reserve和resize的接口,让你能够一次性开到需要的空间,避免了频繁的增容.
void reserve (size_type n);//将capacity增容到n
void resize (size_type n, value_type val = value_type());//将size和capacity增容到n,并初始化为val
vector的操作接口
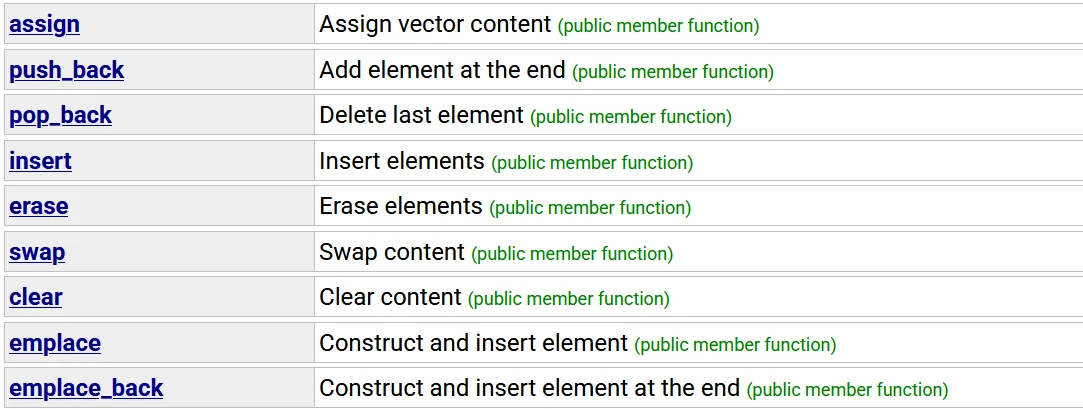
insert/erase
绝大部分是一样的,但是insert和erase有区别
iterator insert (iterator position, const value_type& val);
iterator erase (iterator position);
可以看到这两个接口需要传迭代器进去,所以如果要在pos位置进行插入或者删除,那就该写成
v.insert(v.begin()+pos);
v.erase(v.begin()+pos);
查
我们发现vector里面并没有提供find接口,那么在算法类里面实际上是有的
template<class InputIterator, class T>
InputIterator find (InputIterator first, InputIterator last, const T& val)
{
  while (first!=last) {
    if (*first==val) return first;
    ++first;
  }
  return last;
}
这实际上是一个函数模板,通过传入的迭代器就可以推出迭代器类型.传入两个迭代器,就会形成一个区间(这个区间是左闭右开的).find这个函数就会在这个迭代器区间内去找val,找到就返回那个位置的迭代器.使用迭代器的好处是无论是什么数据结构类型,都可以使用这个算法.
现在我要删除一个线性表中值为3的位置,那么代码如下
vector<int>::iterator pos = find(v1.begin(), v1.end(), 3);
if (pos != v1.end()){
    v1.erase(pos);
}
由于如果没有找到就会返回last,所以需要使用if进行判断.
vector的模拟实现
vector源码
从源码中来看,这就是vector的全部内容
#ifndef __SGI_STL_VECTOR
#define __SGI_STL_VECTOR

#include <stl_algobase.h>
#include <stl_alloc.h>
#include <stl_construct.h>
#include <stl_uninitialized.h>
#include <stl_vector.h>
#include <stl_bvector.h>
也就是说vector是由这一堆实现的,我们重点关注<stl_vector.h>,首先看到vector类中的成员变量
public:
  typedef T value_type;
  typedef value_type* pointer;
  typedef const value_type* const_pointer;
  typedef value_type* iterator;
  typedef const value_type* const_iterator;
  typedef value_type& reference;
  typedef const value_type& const_reference;
  typedef size_t size_type;
  typedef ptrdiff_t difference_type;

#ifdef __STL_CLASS_PARTIAL_SPECIALIZATION
  typedef reverse_iterator<const_iterator> const_reverse_iterator;
  typedef reverse_iterator<iterator> reverse_iterator;
#else /* __STL_CLASS_PARTIAL_SPECIALIZATION */
  typedef reverse_iterator<const_iterator, value_type, const_reference,
                           difference_type>  const_reverse_iterator;
  typedef reverse_iterator<iterator, value_type, reference, difference_type>
          reverse_iterator;
#endif /* __STL_CLASS_PARTIAL_SPECIALIZATION */
protected:
  typedef simple_alloc<value_type, Alloc> data_allocator;
  iterator start;
  iterator finish;
  iterator end_of_storage;
  void insert_aux(iterator position, const T& x);
  void deallocate() {
    if (start) data_allocator::deallocate(start, end_of_storage - start);
  }

  void fill_initialize(size_type n, const T& value) {
    start = allocate_and_fill(n, value);
    finish = start + n;
    end_of_storage = finish;
}可以看到,vector中利用迭代器定义出start,finish和end_of_storage.而迭代器是value_type*,value_type又是T类型,也就是说实际上vector的定义是这样的
tmplate<calss T>
class vector
{
public:
	typedef T* iterator;
private:
	iterator _start;
	iterator _finish;
	iterator _end_of_storage;
}
而我们认为的vector定义是
private:
	T* _arr;
	int _size;
int _capacity;这两者实际上是类似的.start指向开始位置,finish指向最后一个位置的下一个位置,所以finish-start=size._end_of_storage则是指向容量+1的位置,所以_end_of_storage-start=capacity.
定义成这样那么迭代器的返回就是直接返回
  iterator begin() { return start; }
  iterator end() { return finish; }
利用之前的定义实现构造函数
vector() : start(0), finish(0), end_of_storage(0) {}
  vector(size_type n, const T& value) { fill_initialize(n, value); }
  vector(int n, const T& value) { fill_initialize(n, value); }
对于含参的构造函数,实际上就是在调用之前的.接下来我们将模拟这样的定义去实现vector
Vector的模拟实现
首先是成员函数的定义,要定义成员函数就需要对迭代器进行定义
迭代器&访问
typedef T* iterator;
iterator begin() { return _start; }
iterator end() { return _finish; }
只要支持了迭代器,就会支持范围for
for (auto &e : v)
{
	cout << e << " ";
}
迭代器还有const类型,满足const传参
typedef const T* const_iterator;
const_iterator begin() const
{
	return _start;
}
const_iterator end() const
{
	return _finish;
}
完成后对成员函数进行定义
private:
	iterator _start;
	iterator _finish;
iterator _end_of_storage;那么访问操作还可以用operator[]
T& operator[](size_t i)
{
	assert(i < size());
	return _start[i];
}
const T&operator[](size_t i) const
{
	assert(i < size());
	return _start[i];
}
构造函数&析构函数
然后是构造函数,无参构造全部初始化为空
vector()
	:_start(nullptr), _finish(nullptr), _end_of_storage(nullptr)
{}
析构函数
~vector()
{
	delete[] _start;
	_start = _finish = _end_of_storage = nullptr;
}
之前讲到string的拷贝构造涉及深浅拷贝问题.
vector(const vector<T>& v)
{
	_start=new T[v.capacity()];
	_finish=_start;
	_end_of_storage=_start+v.capacity();
	for(size_t i=0;i<v.size();i++)
	{
		*_finish=v[i];
		_finish++;
	}
}那么既然传入的是const,就会遇到两个问题,第一:size和capacity都是普通类型,const传入后权限扩大.所以这类不涉及修改传入参数的建议都写成const.第二,operator[]也是可读可写的,所以还需要专门写一个const类型.那么这样就很麻烦,所以我们可以直接创建一个新的vector,然后把拷贝对象的数据尾插进来.
vector(const vector<T>& v)
	:_start(nullptr), _finish(nullptr), _end_of_storage(nullptr)
{
	for (auto e : v)
	{
		push_back(e);
	}
}
为了减少拷贝,可以引用传入
vector(const vector<T>& v)
	:_start(nullptr), _finish(nullptr), _end_of_storage(nullptr)
{
	for (const auto& e : v)
	{
		push_back(e);
	}
}
然后是赋值操作,本质上还是在进行拷贝
vector<T>& operator=(const vector<T>& v)
{
	if (this != &v)
	{
		delete[] _start;
		_start = new T[v.capacity()];
		memcpy(_start, v._start, sizeof(T) * v.size());
		_finish = _start + v.size();
		_end_of_storage = _start + v.capacity();
	}
	return *this;
}
然鹅,还有更简洁的写法,直接利用string
vector<T>& operator=(vector<T> v)
{
	swap(_start, v._start);
	swap(_finish, v._finish);
	swap(_end_of_storage, v._end_of_storage);
	return *this
}
但是往往我们会自己实现一个swap,所以赋值可以写为
void swap(vector<T>& v)
{
	::swap(_start, v._start);
	::swap(_finish, v._finish);
	::swap(_end_of_storage, v._end_of_storage);
}
vector<T>& operator=(vector<T> v)
{
	swap(v);
	return *this;
}
为了能够区分,需要加上域作用限定符
容量操作
线性表涉及到增删查改,那么就会涉及到扩容问题.那么要扩容就应该先拿到size和capacity,所以
size_t size() const
{
	return _finish - _start;
}
size_t capacity()
{
	return _end_of_storage - _start;
}
然后就是增容
void reserve(size_t n) const
{
	if (n > capacity())
	{
		size_t sz = size();
		T* tmp = new T[n];
		if (_start) {
			memcpy(tmp, _start, sizeof(T) * size());
			delete[] _start;
		}
		_start = tmp;
		_finish = _start + sz;
		_end_of_storage = tmp + n;
	}
}增容到n,首先满足n>capacity,成立后开一个大小为n的空间,并把原来的内容拷贝到新的空间中,然后分别调整3个指针在新开的空间中指到正确的位置.
还有resize,用于给一个vector分配内存并初始化.那么之前讲过String,resize分为三种情况.第一种是分配的内存小于原本的size,那么直接把原本的数据截断即可;第二种是分配的内存大于原本的size,分类讨论其与capacity的关系来决定是否需要扩容.
void resize(size_t n, const T& val = T())
{
	if (n < size())
	{
		_finish = _start + n;
	}
	else
	{
		if (n > capacity()) {
			reserve(n);
		}
		while (_finish < _end_of_storage)
		{
			*_finish = val;
			_finish++;
		}
	}
}为什么不可以用memset,因为这个函数是按字节进行处理,而T是什么类型都不清楚.比如
int a[10];
memset(a,1,10*sizeof(int));
得到的结果并不是10个1.原因是它是按字节处理的,一个int是4字节,那么实际上执行后得到的结果是00000001 00000001 00000001 00000001.这就导致结果并不是1.并且缺省值不直接写0也是这个原因.这样的写法表示的是默认传入T的构造函数,构造一个缺省.
增删查改
然后来写尾插
void push_back(const T& x)
{
	if (_finish == _end_of_storage)
	{
		size_t new_capacity = capacity() == 0 ? 2 : 2 * capacity();
		reserve(new_capacity);
	}
	*_finish = x;
	_finish++;
}
已经使用了模板类就尽可能使用const+引用进行传参,这样能节省空间.
然后是尾删
void pop_back()
{
	assert(_start<_finish);
	_finish--;
}
然后是插入,要插入数据就需要把数据首先往后挪
void insert(iterator pos, const T& x)
{
	assert(pos <=_finish);
	if (_finish == _end_of_storage)
	{
		size_t new_capacity = capacity() == 0 ? 2 : 2 * capacity();
		reserve(new_capacity);
	}
	iterator end = _finish - 1;
	while (end >= pos)
	{
		*(end+1) = *end;
		end--;
	}
	*pos = x;
	_finish++;
}但是这样写是不对的,程序会跑死.原因是如果发生了增容,我们的_start就会指向一段新的空间,传进来的pos的位置却没发生改变,这样就导致迭代器失效了.所以如果发生增容,pos也需要进行更改
void insert(iterator pos, const T& x)
{
	assert(pos <=_finish);
	if (_finish == _end_of_storage)
	{
		size_t n = pos - _start;
		size_t new_capacity = capacity() == 0 ? 2 : 2 * capacity();
		reserve(new_capacity);
		pos = _start + n;
	}
	iterator end = _finish - 1;
	while (end >= pos)
	{
		*(end+1) = *end;
		end--;
	}
	*pos = x;
	_finish++;
}
这样我们的尾插就可以进行复用
void push_back(const T& x)
{
	insert(_finish, x);
}
然后是erase,删除某个位置的数据也涉及到数据的整体搬移,并且要返回当前位置的下一个位置,即传入pos,删除该位置后,应当还是返回pos
iterator erase(iterator pos)
{
	iterator it = pos;
	while (it != _finish)
	{
		*it=*(it+1);
		it++;
	}
	--_finish;
	return pos;
}
那么尾删也能复用了
void pop_back()
{
	erase(_finish-1);
}
使用memcpy的问题
如果我们的vector存的是内置类型,那并不会出什么问题.但是如果不是内置类型,比如string,
int main()
{
	vector<string> v;
	v.push_back("11111111111111");
	v.push_back("22222222222222");
	v.push_back("33333333333333");
	v.push_back("44444444444444");
	for (auto e : v)
	{
		cout << e << " ";
	}
	return 0;
}
我们发现程序崩溃了.并且还发现,如果v中只有两个string,程序的结果是正确的,但是出现第三个后程序就崩溃了.这说明问题出在增容上.我们的增容是这样写的
void reserve(size_t n) const
{
	if (n > capacity())
	{
		size_t sz = size();
		T* tmp = new T[n];
		if (_start) {
			memcpy(tmp, _start, sizeof(T) * size());
			delete[] _start;
		}
		_start = tmp;
		_finish = _start + sz;
		_end_of_storage = tmp + n;
	}
}
我们增容的操作是把原本空间上的东西拷贝到新的空间上,那么memcpy是按字节拷贝,vector类是三个指针共12字节.所以整个拷贝过程是这样的.
1.创建临时空间tmp
2.将原空间内容拷贝到tmp
3.释放原空间.释放空间时会调用string的析构函数导致拷贝过去的两个字符串指向了一块空的空间
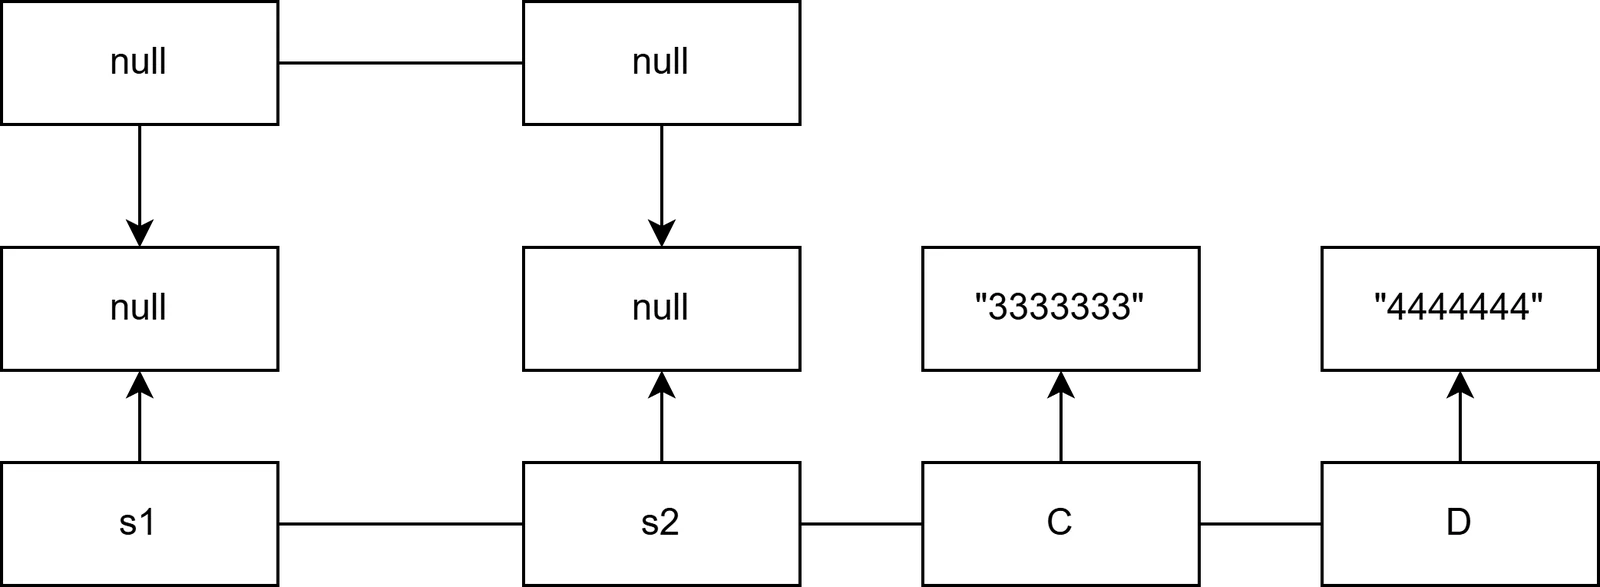
也就是说这里使用memcpy依旧是浅拷贝.那么怎么解决呢?答案是不能再使用memcpy,而是利用赋值
void reserve(size_t n) const
{
	if (n > capacity())
	{
		size_t sz = size();
		T* tmp = new T[n];
		if (_start) {
			for(size_t i=0;i<sz;i++)
			{
				tmp[i]=_start[i];
			}
			delete[] _start;
		}
		_start = tmp;
		_finish = _start + sz;
		_end_of_storage = tmp + n;
	}
}_start[i]是一个string类型,赋值本质上调用了拷贝构造,于是就得到了深拷贝.
代码汇总
#include <iostream>
#include <memory.h>
#include <assert.h>
#include <string>
using std::cout, std::string, std::swap;
template<class T>
class vector
{
public:
	typedef T* iterator;
	typedef const T* const_iterator;
	vector()
		:_start(nullptr), _finish(nullptr), _end_of_storage(nullptr)
	{}
	~vector()
	{
		delete[] _start;
		_start = _finish = _end_of_storage = nullptr;
	}
	/*vector(const vector<T>& v)
	{
		_start = new T[v.capacity()];
		_finish = _start;
		_end_of_storage = _start + v.capacity();
		for (size_t i = 0; i < v.size(); i++)
		{
			*_finish = v[i];
			_finish++;
		}
	}*/
	vector(const vector<T>& v)
		:_start(nullptr), _finish(nullptr), _end_of_storage(nullptr)
	{
		for (auto e : v)
		{
			push_back(e);
		}
	}
	size_t size() const
	{
		return _finish - _start;
	}
	size_t capacity() const
	{
		return _end_of_storage - _start;
	}
	iterator begin() { return _start; }
	iterator end() { return _finish; }
	const_iterator begin() const
	{
		return _start;
	}
	const_iterator end() const
	{
		return _finish;
	}
	void reserve(size_t n)
	{
		if (n > capacity())
		{
			size_t sz = size();
			T* tmp = new T[n];
			if (_start) {
				//memcpy(tmp, _start, sizeof(T) * size());
				for (size_t i = 0; i < sz; i++)
				{
					tmp[i] = _start[i];
				}
				delete[] _start;
			}
			_start = tmp;
			_finish = _start + sz;
			_end_of_storage = tmp + n;
		}
	}
	void push_back(const T& x)
	{
		/*if (_finish == _end_of_storage)
		{
			size_t new_capacity = capacity() == 0 ? 2 : 2 * capacity();
			reserve(new_capacity);
		}
		*_finish = x;
		_finish++;*/
		insert(_finish, x);
	}
	void pop_back()
	{
		/*assert(_start < _finish);
		_finish--;*/
		erase(_finish - 1);
	}
	T& operator[](size_t i)
	{
		assert(i < size());
		return _start[i];
	}
	/*vector<T>& operator=(const vector<T>& v)
	{
		if (this != &v)
		{
			delete[] _start;
			_start = new T[v.capacity()];
			memcpy(_start, v._start, sizeof(T) * v.size());
			_finish = _start + v.size();
			_end_of_storage = _start + v.capacity();
		}
		return *this;
	}*/
	void swap(vector<T>& v)
	{
		::swap(_start, v._start);
		::swap(_finish, v._finish);
		::swap(_end_of_storage, v._end_of_storage);
	}
	vector<T>& operator=(vector<T> v)
	{
		swap(v);
		return *this;
	}
	const T& operator[](size_t i) const
	{
		assert(i < size());
		return _start[i];
	}
	void insert(iterator pos, const T& x)
	{
		assert(pos <=_finish);
		if (_finish == _end_of_storage)
		{
			size_t n = pos - _start;
			size_t new_capacity = capacity() == 0 ? 2 : 2 * capacity();
			reserve(new_capacity);
			pos = _start + n;
		}
		iterator end = _finish - 1;
		while (end >= pos)
		{
			*(end+1) = *end;
			end--;
		}
		*pos = x;
		_finish++;
	}
	iterator erase(iterator pos)
	{
		iterator it = pos;
		while (it != _finish)
		{
			*it=*(it+1);
			it++;
		}
		--_finish;
		return pos;
	}
	void resize(size_t n, const T& val = T())
	{
		if (n < size())
		{
			_finish = _start + n;
		}
		else
		{
			if (n > capacity()) {
				reserve(n);
			}
			while (_finish < _end_of_storage)
			{
				*_finish = val;
				_finish++;
			}
		}
	}
private:
	iterator _start;
	iterator _finish;
	iterator _end_of_storage;
};
题目
找单
给你一个 非空 整数数组 nums ,除了某个元素只出现一次以外,其余每个元素均出现两次。找出那个只出现了一次的元素。
你必须设计并实现复杂度\(O(N)\)的算法来解决此问题,且该算法只使用常量额外空间。
本题的思想在时间复杂度与空间复杂度中涉及过.思路是利用异或,相同的数字异或得到的结果是0,0与任何数异或得到的数就是其本身,所以只需要把所有数都异或一遍就可以.
class Solution {
public:
    int singleNumber(vector<int>& nums) {
        int val=0;
        vector<int>::iterator it=nums.begin();
        while(it!=nums.end())
        {
            val^=*it;
            it++;
        }
        return val;
    }
};
找单II
给你一个整数数组 nums ,除某个元素仅出现一次外,其余每个元素都恰出现三次请你找出并返回那个只出现了一次的元素.
你必须设计并实现线性时间复杂度的算法且使用常数级空间来解决此问题。
思路:统计出32个位每个位合计起来1出现的次数.那么每个位1的个数要么是3n,要么是3n+1.3n对应只出现一次的那个数对应位为0;3n+1对应只出现那个数对应位为1.然后就可以把只出现一次的那个数拼出来.
首先,怎么把每一位单独拿出来.我们可以把它与1相与,这样得到的始终是最低位.然后通过右移就可以逐步获得每个数32位的每一位
(nums[i]>>j)&1我们可以开一个32位的数组来统计每一位”1″的个数,所以得到
int arr[32]={0};
for(int j=0;j<32;j++){
	for(int i=0;i<nums.size();i++)
    {
        arr[j]+=((nums[i]>>j)&1);
    }
}
模三后这个数组存储的实际上就是那个单独的数的每一位,最后需要将其进行还原,相当于把数组中模三结果为1的位置为1,所以使用或运算.
int ret=0;
for(int i=0;i<32;i++)
{
    if(arr[i]%3==1)
        ret|=(1<<i);
}
所以完整代码为
class Solution {
public:
    int singleNumber(vector<int>& nums) {
        int arr[32]={0};
        for(int j=0;j<32;j++){
            for(int i=0;i<nums.size();i++)
            {
                arr[j]+=((nums[i]>>j)&1);
            }
        }
        int ret=0;
        for(int i=0;i<32;i++)
        {
            if(arr[i]%3==1)
                ret|=(1<<i);
        }
        return ret;
    }
};
找单III
给你一个整数数组 nums,其中恰好有两个元素只出现一次,其余所有元素均出现两次。 找出只出现一次的那两个元素。你可以按 任意顺序 返回答案。
你必须设计并实现线性时间复杂度的算法且仅使用常量额外空间来解决此问题。
本题实际上已经在时间复杂度与空间复杂度做过.
思路:首先全部异或一遍,于是就把所有相同的数异或没了,然后想办法把这两个只出现过一次的数分开.
int val=0;
for(auto e:nums)
    val^=e;
异或的规则是相同为0,相异为1,我们可以找到val第一个为1的位,以该位是否为1将这组数据分为两组,这样就保证了这两个只出现一次的数据被分到两处,然后两边分别异或就可以分别得到这两个数据
class Solution {
public:
    vector<int> singleNumber(vector<int>& nums) {
        int val=0;
        for(auto e:nums)
            val^=e;
        int i=0;
        while(((val>>i)&1)!=1)
            i++;
        vector<int>ret;
        int ret1=0,ret2=0;
        for(auto e:nums)
        {
            if(((e>>i)&1)==0)
                ret1^=e;
            else
                ret2^=e;
        }
        ret.push_back(ret1);
        ret.push_back(ret2);
        return ret;
    }
};
杨辉三角
给定一个非负整数 numRows,生成「杨辉三角」的前 numRows 行。
在杨辉三角中,每个数是它左上方和右上方的数的和。
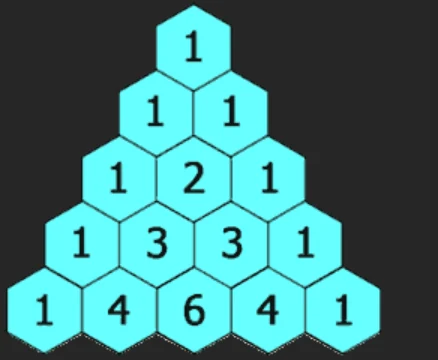
这里要用到
vector<vector<int>>这个东西类似于二维数组,相当于一张线性表里面存了很多个元素,这些元素又是另一张线性表,实际上就是广义表.
那么外层vector的大小肯定是numRows个,所以就要先开辟出5个vector,于是就会用到resize.
vector<vector<int>> vv;
vv.resize(numRows+1);
然后每个vector里面存了行数个数据,所以还要给每个vector开空间,并且每一个vector的第一个和最后一个都是1;
for(size_t i=0;i<numRows;i++)
{
    vv[i].resize(i+1);
    vv[i][0]=1;
    vv[i][vv[i].size()-1]=1
}
然后进行遍历,利用杨辉三角的特点可以得到
for(size_t i=0;i<vv.size();i++)
{
    for(size_t j=0;j<vv[i].size();j++)
    {
        if(vv[i][j]!=1)
	        vv[i][j]=vv[i-1][j]+vv[i-1][j-1];
        }
    }
    return vv;
}
最终得到完整代码
class Solution {
public:
    vector<vector<int>> generate(int numRows) {
        vector<vector<int>> vv;
        vv.resize(numRows);
        for(size_t i=0;i<numRows;i++)
        {
            vv[i].resize(i+1);
            vv[i][0]=1;
            vv[i][vv[i].size()-1]=1;
        }
        for(size_t i=0;i<vv.size();i++)
        {
            for(size_t j=0;j<vv[i].size();j++)
            {
                if(vv[i][j]!=1)
                    vv[i][j]=vv[i-1][j]+vv[i-1][j-1];
            }
        }
        return vv;
    }
};