STL
STL(standard template library)标准模板库,是C++标准库的重要组成部分,是一个主要包含了数据结构和算法的软件框架.
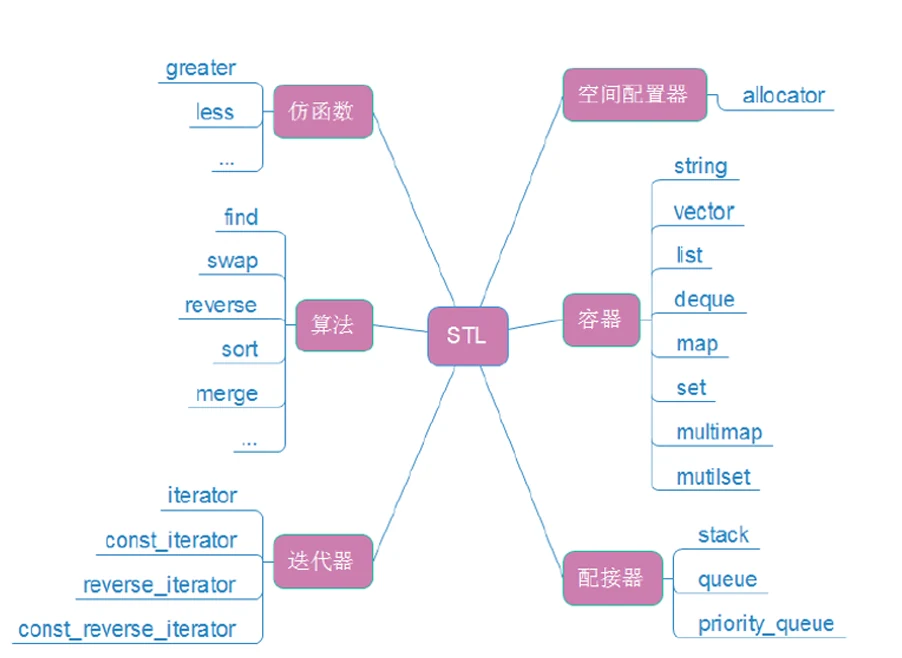
C语言中,string字符串是以\0结尾来标志着结束的,但是在C语言中,提供的库函数与字符串是分离的,导致操作极其不方便,而且底层空间需要自己进行管理,较为复杂.于是就有了string类.string类是一个管理字符串的数组,支持对字符串的”增删查改”.我们使用的string实际上是一个basic_string<char>的模板.
string的构造
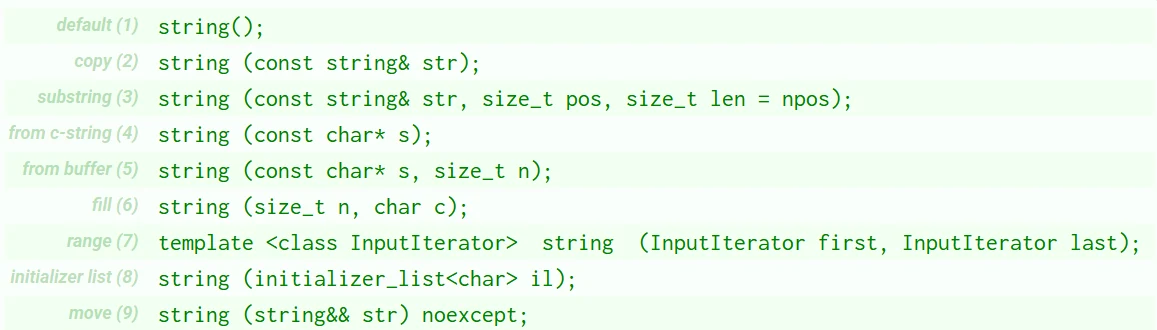
具体的使用见cplusplus.com/reference/string/string/string/
我们列出常见的几个
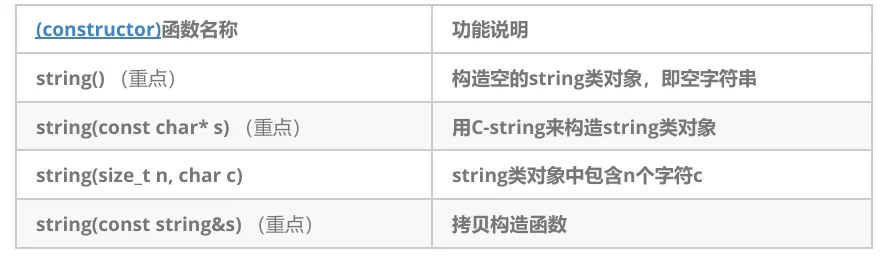
int main()
{
	string s1;
	string s2("hello");
	string s3(s2);//拷贝构造
	string s4(10,'a');//10个字符"a"
	string s5="hello";
	string s6=s5;
	string s7(s2,1,2);
	cout << s1 << endl;
	return 0;
}
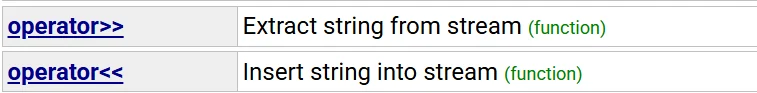
可以看到我们可以直接使用cout对字符串进行打印,原因是它的源码对”<<“和”>>”进行了重载类和对象
对于s5的构造,实际上也是在调用拷贝函数,他会先调用拷贝构造将这个字符串拷贝到临时对象,然后再用临时对象被拷贝构造s5,但是会被优化为直接调用构造函数.
对于s7的构造,使用了子串拷贝,拷贝了s2从第一个字符开始往后两个,也就是“el”。对于子串拷贝操作,它的len参数有一个缺省值npos。如果不传入参数或者传入的“len”大于了字符串的长度,都认为是传入了npos.npos的意义是指到字符串的结束.定义为
static const size_t npos=-1;由于是无符号整形类型,-1实际上是整形的最大值,所以传入npos一定能够将整个string读完.
string的容量操作
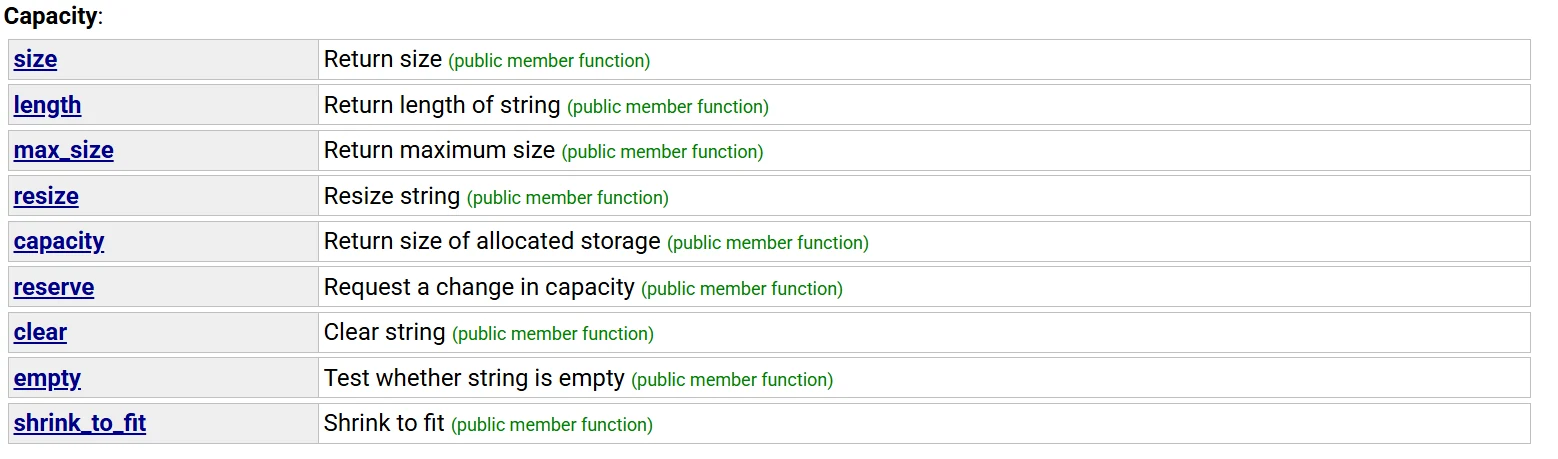
length() 和size() 返回字符串的长度,但是为什么会同时存在?对于字符串而言,size和length是没有区别的,但是对于其他数据结构,比如链表,树等等,用“长度”来刻画显然不再合适,所以改用size。
string还有个方法叫做max_size(),但是没有任何意义,返回值都是9223372036854775807(整形的最大值)
capacity:返回当前容量,会自动增容。增容是按倍数进行的,所以空间越大,一次增容的量就越大,增容的速度就会越慢。因为每次增容需要开辟空间,拷贝内容,然后释放原来的空间,这些步骤都是会消耗时间的,所以不能频繁地去增容,这也就是为什么自动增容通常是成倍数的。
clear用于清除字符的内容,但是不释放空间。
empty用于判断字符串是否为空。
int main()
{
	string s1("hello world");
	cout << s1.size() << endl;//11
	cout << s1.length() << endl;//11
	cout << s1.max_size() << endl;//9223372036854775807
	cout << s1.capacity() << endl;//15
	s1 += "111111";//追加后原来15的容量不够了,它会自动进行增容
	cout << s1.capacity() << endl;//31
	s1.clear();
	cout << s1.capacity() << endl;//31,说明clear不会释放内存
	cout << s1.empty() << endl;//1
	return 0;
}reserve定义为
void reserve (size_type n = 0);用于申请容量的改变。比如我已知我这段字符串最多会消耗100个空间,我可以
int main()
{
	string s1;
	s1.reserve(100);
	s1 = "hello world";
	cout << s1.capacity() << endl;//111
	s1.append(" 11111");
	cout << s1.capacity() << endl;//111
	return 0;
}
打印的结果是111,但实际上有112个空间,多的那个空间给\0.我设置的是100,但是为什么是111.原因是用reserve开辟空间的时候,会像结构体一样遵从特定的对齐规则
resize() 同样可以用于开辟空间,定义为
void resize (size_type n);
void resize (size_type n, charT c);
用于开辟长度为n的空间,并将这些空间填充为字符C.也就是说,使用resize改变的不仅仅是capacity,size也会发生改变
int main()
{
	string s1("hello world");
	s1.resize(100);
	cout << s1 << endl;//hello world
	cout << s1.capacity() << endl;//111
	cout << s1.size() << endl;//100
	return 0;
}

int main()
{
	string s1("hello world");
	s1.resize(100,'x');
	cout << s1 << endl;//hello worldxxxxx....
	cout << s1.capacity() << endl;//111
	cout << s1.size() << endl;//100
	return 0;
}
那么使用resize就会有多种情况了.如果resize的值小于字符串的初值,会将字符截断,即把size减小.如果再resize为20,现在的size是5,那么会再开辟出一段空间,并把6-20这块区域填上x
int main()
{
	string s1("hello world");
	s1.resize(5,'x');
	cout << s1 << endl;//hello
	cout << s1.capacity() << endl;//15
	cout << s1.size() << endl;//5
	s1.resize(20, 'x');
	cout << s1 << endl;//helloxxxxx...
	cout << s1.capacity() << endl;//15
	cout << s1.size() << endl;//5
	return 0;
}
resize和reserve的最大的区别在于是否改变string的size
string的遍历操作
operator[]
假设现在我要把字符串转为整形,我需要对其进行遍历,我们在上面提到的可以获取字符串的长度,并且由于其还对[]进行了重载,于是就可以实现遍历
int main()
{
	string s1("123456");
	int sum = 0;
	for (size_t i = 0; i < s1.size(); i++)
	{
		sum *= 10;
		sum += (s1[i]-'0');
	}
	return 0;
}
迭代器
遍历string除了使用[]的重载外,还可以使用迭代器.
int main()
{
	string s1("123456");
	int sum = 0;
	string::iterator it = s1.begin();
	while (it != s1.end())
	{
		cout << *it << " ";
		it++;
	}
	return 0;
}
其中iterator相当于定义在string里的一种类型.实际上每种容器都有自己的迭代器,所以应当指定使用的是在string类里的.
迭代器的使用非常类似于指针,但是实际上迭代器不一定是指针.s1.begin()返回首位置的迭代器(“1″位置),s1.end()返回末位置的迭代器(注意不是”6″位置,而是”6″位置的后一位);
使用迭代器的好处在于迁移性较好,所有容器都可以通过这种方式进行访问.
现在再利用迭代器实现我们的字符串转整形,我们传入的参数是const类型的,相比普通的迭代器来说,它是只读的,因此const也有专属的迭代器.
int string2int(const string& str)
{
	int val=0;
	//string::iterator it = str.begin();此处会报错,因为我们的数据是const类型的,必须创建const类型的迭代器.
	string::const_iterator it = str.begin();
	while (it != str.end())
	{
		val*=10;
		val+=(*it-'0');
		it++;
	}
	return val;
}
如果我们想要反着遍历,C++还为我们提供了反向迭代器
int main()
{
	string s1("123456");
	int sum = 0;
	string::reverse_iterator rit = s1.rbegin();
	while (rit != s1.rend())
	{
		cout << *rit << " ";
		rit++;
	}
	return 0;
}
此时begin变为rbegin,返回的位置变成了末位置(“6″位置)的迭代器;end变成rend,返回的是首位置的前一个位置的迭代器.
所以总的来说,迭代器有四种;从方向来区分为正向和反向,从属性的角度来区分为普通和const类型,两两组合为4种.
范围for
此外,还可以使用范围for去进行遍历C++入门
int main()
{
	string s1("123456");
	int sum = 0;
	for (auto ch1 : s1)
	{
		cout << ch1 << " ";
	}
	return 0;
}
范围for的底层原理实际上就是迭代器,也就是说这段代码会被替换成上面那一段代码.如果要对本身做修改,需要改为auto&
string对象的操作接口
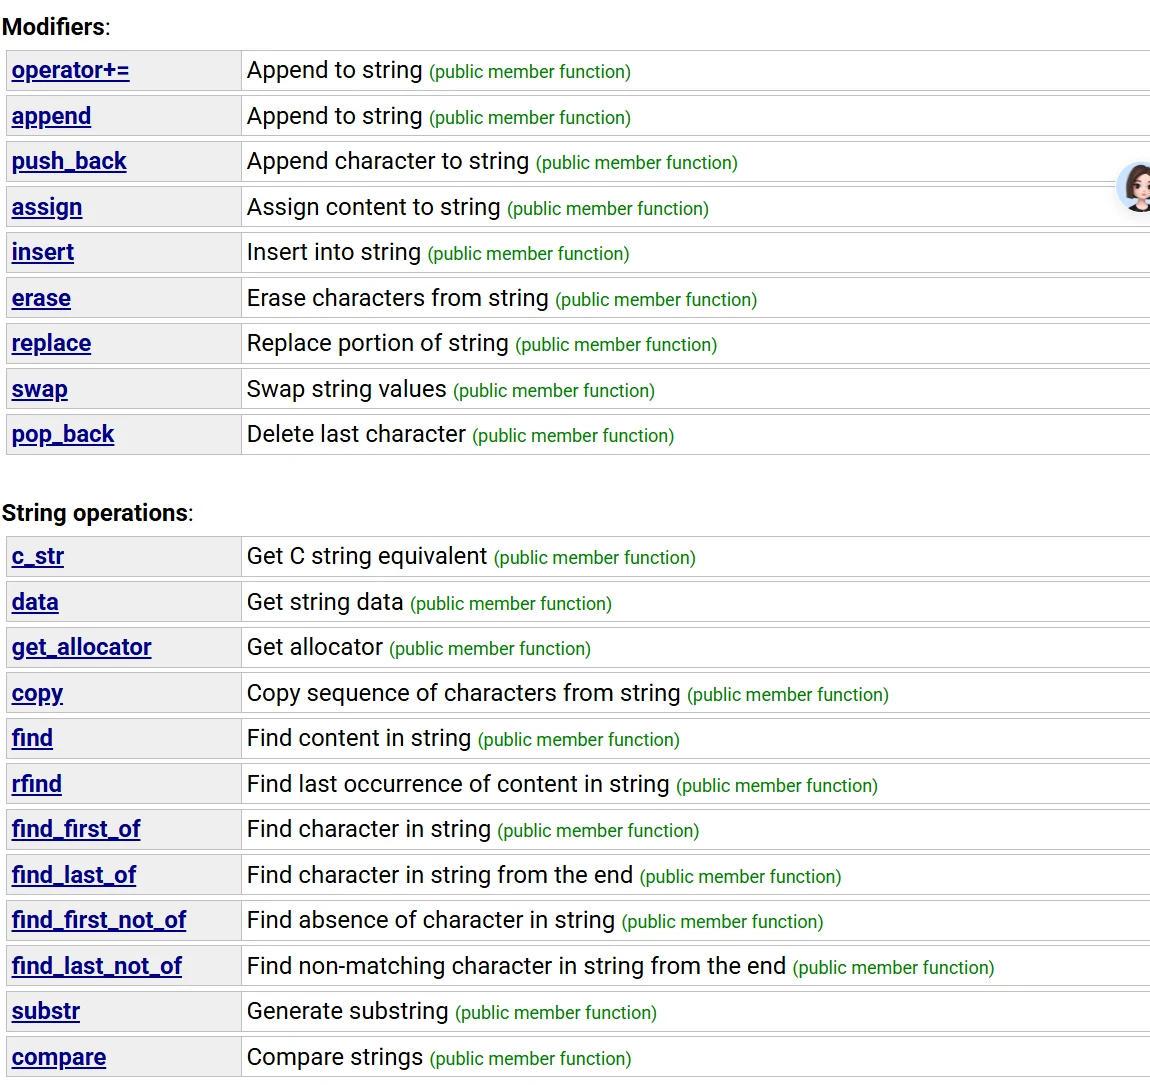
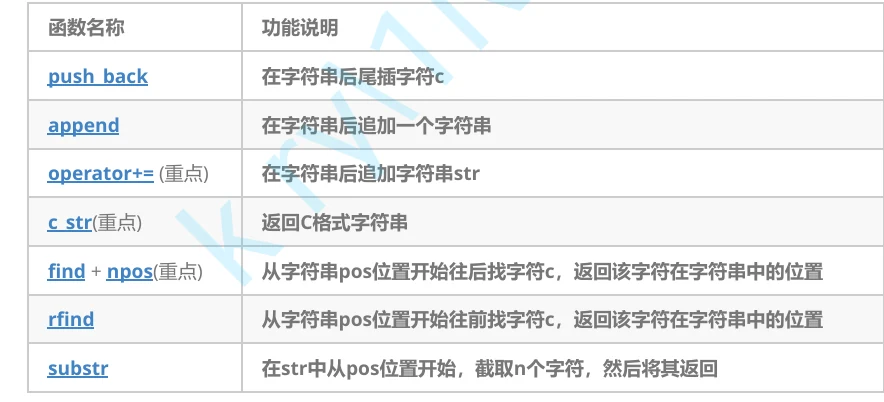
可见其提供了非常多的接口,我们选取一部分常用的操作.
int main()
{
	string s1("1234");
	s1.push_back('6');
	s1.append("78");
	s1 += "90";
	return 0;
}
增删
push_back是尾插一个字符,append是在末尾追加一个字符串.而 += 既可以追加一个字符,也可也追加一个字符串,相当前两个的结合版,使用更加方便.
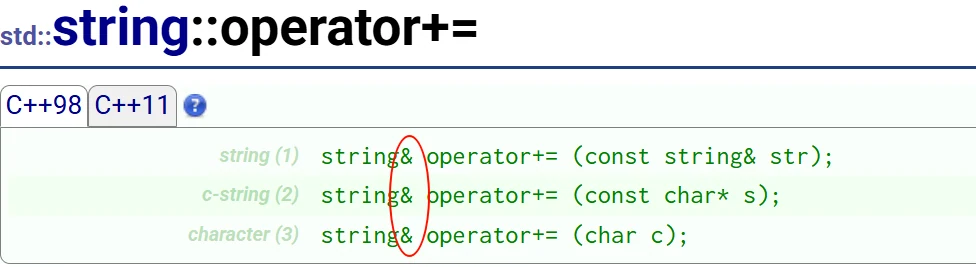
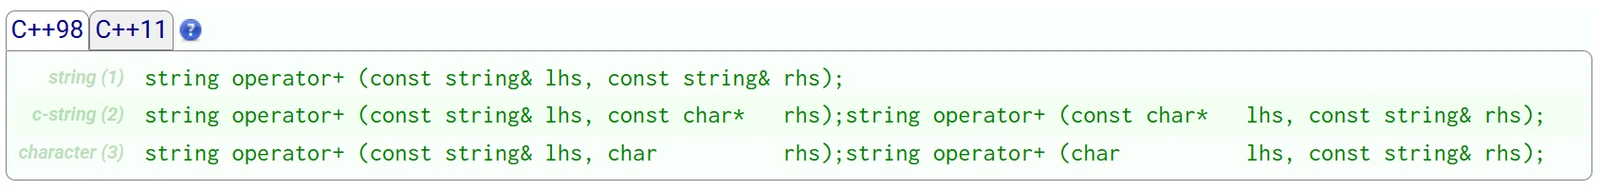
可以看到,+=的重载是通过引用返回的,于是就直接在原字符串上做了修改,而+是返回了一个string,对其本身不做修改
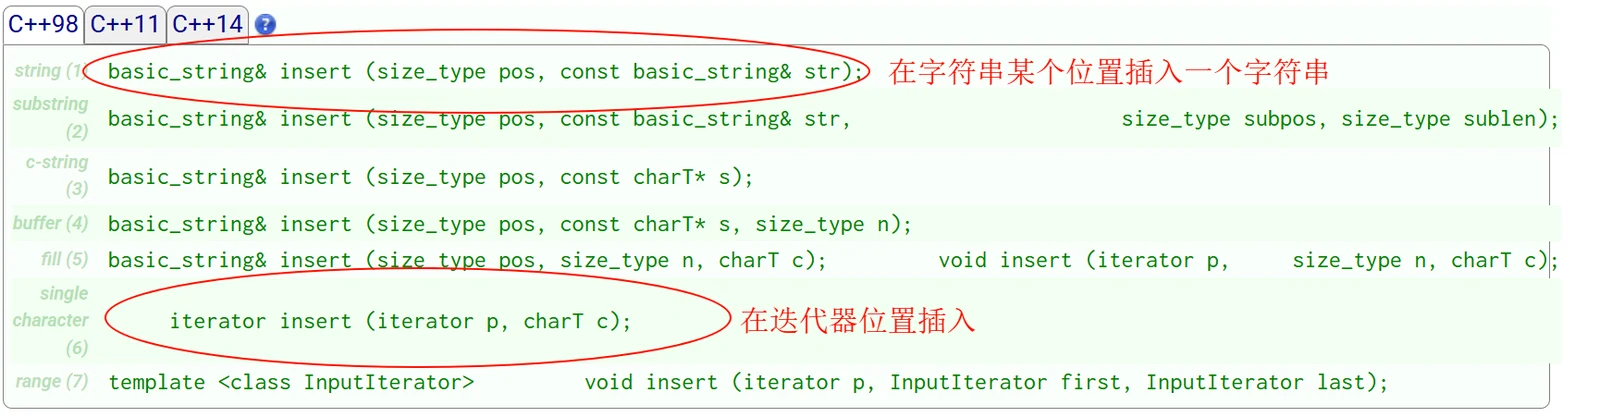
如果想在中间插入,可以调用insert
如果想要删除,可以调用erase
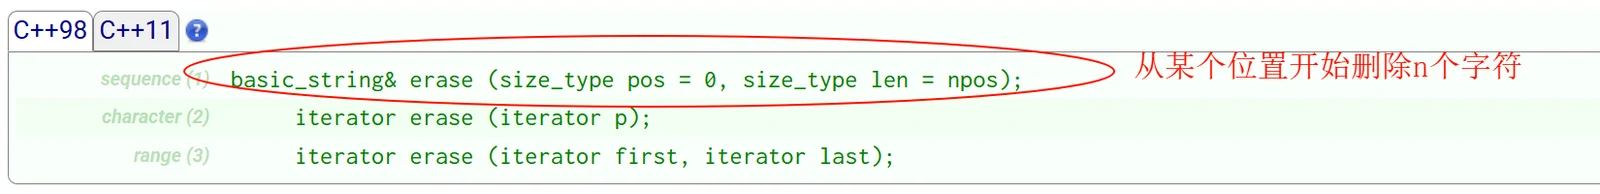
int main()
{
	string s1("hello world");
	string s2("hell world");
	s1.insert(s1.begin(), '0');
	cout << s1 << endl;
	s1.insert(2, s2);
	cout << s1 << endl;
	s1.erase(2, 10);
	cout << s1 << endl;
	return 0;
}
c_str
string提供了C的接口:c_str
定义如下:
const char* c_str() const;作用是返回一个C类型的字符串,也就是会返回一个指针,并且最后一位是’/0′,这样我们就可以按C语言的方式去遍历string,也可以调用strlen等操作
int main()
{
	string s2("hell world");
	const char* ch = s2.c_str();
	while (*ch)
	{
		cout<<*ch;
		ch++;
	}

	return 0;
}
现在来看这段代码
int main()
{
	string s2("hell world");
	s2 += '\0';
	s2 += "world";
	cout << s2 << endl;		   //hell world world
	cout << s2.c_str() << endl;//hell world
	return 0;
}
补充:字符是怎么打印的?
对于英文字符,采用ascii码进行编码,每一个码对应着一个字符.存储的时候存储ascii码,由于ascii和字符存在一一映射关系,所以打印的时候去查ascii码表就能正常打印.但是对于中文,255位的ascii码表远远不够,就出现了支持中文的编码–UTF-8,unicode,GBK编码等等.
如果只要编码常用汉字,实际上只需要使用两个字符就可以进行编码.一个字符有256种编码,两个字符就是\(256\times256\),这样就能编码大部分常用汉字了.但是现在计算机已经普及到了全世界,于是就出现了对全世界文字进行编码的编码表–Unicode.里面分为了UTF-8,UTF-16,UTF-32.里面的编码存在编码方式的差异.UTF-8代表以一个字节为最小单位,UTF-16代表以两个字节为最小单位,UTF-32则是以4个字节为最小单位.Linux下基本上使用UTF-8.后来中国又制定了另一套编码–GBK编码.
我们之所以可以直接用cout<<s2;是因为s2是string类型,是一个内置类型,其内部实现的时候已经对<<进行了重载.
getline
获取一行字符串
istream& getline (istream& is, string& str, char delim);
istream& getline (istream& is, string& str);
对于cin而言,遇到空格或者换行就直接结束了.所以如果字符串中本身就有空格就没法使用cin进行输入,就需要使用getline,使用方法如下
getline(cin,s)查
find:可以找:对象/字符串/字符,从pos开始
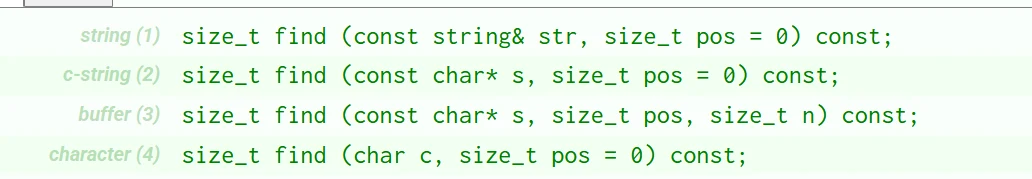
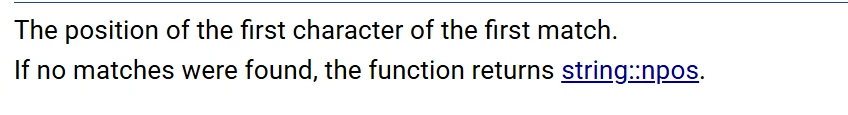
该函数返回了第一个找到的位置,如果没有找到就返回npos(一个极大值)
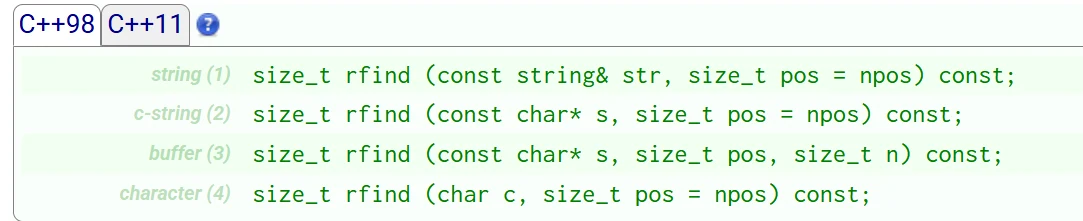
rfind:从pos位置开始往前找字符\字符串\对象
子串
substr:取字符串从pos开始长为len的子串
string substr (size_t pos = 0, size_t len = npos) const;利用这个两个接口可以实现对文件类型的识别.
int main()
{
	string s1("string.cpp");
	string s2("string.c");
	string s3("string.txt");
	size_t pos1=s1.find('.');
	if (pos1 != string::npos)
	{
		cout << s1.substr(pos1);
	}
	return 0;
}
但是有的时候会出现有连续后缀的东西,比如
1.tar.zip,如果我想取最后一个后缀,可以使用refind
如果我想找到所有后缀,我们可以先找到第一个位置,然后再从找到的第一个位置开始往下找第二个.
一个网址由协议 域名 资源名称构成
\(\underset{协议}{https}://\underset{域名}{cplusplus.com}/\underset{资源名称}{reference/string/string/rfind}\)
我们进入一个网站,做的第一件事必然是将协议,域名和资源名称分离开.这就可以通过我们的string类实现.
int main()
{
	string url("https://cplusplus.com/reference/string/string/rfind/");
	size_t i1 = url.find(':');
	if (i1 != string::npos)
	{
		cout << "协议是:" << url.substr(0, i1)<<endl;
	}
	size_t i2 = url.find('/', i1+3);//跳过://
	if (i2 != string::npos)
	{
		cout << "域名是:" << url.substr(i1+3, i2-i1-3)<<endl;
	}
	cout << "资源名称是:" << url.substr(i2);
	return 0;
}
string类的模拟实现
在模拟实现string时,遇到的第一个问题就是string这个类名和库函数重复了,这个时候就可以使用C++入门.
namespace feng
{
	class string
	{
	public:
	private:
		char* str;
		int _size;
		int _capacity;
	};
}
构造函数
构造函数考虑无参和含参
string()
	:_str(nullptr)
{}
string(char* str)
	:_str(str)
{}
但是这样写实际上是不行的.我在调用构造函数时肯定是
string("hello");但是会报错,原因是hello是常量字符串.传参的时候str是数组首元素地址,传入构造函数后str指向了”hello”的首元素.而”hello”作为常量字符串,是存储在代码段(常量区)的,因此无法被修改,也就是权限发生了扩大,因此会被编译器检查发生报错.
string在空间不够的时候还需要进行扩容后,所以需要动态开辟数组,那么这个数组就需要开到堆上内存管理.所以我们需要做的事情是把传进来的常量字符串拷贝到堆区.这样我们的构造函数就完成了
string()
	:_str(nullptr)
{}
string(const char* str)
	:_str(new char[strlen(str) + 1])//+1是为末尾的\0准备的
{
	strcpy(_str, str);
}
但是现在如果字符串是空字符串,我们一对它进行遍历就会崩溃,因为对象是个空指针.所以实际情况下,尽管是空字符串,它必须有一个\0
string()
	:_str(new char[1])
{
	_str[0] = '\0';
}
string(const char* str)
	:_str(new char[strlen(str) + 1])//+1是为末尾的\0准备的
{
	strcpy(_str, str);
}
为了编写的简便,我们可以合二为一写成全缺省形式
string(const char* str="")//缺省值没有任何有效字符,只有\0
	:_str(new char[strlen(str) + 1])
{
	strcpy(_str, str);
}
结合上我们的容量操作,最终构造函数变为
string(const char* str="")
{
	_size = strlen(str);
	_capacity = _size;
	_str = new char[_capacity + 1];//+1是为末尾的\0准备的
	strcpy(_str, str);
}
然后是拷贝构造,调用
string s2(s1);
cout << s1.c_str() << endl;
cout << s2.c_str() << endl;
发现正常打印了,但是程序却崩了.原因是我们并没有实现拷贝构造,所以这里调用的是而编译器自带的拷贝构造,而编译器自带的拷贝构造是浅拷贝类和对象,也就是说s2和s1指向了同一片空间,于是在程序结束后对同一片空间进行二次释放,程序就崩了.所以我们需要手动实现深拷贝,即自己开辟一块空间,然后指向这块空间.
string(const string& s)
{
	_size=strlen(s._str);
	_capacity=_size;
	_str=new char[_capacity + 1];
	strcpy(_str, s._str);
}
那么既然有拷贝构造,那么就要考虑赋值操作
string s3=s1这样同样是浅拷贝,因此需要对等号进行重载
string operator=(const string& s)
{
	_capacity=strlen(s._str);
	_size=_capacity;
	_str=new char[_capacity + 1];
	strcpy(_str, s._str);
	return *this;
}
但是这样写是存在内存泄漏的.我们在调用
string s3=s1时,首先是创建了s3,然后再把s1的值赋值给s3.在创建s3的时候s3已经指向了一块空间,而在代码中并没有对其进行释放,就导致了内存泄漏.
string& operator=(const string& s)
{
	_capacity=strlen(s._str);
	_size=_capacity;
	char* tmp= new char[_capacity + 1];
	strcpy(tmp, s._str);
	delete[] _str;
	_str = tmp;
	return *this;
}
为了防止自己给自己赋值,所以加一个判断
string& operator=(const string& s)
{
	if(this!=&s)
	{
		_capacity=strlen(s._str);
		_size=_capacity;
		char* tmp= new char[_capacity + 1];
		strcpy(tmp, s._str);
		delete[] _str;
		_str = tmp;
		return *this;
	}
}
析构函数
既然动态开辟了空间,析构函数就要对其进行释放
~string()
{
	delete[] _str;
	_str = nullptr;
	_size=_capacity=0;
}
容量操作
size(),返回字符串长度
size_t size() const
{
	return _size;
}capacity():返回容量
size_t capacity() const
{
	return _capacity;
}
reserve(int n):增容到n
void reserve(int n)
{
	char* tmp = new char[n + 1];
	strcpy(tmp, _str);
	delete[] _str;
	_str = tmp;
	_capacity = n;
}
resize(int n,char c):把size变为n,这样就会有三种情况,假设size是5,capacity是10,那么第一种情况:resize(8),增加了size,但是没有超过容量;第二种是resize(18),增加了size,且超过了容量.两种增加size的时候填入字符c,默认为”\0″.如果n<size,那么就直接在n的位置填\0即可.
void resize(int n,char ch='\0')
{
	if (n < _size)
	{
		_str[n] = '\0';
		_size = n;
	}
	else
	{
		if (n > _capacity)
		{
			reserve(n);
		}

		for (int i = _size; i < n; i++)
		{
			_str[i] = ch;
		}
		_size = n;
		_str[_size] = '\0';
	}
}
访问操作
[]访问
char& operator[](size_t i)
{
	assert(i < _size);
	return _str[i];
}
const char& operator[](size_t i) const
{
	assert(i < _size);
	return _str[i];
}
输出重载
ostream& operator<<(ostream& out, const string& s)
{
	for (size_t i; i < s.size(); i++)
	{
		cout << s[i];
	}
}
由于传入的s是const对象,在调用size()方法时需要调用对应const类型,所以在写size方法时需要用const修饰
输入重载
istream& operator>>(istream& in,string& s)
{

}迭代器:迭代器类似于指针,用于做遍历操作.
typedef char* iterator;
iterator begin()
{
	return _str;
}
iterator end()
{
	return _str + _size;
}
实现迭代器以后范围for就自动支持了,因为范围for是由迭代器实现的.也就是说
````col-md
```cpp
while (it2 != s2.end())
{
	cout << *it2 << " ";
	it2++;
}
````col-md
```cpp
for(auto e:s)
{
cout<<s<<" "
}后面这段代码会被替换为前面那一段
增删查改
尾插
void push_back(char ch);
void append(const char* ch);
要插入字符首先就需要考虑空间够不够,如果不够需要进行增容,当size=capacity时就说明需要增容
void push_back(char ch)
{
	//空间不足,进行扩容
	if (_size == _capacity)
	{
		size_t new_capacity = _capacity == 0 ? 2 : 2 * _capacity;
		char* tmp = new char[new_capacity + 1];
		strcpy(tmp, _str);
		delete[] _str;
		_str = tmp;
		_capacity = new_capacity;
	}
	_str[_size] = ch;
	_size++;
	_str[_size] = '\0';//完成后要在最后面放\0
}
void append(const char* ch)
{
	size_t len = strlen(ch);
	//扩容
	if (_size + len > _capacity)
	{
		size_t new_capacity = _size + len;
		char* tmp = new char[new_capacity + 1];
		strcpy(tmp, _str);
		delete[] _str;
		_str = tmp;
		_capacity = new_capacity;
	}
	strcpy(_str + _size, ch);
	_size += len;
	_str[_size] = '\0';//完成后要在最后面放\0
}
反复增容比较麻烦,我们可以给他封装成一个函数,见String,并且
void push_back(char ch)
{
	//空间不足,进行扩容
	if (_size == _capacity)
	{
		size_t new_capacity = _capacity == 0 ? 2 : 2 * _capacity;
		reserve(new_capacity);
	}
	_str[_size] = ch;
	_size++;
	_str[_size] = '\0';//完成后要在最后面放\0
}
void append(const char* ch)
{
	size_t len = strlen(ch);
	if (_size + len > _capacity)
	{
		size_t new_capacity = _size + len;
		reserve(new_capacity);
	}
	strcpy(_str + _size, ch);
	_size += len;
	_str[_size] = '\0';//完成后要在最后面放\0
}
然后是+=的重载,直接复用
string& operator+=(const char* ch)
{
	this->append(ch);
	return *this;
}
string& operator+=(char ch)
{
	this->push_back(ch);
	return *this;
}
插入,可以是字符,也可以是字符串
void insert(size_t pos,char ch)
{
	assert(pos < _size);
	if (_size == _capacity)
	{
		size_t newcapasity = _capacity == 0 ? 2 : 2 * _capacity;
		reserve(newcapasity);
	}
	for (int i = _size; i >= (int)pos; i--)
	{
		_str[i+1] = _str[i];
	}
	_str[pos] = ch;
	++_size;
}
void insert(size_t pos, const char* ch)
{
	assert(pos < _size);
	int len = strlen(ch);
	if (_size + len>=_capacity)
	{
		size_t newcapasity = _capacity = _size + len;
		reserve(newcapasity);
	}
	for (int i = _size; i >= (int)pos; i--)
	{
		_str[i + len] = _str[i];
	}
	memcpy(_str + pos, ch, len);
	_size+=len;
	_str[_size] = '\0';
}
为什么需要进行强转.原因是如果pos是0,那么当i减到-1的时候,由于pos是size_t类型,i会被隐式类型转换为size_t,那么-1对应的就是最大值,这样循环就永远都跳不出去了
完成插入的编写后,就可以复用到
void push_back(char ch)
{
	insert(_size,ch);
}
void append(const char* ch)
{
	_insert(_size,ch);
}
erase(int pos,int len=npos):删除pos后len个字符.那么有这几种情况,一个是正常删除,另一个是删的数量比pos后的数量大,最后一种是不传参,默认npos.如果超出数量,那就把后面删干净,在pos处填\0即可
void erase(int pos, int len = npos)
{
	assert(pos < _size);
	if (_size - pos <= len)
	{
		_size = pos;
		_str[pos] = '\0';
	}
	else
	{
		size_t i = pos + len;
		while (i <= _size)
		{
			_str[i - len] = _str[i];
			i++;
		}
		_size -= len;
		_str[_size] = '\0';
	}
}
find(char ch,size_t pos):从pos开始往后找ch
size_t find(char ch,int pos)
{
	for (int i = pos; i < _size; i++)
	{
		if (_str[i] == ch)
			return i;
	}
	return npos;
}
size_t find(const char* ch, int pos=0)
{
	char* p=strstr(_str + pos, ch);
	if (p == nullptr)
		return npos;
	else
		return p - _str;
}
其他接口
c_str:返回C类型的字符串
const char* c_str()
{
	return _str;
}
输入输出的重载
istream& operator>>(istream& in,string& s)
{
	while (1)
	{
		char ch;
		in >> ch;
		if (ch == ' ' || ch == '\n')
			break;
		else
			s += ch;
	}
	return in;
}
ostream& operator<<(ostream& out, const string& s)
{
	for (size_t i=0; i < s.size(); i++)
	{
		cout << s[i];
	}
	return out;
}但是输入的重载有问题,in>>ch是由系统实现的,当输入换行的时候>>会认为已经输入结束了,导致换行或者空格永远无法被接收到,最终进入死循环.所以在这里不能调用
//in>>ch,改为in.get()
istream& operator>>(istream& in,string& s)
{
	while (1)
	{
		char ch;
		ch=in.get();
		if (ch == ' ' || ch == '\n')
			break;
		else
			s += ch;
	}
	return in;
}getline():直接获取一行的输入,把空格判断删除就行
istream& getline(istream& in,string& s)
{
	while (1)
	{
		char ch;
		ch=in.get();
		if (ch == '\n')
			break;
		else
			s += ch;
	}
	return in;
}
代码汇总
using std::cout, std::cin, std::endl, std::ostream, std::istream;

namespace feng
{
	class string
	{
	public:
		typedef char* iterator;

		iterator begin()
		{
			return _str;
		}
		iterator end()
		{
			return _str + _size;
		}
		//构造函数
		string(const char* str="")
		{
			_size = strlen(str);
			_capacity = _size;
			_str = new char[_capacity + 1];//+1是为末尾的\0准备的
			strcpy(_str, str);
		}
		string(const string& s)
		{
			_size = strlen(s._str);
			_capacity = _size;
			_str = new char[_capacity + 1];
			strcpy(_str, s._str);
		}
		~string()
		{
			delete[] _str;
			_str = nullptr;
			_size = _capacity = 0;
		}
		string& operator=(const string& s)
		{
			if (this != &s)
			{
				_capacity = strlen(s._str);
				_size = _capacity;
				char* tmp = new char[_capacity + 1];
				strcpy(tmp, s._str);
				delete[] _str;
				_str = tmp;
			}
			return *this;
		}

		size_t size() const
		{
			return _size;
		}
		size_t capacity()
		{
			return _capacity;
		}
		void reserve(int n)
		{
			char* tmp = new char[n + 1];
			strcpy(tmp, _str);
			delete[] _str;
			_str = tmp;
			_capacity = n;
		}

		char& operator[](size_t i)
		{
			assert(i < _size);
			return _str[i];
		}
		const char& operator[](size_t i) const
		{
			assert(i < _size);
			return _str[i];
		}

		void push_back(char ch)
		{
			//空间不足,进行扩容
			if (_size == _capacity)
			{
				size_t new_capacity = _capacity == 0 ? 2 : 2 * _capacity;
				reserve(new_capacity);
			}
			_str[_size] = ch;
			_size++;
			_str[_size] = '\0';
		}
		void append(const char* ch)
		{
			size_t len = strlen(ch);
			if (_size + len > _capacity)
			{
				size_t new_capacity = _size + len;
				reserve(new_capacity);
			}
			strcpy(_str + _size, ch);
			_size += len;
			_str[_size] = '\0';
		}
		string& operator+=(const char* ch)
		{
			this->append(ch);
			return *this;
		}
		string& operator+=(char ch)
		{
			this->push_back(ch);
			return *this;
		}
		void insert(size_t pos,char ch)
		{
			assert(pos <= _size);
			if (_size == _capacity)
			{
				size_t newcapasity = _capacity == 0 ? 2 : 2 * _capacity;
				reserve(newcapasity);
			}
			for (int i = _size; i >= (int)pos; i--)
			{
				_str[i+1] = _str[i];
			}
			_str[pos] = ch;
			++_size;
		}
		void erase(int pos, int len = npos)
		{
			assert(pos < _size);
			if (_size - pos <= len)
			{
				_size = pos;
				_str[pos] = '\0';
			}
			else
			{
				size_t i = pos + len;
				while (i <= _size)
				{
					_str[i - len] = _str[i];
					i++;
				}
				_size -= len;
				_str[_size] = '\0';
			}
		}
		void insert(int pos, const char* ch)
		{
			assert(pos <= _size);
			int len = strlen(ch);
			if (_size + len>=_capacity)
			{
				size_t newcapasity = _capacity = _size + len;
				reserve(newcapasity);
			}
			for (int i = _size; i >= (int)pos; i--)
			{
				_str[i + len] = _str[i];
			}
			memcpy(_str + pos, ch, len);
			_size+=len;
			_str[_size] = '\0';
		}
		void resize(int n,char ch='\0')
		{
			if (n < _size)
			{
				_str[n] = '\0';
				_size = n;
			}
			else
			{
				if (n > _capacity)
				{
					reserve(n);
				}

				for (int i = _size; i < n; i++)
				{
					_str[i] = ch;
				}
				_size = n;
				_str[_size] = '\0';
			}
		}
		size_t find(char ch,int pos)
		{
			for (int i = pos; i < _size; i++)
			{
				if (_str[i] == ch)
					return i;
			}
			return npos;
		}
		size_t find(const char* ch, int pos=0)
		{
			char* p=strstr(_str + pos, ch);
			if (p == nullptr)
				return npos;
			else
				return p - _str;
		}


		const char* c_str()
		{
			return _str;
		}
	private:
		char* _str;
		int _size;
		int _capacity;
		static size_t npos;
	};
	size_t string::npos = -1;
	ostream& operator<<(ostream& out, const string& s)
	{
		for (size_t i=0; i < s.size(); i++)
		{
			cout << s[i];
		}
		return out;
	}
	istream& operator>>(istream& in,string& s)
	{
		while (1)
		{
			char ch;
			ch = in.get();
			if (ch == ' ' || ch == '\n')
			{
				break;
			}
			else
			{
				s += ch;
			}
		}
		return in;
	}
	istream& getline(istream& in, string& s)
	{
		while (1)
		{
			char ch;
			ch = in.get();
			if (ch == '\n')
				break;
			else
				s += ch;
		}
		return in;
	}
}
深拷贝的现代写法
我们之前写的深拷贝是我开一个和对方一样大的空间,然后把对方的内容复制到我开辟的新空间
string(const char* str="")
	:_str(new char[strlen(str) + 1])//+1是为末尾的\0准备的
{
	strcpy(_str, str);
}
//拷贝构造深拷贝的传统写法
string(const string& s)
{
	_size=strlen(s._str);
	_capacity=_size;
	_str=new char[_capacity + 1];
	strcpy(_str, s._str);
}
//拷贝构造深拷贝的现代写法
string(const string& s)
	:_str(nullptr)
{
	string tmp(s._str);
	swap(_str,tmp._str);
}
它的思路是:创建一个tmp,将s._str传给tmp进行构造,然后用交换函数把tmp._str交换给_str.然后tmp是个临时变量,出作用域后就被释放.
这样的写法在拷贝构造上看不出多大区别,但是在赋值上就很方便
//传统写法
string& operator=(const string& s)
{
	if (this != &s)
	{
		_capacity = strlen(s._str);
		_size = _capacity;
		char* tmp = new char[_capacity + 1];
		strcpy(tmp, s._str);
		delete[] _str;
		_str = tmp;
	}
	return *this;
}
//现代写法
string& operator=(const string& s)
{
	if (this != &s)
	{
		string tmp(s);
		swap(_str,tmp._str);
	}
	return *this;
}
//简化:
string& operator=(string s)
{
	swap(_str,s._str);
	return *this;
}
//这里是传值调用,外界传进来一个string后,会调用构造函数构造临时变量s,s是外部传入字符串的深拷贝,然后将其数组和_str进行交换,出作用域后s被释放,这样就完成了赋值.
对于一个真实的string类,其成员还包含capacity和size,那么swap的时候这三个就要一起交换.
string(const string& s)
	:_str(nullptr),_size(0),_capacity(0)
{
	string tmp(s._str);
	this->swap(tmp);
}
void swap(const string& s)
{
	::swap(_str,s._str);
	::swap(_size,s._size);
	::swap(_capacity,s._capacity);
}
由于库函数内有swap,我自己也定义了swap,如果直接调用会优先调用我自己定义的swap,所以需要加上域限定符说明我是调用的库函数中全局的swap.
题目
翻转一个字符串
给你一个字符串,根据下述规则反转字符串:
所有非英文字母保留在原有位置。·所有英文字母(小写或大写)位置反转。返回反转后的 s。
输入: s = “ab-cd”
输出:“dc-ba”
思路:左右各走一个指针,如果两个指针都指向字符就交换,否则就分别往下走.这个思路和快排非常类似
class Solution {
public:
    bool isChar(char ch)
    {
        if((ch>='a'&& ch<='z')||(ch>='A'&&ch<='Z'))
            return true;
        else
            return false;
    }
    string reverseOnlyLetters(string s) {
        int begin=0;
        int end=s.size()-1;
        while(begin<end)
        {
            while(begin<end&&isChar(s[begin])==false)
            {
                begin++;
            }
            while(begin<end&&isChar(s[end])==false)
            {
                end--;
            }
            swap(s[begin],s[end]);//c++已经提供了swap函数,利用了模板进行实现
            begin++;
            end--;
            //交换完了要再移动一次,否则会陷入循环
        }
        return s;
    }
};
找单
给定一个字符串 s,找到它的第一个不重复的字符,并返回它的索引 。如果不存在,则返回 -1。
示例:
输入: s = “leetcode”
输出: 0
思路:
1.暴力搜索,锁定一个字符,去遍历字符串找有没有重复过,时间复杂度\(O(N^2)\)
class Solution {
public:
    int firstUniqChar(string s) {
        int ret=0;
        int isUnique=1;
        while(ret<s.size())
        {
            for(int i=0;i<s.size();i++)
            {
                isUnique=1;
                if(i==ret)
                {
                    continue;
                }
                if(s[ret]==s[i])
                {
                    isUnique=0;
                    ret++;
                    break;
                }
            }
            if(isUnique)
            {
                return ret;
            }
        }
        return -1;
    }
};
2.创建一个26长度的数组,遍历一遍字符串,让每个字符转为数字后对应数组的下标,然后在对应位置+1,(这样如果出现重复,对应位置大小大于1,如果只出现一次,值就是1).然后去找数组中首个值为1的位置.时间复杂度\(O(N)\)
class Solution {
public:
    int firstUniqChar(string s) {
        int count[26] = {0};
        for(char ch : s){
            count[ch - 'a']++;
        }
        for(int i = 0; i < s.size(); i++){
            if(count[s[i] - 'a'] == 1){
                return i;
            }
        }
        return -1;
    }
};
这种思想与计数排序类似,本质上是哈希的思想.
最后单词长度
对于给定的若干个单词组成的句子,每个单词均由大小写字母混合构成,单词间使用单个空格分隔。输出最后一个单词的长度。
思路:利用rfind()去找最后一个空格所在位置,然后用s.size()去减去找到的位置就可以算出最后那个单词的长度.
int main() {
    string s;
    while (cin >> s) { // 注意 while 处理多个 case
        size_t pos = s.rfind(' ');
        cout << s.size() - (pos+1)<<endl;
    }
}
但是输出并不对.
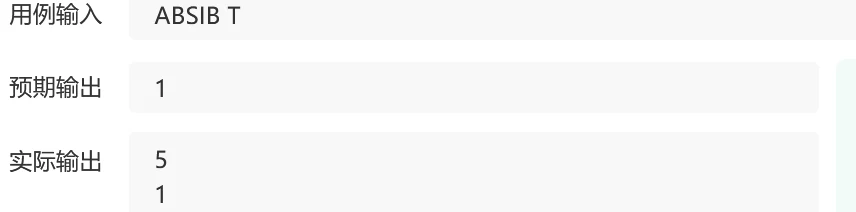
进入调试我们发现” T”消失了.

所以说:cin()天生要求接收的数据遇到空格或者换行就结束了.这种时候就不能用cin了,而是用getline
int main() {
    string s;
    while (getline(cin,s)) { // 注意 while 处理多个 case
        size_t pos = s.rfind(' ');
        cout << s.size() - (pos+1)<<endl;
    }
}
回文
如果在将所有大写字符转换为小写字符、并移除所有非字母数字字符之后,短语正着读和反着读都一样。则可以认为该短语是一个回文串 。
输入:s = “A man, a plan, a canal: Panama”
输出:true
解释:”amanaplanacanalpanama” 是回文串。
思路:先把字符串全部转为小写,然后再判断回文.
class Solution {
public:
	bool isCharOrNumber(char ch)
	{
		if((ch>='a' && ch<='z')||(ch>='0' && ch<='9'))
		{
			return true;
		}
		else
			return false;
	}
    bool isPalindrome(string s) {
        //全部转成小写
        for(auto &ch:s)//由于需要对字符串做修改,需要ch是s的引用
        {
	        if(ch>='A' && ch<='Z')
		        ch+=32;
        }
        int begin=0,end=s.size()-1;
        while(begin<end)
        {
	        while(begin<end&&!isCharOrNumber(s[begin]))
		        begin++;
		    while(begin<end&&!isCharOrNumber(s[end]))
		        end--;
		    //这里begin++和end--很有可能会溢出,所以要多个条件

		    if(s[begin]!=s[end])
		    {
			    return false;
		    }
		    else
		    {
			    begin++;
			    end--;
		    }
        }
        return true;
    }
};
字符串相加
给定两个字符串形式的非负整数 num1 和num2 ,计算它们的和并同样以字符串形式返回。
你不能使用任何內建的用于处理大整数的库(比如 BigInteger), 也不能直接将输入的字符串转换为整数形式。
使用进位法进行相加.每一次相加的数据实际上是数据1+数据2+进位
class Solution {
public:
    string addStrings(string num1, string num2) {
        int end1 = num1.size() - 1, end2 = num2.size() - 1;
        int next = 0;//进位
        string retstr;
        while (end1 >= 0 || end2 >= 0)
        {
            int val1 = 0, val2 = 0;
            if (end1 >= 0)
                val1 = num1[end1]-'0';
            if (end2 >= 0)
                val2 = num2[end2]-'0';
            int ret = val1 + val2 + next;
            if (ret > 9)
            {
                ret -= 10;
                next = 1;
            }
            else
            {
                next = 0;
            }
            //retstr+=(ret+'0');//尾插需要进行逆置
            retstr.insert(retstr.begin(),ret + '0');
            end1--;
            end2--;
        }
        if (next == 1)
        {
            retstr.insert(retstr.begin(), '1');
        }
        return retstr;
    }
};
但是这样做效率极低,insert调用头插需要不断的移动数组的数据,位数越大移动越多,数量级是\(N^2\).另一种方法是就进行尾插,尾插完成后进行翻转,复杂度就是\(O(N)\)了
while (begin < end)
{
    swap(ret[begin], ret[end]);
    begin++;
    end--;
}
//或者
reverse(retstr.begin(), retstr.end());
字符串相乘
**给定两个以字符串形式表示的非负整数 num1 和 num2,返回 num1 和 num2 的乘积,它们的乘积也表示为字符串形式。
注意:不能使用任何内置的 BigInteger 库或直接将输入转换为整数。**
思路:1234×567可以写为1234x(500+60+7).
class Solution {
public:
    string addStrings(string num1, string num2) {
        int end1 = num1.size() - 1, end2 = num2.size() - 1;
        int next = 0;//进位
        string retstr;
        while (end1 >= 0 || end2 >= 0)
        {
            int val1 = 0, val2 = 0;
            if (end1 >= 0)
                val1 = num1[end1] - '0';
            if (end2 >= 0)
                val2 = num2[end2] - '0';
            int ret = val1 + val2 + next;
            if (ret > 9)
            {
                ret -= 10;
                next = 1;
            }
            else
            {
                next = 0;
            }
            retstr+=(ret + '0');
            end1--;
            end2--;
        }
        if (next == 1)
        {
            retstr+='1';
        }
        reverse(retstr.begin(), retstr.end());
        return retstr;
    }
    string multiply(string num1, string num2) {
        int sz1 = num1.size();
        int sz2 = num2.size();
        int next = 0;
        string ret="0";
        for (int i = 0; i <sz1; i++)
        {
            string result;
            for (int j = sz2-1; j >= 0; j--)
            {
                int val1 = num1[i] - '0';
                int val2 = num2[j] - '0';
                int val = val1 * val2+next;
                if (val > 9)
                {
                    next = val / 10;
                    val %= 10;
                    result+=(val+'0');
                }
                else
                {
                    result+=(val+'0');
                    next = 0;
                }
            }
            if (next != 0)
            {
                result+=( next + '0');
                next = 0;
            }
            reverse(result.begin(), result.end());
            ret=addStrings(ret, result);
            if(i!=sz1-1)
             ret += '0';
        }
        while (ret[0] == '0'&& ret.size()>1)
        {
            ret.erase(0, 1);
        }
        return ret;
    }
};
而另一种思路是:1234×567可以视为1234+1234+…一直加567次
//另一种方式
string multiply(string num1, string num2) {
	string i("0");
	string one("1");
	string ret("0");
	while(i!=num1)
	{
		i=addStrings(i,one);
		ret=addStrings(ret,num2);
	}
}
思路很简单,但是由于频繁的拷贝,性能非常的差.可以想办法进行优化.