栈和队列被称为容器适配器,实际上栈和队列是通过容器进行转换出来的,具体会在模拟实现中介绍.
栈
栈的接口一共就这么几个
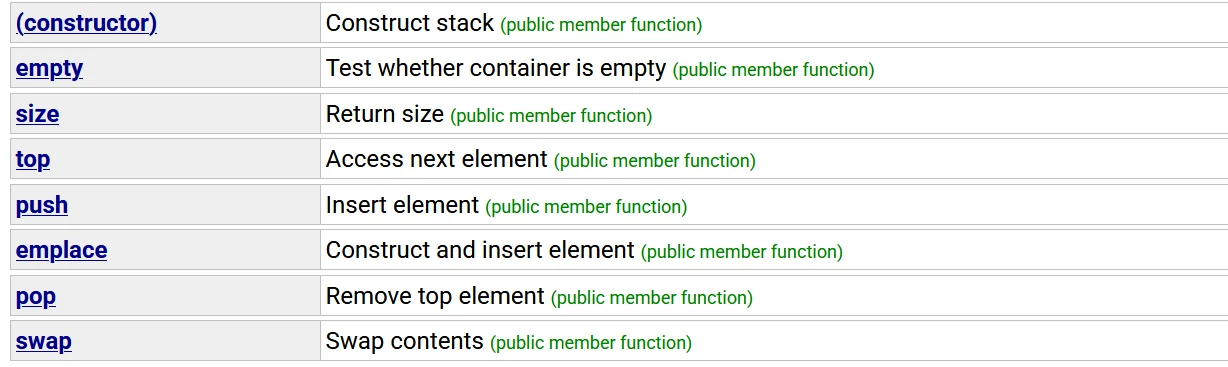
满足LIFO(last in first out).并且对于栈来说,只会允许访问栈顶的数据,所以栈不存在迭代器.如果要遍历这个栈,只能取top,然后出栈,直到整个栈为空
void test_stack()
{
    stack<int> st;
    st.push(1);
    st.push(2);
    st.push(3);
    st.push(4);
    st.push(5);
    while (!st.empty())
    {
        cout << st.top() << " ";
        st.pop();
    }
}
栈的模拟实现
栈的底层是线性表还是链表?实际上都可以,栈作为容器适配器,它只要能够满足尾插尾删,就都可以达到我们所需要的效果.
template<class T,class Container>
class stack {
public:
	void push(const T& x) {
		_con.push_back(x);
	}
	void pop()
	{
		_con.pop_back();
	}
	size_t size()
	{
		return _con.size();
	}
	bool empty()
	{
		return _con.empty();
	}
	T& top()
	{
		return _con.back();
	}
private:
	Container _con;
}至于模板中的Container,它是什么并不重要,它既可以适配数组,又可以适配链表
void test_mystack()
{
	stack<int, vector<int>> st;
	st.push(1);
	st.push(2);
	st.push(3);
	st.push(4);
	while (!st.empty())
	{
		cout << st.top() << " ";
		st.pop();
	}
}
练习
最小栈
设计一个支持 push ,pop ,top 操作,并能在常数时间内检索到最小元素的栈。
实现 MinStack 类:
MinStack()初始化堆栈对象。void push(int val)将元素val推入堆栈。void pop()删除堆栈顶部的元素。int top()获取堆栈顶部的元素。int getMin()获取堆栈中的最小元素。
如果要实现最小值的存储,我们需要两个栈,一个栈存原来的数据,一个栈存最小的数据.
所以思路是:如果新入栈的元素比上一个最小的元素小,就同时入到两个栈.那么对于存最小元素的那个栈来说,栈顶就是那个最小的元素.如果出栈的时候,出栈的元素和存最小值的栈的栈顶元素相同,那么就两个一起出栈.
比如:
\[\begin{aligned}st:(2,3,1,5) \\min\_st(2,1)\end{aligned}\rightarrow \begin{aligned}st:(2,3,1) \\min\_st(2,1)\end{aligned}\rightarrow \begin{aligned}st:(2,3) \\min\_st(2)\end{aligned}\]
#include <stack>
class MinStack {
    stack<int> st;
    stack<int> min_st;
public:
    MinStack() {
    }
    void push(int val) {
        st.push(val);
        if(min_st.empty()||val<=min_st.top())//这里必须是小于等于,不然如果我同时入两个最小值只会存入一个,导致最小值错误或者getmin一个空栈导致报错.
            min_st.push(val);
    }
    void pop() {
        if(st.top()==min_st.top())
            min_st.pop();
        st.pop();
    }
    int top() {
        return st.top();
    }
    int getMin() {
        return min_st.top();
    }
};
栈的压入与弹出
输入两个整数序列,第一个序列表示栈的压入顺序,请判断第二个序列是否可能为该栈的弹出顺序。假设压入栈的所有数字均不相等。例如序列1,2,3,4,5是某栈的压入顺序,序列4,5,3,2,1是该压栈序列对应的一个弹出序列,但4,3,5,1,2就不可能是该压栈序列的弹出序列。
思路:利用栈去模拟进出.当我先把数据入栈,如果栈顶的数据与出栈的vector相同时,就出栈,然后vector指向下一个数据.如果最后栈内的数据全部出完了,就说明这个出栈顺序是合法的,否则就不合法.
class Solution {
public:
    bool IsPopOrder(vector<int>& pushV, vector<int>& popV) {
        // write code here
        stack<int> st;
        int pushi=0,popi=0;

        while(pushi<pushV.size())
        {
            st.push(pushV[pushi]);
            pushi++;
            while((!st.empty())&&st.top()==popV[popi])
            {
                st.pop();
                popi++;
            }
        }
        return st.empty();
    }
};
逆波兰表达式
给你一个字符串数组 tokens ,表示一个根据 逆波兰表示法 表示的算术表达式。
请你计算该表达式。返回一个表示表达式值的整数,逆波兰表达式是一种后缀表达式,所谓后缀就是指算符写在后面。
- 平常使用的算式则是一种中缀表达式,如
( 1 + 2 ) * ( 3 + 4 )。 - 该算式的逆波兰表达式写法为
( ( 1 2 + ) ( 3 4 + ) * )。
注意:
- 有效的算符为
'+'、'-'、'*'和'/'。 - 每个操作数(运算对象)都可以是一个整数或者另一个表达式。
- 两个整数之间的除法总是 向零截断 。
- 表达式中不含除零运算。
- 输入是一个根据逆波兰表示法表示的算术表达式。
- 答案及所有中间计算结果可以用 32 位 整数表示。
思路:中缀表达式的操作符移到了操作数的后面,所以我们应当遇到操作符后再进行处理.所以我们可以利用栈,遇到操作数就入栈,遇到符号后再出栈取出操作数.取出操作数完成运算后再入栈,并重复上述过程
这个题目里面需要字符串转整形和整形转字符串,调用
stoi();//字符串转整形
to_string();//转为字符串
代码如下
class Solution {
public:
    int evalRPN(vector<string>& tokens) {
        stack<int> st;
        for(auto str:tokens)
        {
            //如果是操作符,取数据进行运算
            if(str=="+" || str=="-" || str=="*" || str=="/")
            {
                int right=st.top();//先取出的是右操作数
                st.pop();
                int left=st.top();
                st.pop();
                //进行运算,由于switch不允许自定义类型,我们取一个字符(实际上运算符就是只有一个字符)
                switch(str[0])
                {
                    case '+':st.push(left+right); break;
                    case '-':st.push(left-right); break;
                    case '*':st.push(left*right); break;
                    case '/':st.push(left/right); break;
                }
            }
            //如果是操作数,入栈
            else
            {
                st.push(stoi(str));
            }
        }
        return st.top();
    }
};
中缀表达式如何转后缀呢?遍历,遇到操作数就输出,遇到操作符和上一个操作符比较,如果计算优先级更高就入栈,优先级更低就让其先出栈,然后重新比较.当遍历完后把栈内的操作符全部输出
e.g
\[\begin{aligned}&4+13/5*6-7\\&st:\\&out:\end{aligned}\rightarrow \begin{aligned}&13/5*6-7\\&st:+\\&out:4\end{aligned}\rightarrow \begin{aligned}&5*6-7\\&st:+\quad /\\&out:4\quad 13\end{aligned}\rightarrow \begin{aligned}&6-7\\&st:+\quad *\\&out:4\quad 13\quad 5/\end{aligned}\rightarrow \begin{aligned}&7\\&st:+\quad -\\&out:4\quad 13\quad 5/6*\end{aligned}\rightarrow \begin{aligned}&\\&st:\\&out:4\quad 13\quad 5/6*7-+\end{aligned}\]
队列
队列的接口也只有这几个,只能是队尾进队头出,所以也没有迭代器
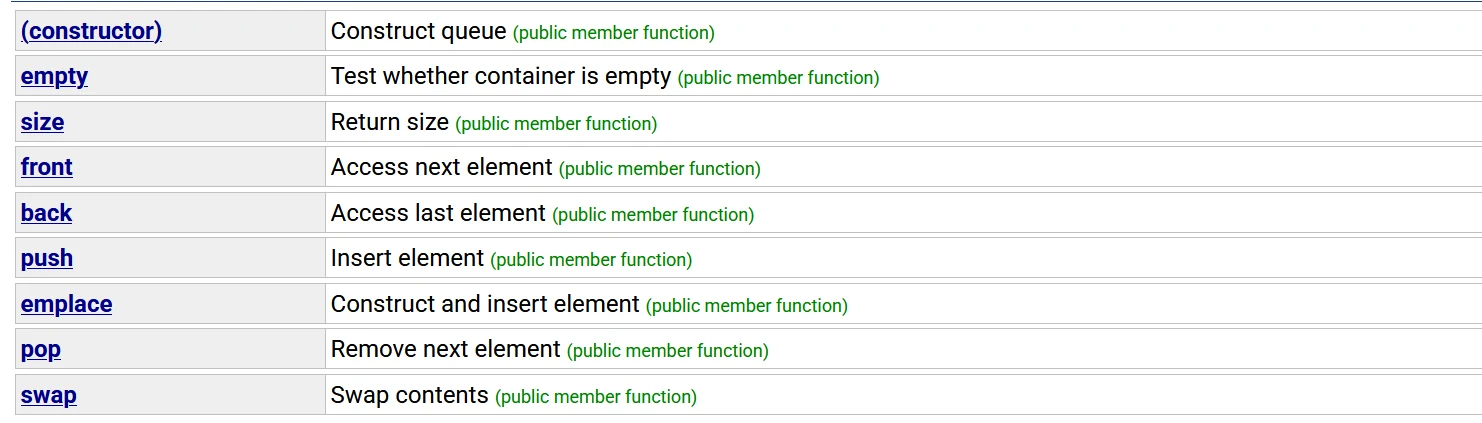
如果要遍历这个队列,只能每次获取队头的元素,然后出队列
void test_queue()
{
    queue<int> q;
    q.push(1);
    q.push(2);
    q.push(3);
    q.push(4);
    q.push(5);
    while (!q.empty())
    {
        cout << q.front() << " ";
        q.pop();
    }
}
队列的模拟实现
队列也是容器适配器,与栈的实现完全相似
namespace Queue {
	template<class T, class Container>
	class queue {
	public:
		void push(const T& x) {
			_con.push_back(x);
		}
		void pop()
		{
			_con.pop_front();
		}
		size_t size()
		{
			return _con.size();
		}
		bool empty()
		{
			return _con.empty();
		}
		T& front()
		{
			return _con.front();
		}
		T& back()
		{
			return _con.back();
		}
	private:
		Container _con;
	};
}但是需要注意的是,queue是尾入头删,由于vector没有头删的接口,所以队列只能适配list
void test_myqueue()
{
	queue<int, list<int>> q;
	q.push(1);
	q.push(2);
	q.push(3);
	q.push(4);
	while (!q.empty())
	{
		cout << q.front() << " ";
		q.pop();
	}
}
deque
但是我们在库中使用stack和queue的时候并没有传入容器这个参数,那么库底下用的是什么作为适配呢?答案是标准库传入了一个缺省参数:deque-双端队列.它虽然名字叫双端队列,但是实际上它不是一个队列,并不满足先进先出,它的实现是两端均可进行操作的容器,并且支持随机访问.
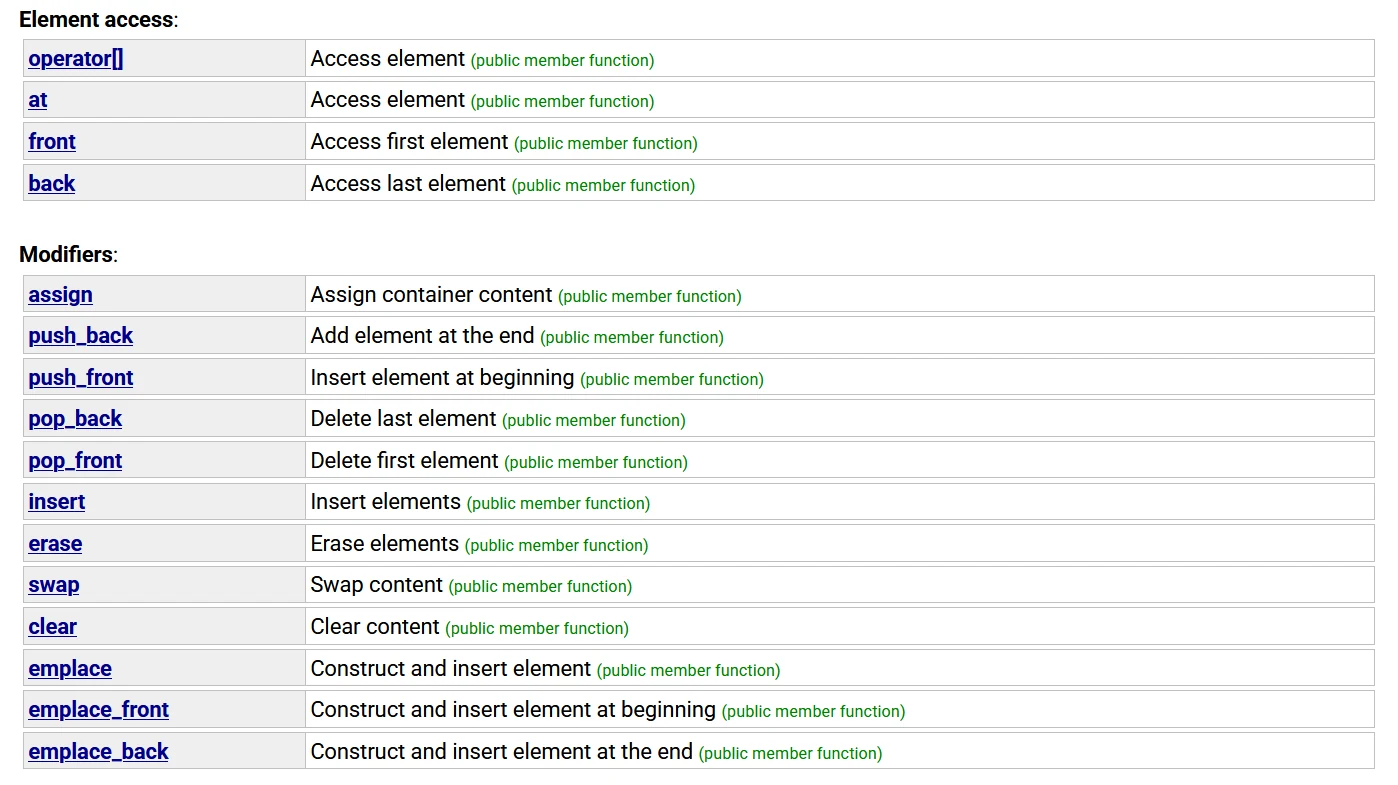
也就是说它是vector和list的融合.vector的优点是随机访问,list的优点是\(O(1)\)的插入删除,deque把这两个的优点结合到了一起,但是对两个优点都打了折扣.它最大的缺点在于随机访问的效率不够高,这会导致在进行排序的时候速度不够.
那为什么栈和队列的适配会使用它?因为栈和队列都不涉及随机访问,并没有涉及到它的缺点
它的实现是由多段buffer组成而成.
对于数组而言,空间不够需要进行增容,头部插入需要挪动数据
对于链表而言,不支持随机访问.
现在我们开小段小段的数组,满了以后不进行增容,而是再开一个小数组,这样就没有增容问题.
然后进行头插头删时对数据的挪动问题.对于头删而言,它允许直接进行删除.如果是头插,就在头上再开一个小数组,然后从数组最后一位进行插入.
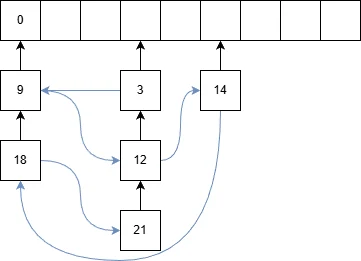
那么如何管理多个小数组呢?或者说:随机访问是怎么支持的?
通过中控映射进行管理,利用一个指针数组存储所有buffer的指针.首个buffer会被存入指针数组的中间部位,便于处理前插和后插
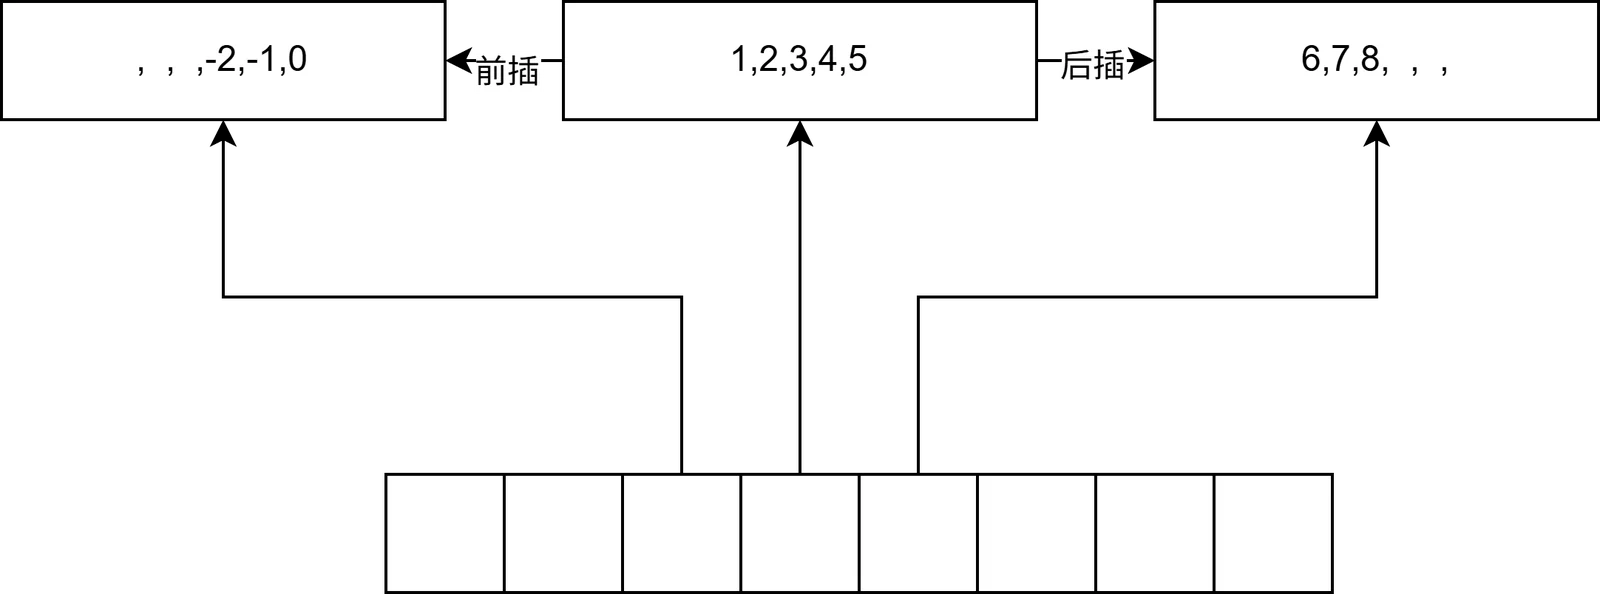
那么这个指针数组肯定是需要进行增容的,但是增容不再需要动每一个buffer的数据,这样代价就大大减小了.
那么operator[]的实现就需要依次计算目标数据是在哪一个buffer内,这样就导致随机访问的效率变低了.
deque的迭代器一共有四个指针
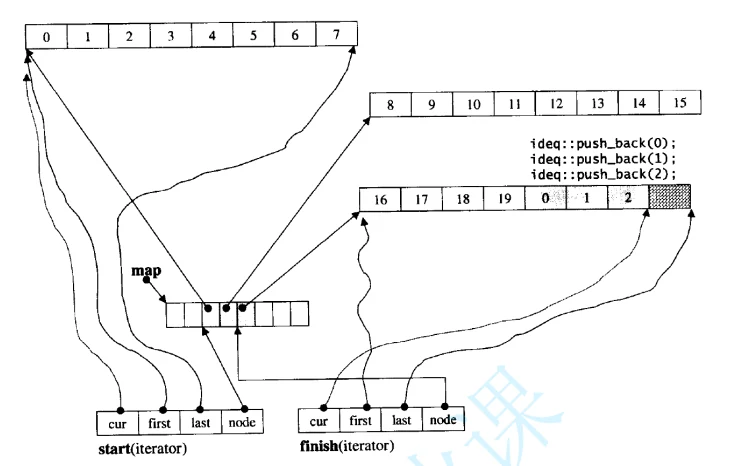
cur指向当前buffer的位置
first指向当前buffer的首元素位置
last指向当前 buffer的末位元素位置
node指向中控数组中当前buffer所在的位置.
优先级队列
队列是FIFO,而优先级队列引入优先级机制,让优先级高的先走.
它的接口如下:
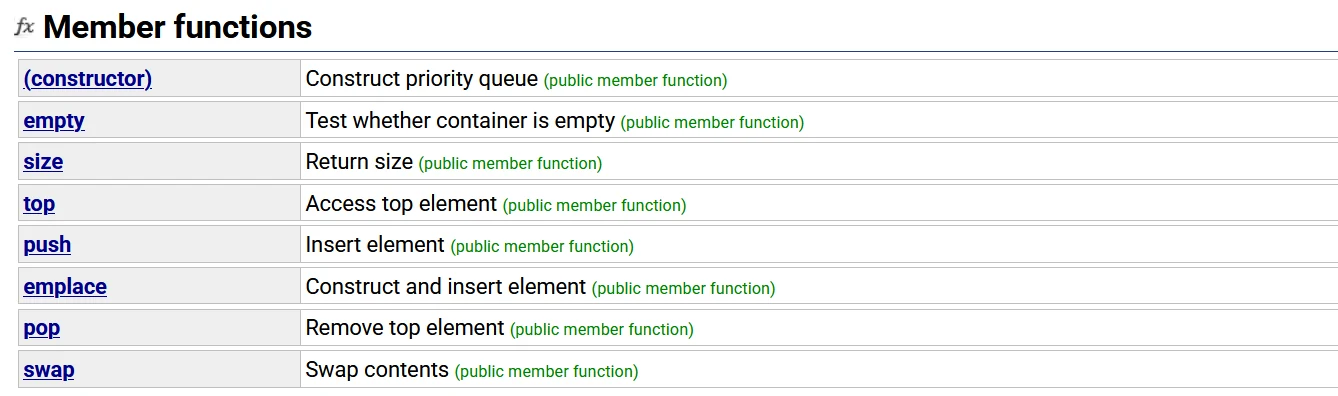
它的top接口取的是优先级最高的元素.对于优先级来说,默认大的优先级高
void test_priority_queue()
{
    priority_queue<int> pq;
    pq.push(3);
    pq.push(1);
    pq.push(9);
    pq.push(4);
    pq.push(2);
    while (!pq.empty())
    {
        cout << pq.top() << " ";
        pq.pop();
    }
}
//输出:94321
它的底层实际上是一个堆树,默认大的优先级高,那就建大堆;如果小的优先级高就是小堆.如果我们要调整它优先级的规则,我们需要使用仿函数
template <class T, class Container = vector<T>, class Compare = less<typename Container::value_type> > class priority_queue;由参数Compare进行控制,库里面为我们实现了greater和less函数,在functional头文件内.但是这个是模板的第三个参数,所以要调用这个参数第二个参数也必须进行填写
void test_priority_queue()
{
    priority_queue<int,vector<int>,greater<int>> pq;
    pq.push(3);
    pq.push(1);
    pq.push(9);
    pq.push(4);
    pq.push(2);
    while (!pq.empty())
    {
        cout << pq.top() << " ";
        pq.pop();
    }
}
//输出12349
优先队列的模拟实现
由于默认是建大堆,现在我们插入一个数据,我们可以先把这个数据放到容器尾,然后进行向上调整
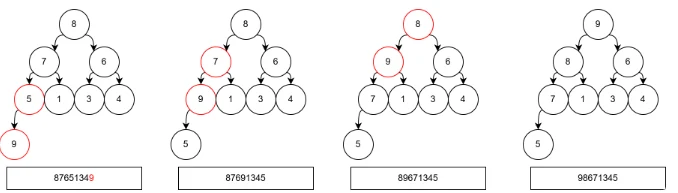
所以push的过程是把新元素放到队尾,如果这个孩子比父节点还大,就二者进行交换
void adJustup(int child)
{
	int parent = (child- 1) / 2;
	while (child>0) {
		if (_con[child] > _con[parent])
		{
			swap(_con[child], _con[parent]);
			child = parent;
			parent = (child - 1) / 2;
		}
		else
			break;
	}
}
void push(const T& x)
{
	_con.push_back(x);
	adJustup(_con.size() - 1);
}
对于删除来说,就是把堆顶的数据删除,直接删除需要重新建堆,效率太低,我们做的方式是:把根节点和最后一个结点交换位置,然后把最后一个删除.此时并不是堆,但是根节点的左子树和右子树是堆,于是进行一次向下调整即可
void AdjustDown(int root)
{
	int parent = root;
	int child = parent * 2+1;
	while (child<_con.size())
	{
		//找出左右孩子中大的那个
		if (child + 1 < _con.size() && _con[child + 1] > _con[child])
		{
			child++;
		}
		if (_con[parent] < _con[child])
		{
			swap(_con[parent], _con[child]);
			parent = child;
			child = parent * 2+1;
		}
		else
		{
			break;
		}
	}
}
void pop()
{
	swap(_con[0],_con[_con.size()-1]);
	_con.pop_back();
	AdjustDown(0);
}实际上在库中,可以通过定义仿函数来控制是建大堆还是小堆,并且实际上大小堆的差别只有一个符号,区别在于向上调整的时候是_con[child] > _con[parent]还是_con[child] <_con[parent]
仿函数本质上来说是一个类,并不是一个真正的函数
template<class T>
struct less
{
	bool operator()(const T& x1, const T& x2)
	{
		return x1 < x2;
	}
};
template<class T>
struct greater
{
	bool operator()(const T& x1, const T& x2)
	{
		return x1 > x2;
	}
};
int main()
{
	less<int> lessfun;
	cout << lessfun(1, 2) << endl;
	return 0;
}仿函数内部对()进行重载,出来调用的时候lessfun就像一个函数一样,但实际上它是一个对象.通过仿函数,我们可以控制优先队列是大堆还是小堆,只需要修改模板参数即可
template<class T,class container=vector<T>,class Compare=less<T>>然后把向上调整和向下调整对父节点和子节点的比较改为仿函数即可,最终代码如下
namespace Priority_queue {
//仿函数
	template<class T>
	struct less
	{
		bool operator()(const T& x1, const T& x2)
		{
			return x1 < x2;
		}
	};
	template<class T>
	struct greater
	{
		bool operator()(const T& x1, const T& x2)
		{
			return x1 > x2;
		}
	};
//优先队列
	template<class T,class container=vector<T>,class Compare=less<T>>
	class priority_queue
	{
	public:
		void adJustup(int child)
		{
			Compare com;
			int parent = (child- 1) / 2;
			while (child>0) {
				if (com(_con[parent], _con[child]))
				{
					swap(_con[child], _con[parent]);
					child = parent;
					parent = (child - 1) / 2;
				}
				else
					break;
			}
		}
		void push(const T& x)
		{
			_con.push_back(x);
			adJustup(_con.size() - 1);
		}
		void AdjustDown(int root)
		{
			Compare com;
			int parent = root;
			int child = parent * 2+1;
			while (child<_con.size())
			{
				//找出左右孩子中大的那个
				if (child + 1 < _con.size() && com(_con[child], _con[child+1]))
				{
					child++;
				}
				if (com(_con[parent],_con[child]))
				{
					swap(_con[parent], _con[child]);
					parent = child;
					child = parent * 2+1;
				}
				else
				{
					break;
				}
			}
		}
		void pop()
		{
			swap(_con[0],_con[_con.size()-1]);
			_con.pop_back();
			AdjustDown(0);
		}
		T& top()
		{
			return _con[0];
		}
		size_t size()
		{
			return _con.size();
		}
		bool empty()
		{
			return _con.empty();
		}
	private:
		container _con;
	};
}实际上,在进行排序的时候也会涉及到仿函数的使用,sort默认排升序
template <class RandomAccessIterator>
void sort (RandomAccessIterator first, RandomAccessIterator last);
template <class RandomAccessIterator, class Compare>
void sort (RandomAccessIterator first, RandomAccessIterator last, Compare comp);我们也可以通过仿函数取调整升序降序,默认传入less,排升序传入greater
练习
第K大的元素
给定整数数组 nums 和整数 k,请返回数组中第 k 个最大的元素。
思路:最简单粗暴的方法是直接排个序取第k个大的,那么也就是说我可以建一个优先级队列,然后直接取第k个
class Solution {
public:
    int findKthLargest(vector<int>& nums, int k) {
        priority_queue<int> pq;
        for(auto e:nums)
        {
            pq.push(e);
        }
        for(int i=0;i<k-1;i++)
        {
            pq.pop();
        }
        return pq.top();
    }
};
但是是否能进行优化?这样做时间复杂度是\(O(Nlog_2N)\).堆的插入复杂度是\(O(log_2N)\),遍历建堆就消耗了\(O(Nlog_2N)\)的复杂度.我们可以利用树的思路
我们建立一个k个数的小堆,小堆要求根节点是最小的结点.然后遍历所有的数,如果这个数比堆顶的数大,就把堆顶的数据替换为这个大数,然后重新建堆,这样每次都把这k个数里面的最小的数剔除,换进来一个比这个最小数大的数,遍历完后留下的就是前k个最大的数.
class Solution {
public:
    int findKthLargest(vector<int>& nums, int k) {
        priority_queue<int,vector<int>,greater<int>> kminheap;
        for(int i=0;i<k;i++)
        {
            kminheap.push(nums[i]);
        }
        for(int i=k;i<nums.size();i++)
        {
            if(nums[i]>kminheap.top())
            {
                kminheap.pop();
                kminheap.push(nums[i]);
            }
        }
        return kminheap.top();
    }
};
这样复杂度变成了\(O(Klog_2N)\).