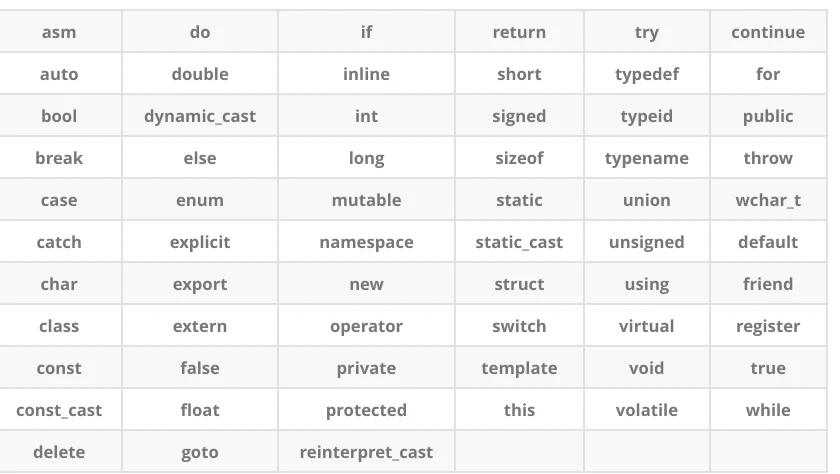
C++关键字
简单了解,后续会详细说明
命名空间
在C/C++中,变量、函数和后面要学到的类都是大量存在的,这些变量、函数和类的名称将都存在于全局作用域中,可能会导致很多冲突。使用命名空间的目的是对标识符的名称进行本地化,以避免命名冲突或名字污染,namespace关键字的出现就是针对这种问题的
#include <stdio.h>
#include <stdlib.h>
int rand = 10;
// C语言没办法解决类似这样的命名冲突问题,所以C++提出了namespace来解决
int main()
 {
    printf("%d\n", rand);
	 return 0;
 }
 // 编译后后报错:error C2365: “rand”: 重定义;以前的定义是“函数”
命名空间的定义
定义命名空间,需要使用到namespace关键字,后面跟命名空间的名字,然后接一对{}即可,{} 中即为命名空间的成员。
// bit是命名空间的名字,一般开发中是用项目名字做命名空间名。
// 1. 正常的命名空间定义
namespace bit
 {
    // 命名空间中可以定义变量/函数/类型
    int rand = 10;
    int Add(int left, int right)
    {
        return left + right;
    };

	struct Node
	 {
		 struct Node* next;
		 int val;
	 };
 }
 //2. 命名空间可以嵌套
// test.cpp
 namespace N1
 {
	 int a;
	 int b;
	 int Add(int left, int right)
	 {
		 return left + right;
	 }
	 namespace N2
	 {
		int c;
		int d;
		int Sub(int left, int right)
		{
			return left - right;
		}
	 }
 }
//3. 同一个工程中允许存在多个相同名称的命名空间,编译器最后会合成同一个命名空间中。
// ps:一个工程中的test.h和上面test.cpp中两个N1会被合并成一个
注意:一个命名空间就定义了一个新的作用域,命名空间中的所有内容都局限于该命名空间中
命名空间的使用
namespace bit
 {
 // 命名空间中可以定义变量/函数/类型
	 int a = 0;
	 int b = 1;
	 int Add(int left, int right)
	 {
		 return left + right;
	 }
	 struct Node
	 {
		 struct Node* next;
		 int val;
	 };
  }
 int main()
 {
	 // 编译报错:error C2065: “a”: 未声明的标识符
	printf("%d\n", a);
	return 0;
 }
使用命名空间有三种方式.
1.加命名空间名称及作用域限定符
#include <iostream>//C++输入输出流。相当于stdio

int main()
{
	std::cout << "hello world\n";//指定在std命名空间,标准输出流 "\n"换行符
	std::cout << "hello world"<< std::endl;//这样也是换行,他们都是包在iostream里的
	//cout和printf使用是有区别的
	int i = 0;
	double d = 1.11;
	std::cout << i << " " << d << std::endl;//输出i" "d
	//cout可以实现自动区分类型,是通过函数重载实现的,不需要我们指定“%s,%d“之类的行为
	return 0;
}
std是C++默认定义的命名空间,但是这样每次都指定std::非常麻烦,我们可以直接展开std命名空间,这样就可以直接调用,对于cout的实现,可以看类和对象
2.使用using namespace+命名空间名称引入
using namespace std; //C++库中所有的东西都放到了std命名空间
//int cout = 10;
int main()
{
	cout << "hello world\n";//指定在std命名空间,标准输出流 "\n"换行符
	cout << "hello world" << std::endl;//这样也是换行,他们都是包在iostream里的
	//cout和printf使用是有区别的
	int i = 0;
	double d = 1.11;
	cout << i << " " << d << std::endl;//输出i" "d
	//cout可以实现自动区分类型,是通过函数重载实现的,不需要我们指定“%s,%d“之类的行为
	return 0;
}
但是展开带来的问题是,我在命名变量的时候,变量名不能和命名空间内的东西重合,假如取一个叫cout的变量,它就会和iostream的cout发生冲突.解决方法是,不做这样的名称定义.但是在实际项目中,会有这样的需求,我们完全可以不把std完全展开,而是只引入我们需要的部分.
3.使用using关键字引入
using std::cout;
using std::cin;
int main()
{
	cout << "hello world\n";//指定在std命名空间,标准输出流 "\n"换行符
	cout << "hello world" << std::endl;//这样也是换行,他们都是包在iostream里的
	//cout和printf使用是有区别的
	int i = 0;
	double d = 1.11;
	cin >> i >> d;//控制台输入流流向i和d
	cout << i << " " << d << std::endl;//输出i" "d

	//cout可以实现自动区分类型,是通过函数重载实现的,不需要我们指定“%s,%d“之类的行为
	return 0;
}
这样就可以定义除了cout以外的其他同名变量.在日常练习中,建议直接using namespace std即可,这样就很方便.如果把using namespace std展开,标准库就全部暴露出来了,如果我们定义跟库重名的类型/对象/函数,就存在冲突问题。该问题在日常练习中很少出现,但是项目开发中代码较多、规模大,就很容易出现。所以建议在项目开发中使用,像std::cout这样使用时指定命名空间 + using std::cout展开常用的库对象/类型等方式。
C++的输入和输出
#include<iostream>
 // std是C++标准库的命名空间名,C++将标准库的定义实现都放到这个命名空间中
using namespace std;
 int main()
 {
	 cout<<"Hello world!!!"<<endl;
	 return 0;
 }
cin和cout是标准输入流里的内容,使用时必须包含头文件< iostream >,并且按照命名空间的方法使用std
using namespace std; //C++库中所有的东西都放到了std命名空间
int main()
{
	cout << "hello world\n";//指定在std命名空间,标准输出流 "\n"换行符
	cout << "hello world" << std::endl;//这样也是换行,他们都是包在iostream里的
	//cout和printf使用是有区别的
	int i = 0;
	double d = 1.11;
	cout << i << " " << d << std::endl;//输出i" "d
	return 0;
}
使用cin和cout时,不像printf和scanf一样需要手动指定类型,C++的输入输出可以自动指定格式.
缺省参数
缺省参数是声明或定义函数时为函数的参数指定一个缺省值。在调用该函数时,如果没有指定实参则采用该形参的缺省值,否则使用指定的实参。
void Fun(int a=114514)
{
	cout << a << endl;
}

int main()
{
	Fun();
	Fun(10);
	return 0;
}
//输出
//114515
//0
缺省参数分为全缺省和半缺省,全缺省指一个函数的所有参数都设置了缺省值
void Fun(int a = 114, int b = 514, int c = 1919)
{
	cout << "a=" << a << endl;
	cout << "b=" << b << endl;
	cout << "c=" << c << endl;

}

int main()
{
	Fun();
	Fun(1);
	Fun(1, 2);
	Fun(1, 2, 3);
	return 0;
}
注意全缺省的参数只能是顺序填写,不能实现只传入c不传ab,传参必须是从左往右依次传参
而半缺省值的是一个函数的参数只有一部分参数设置了缺省值
void Fun(int a, int b = 514, int c = 1919)
{
	cout << "a=" << a << endl;
	cout << "b=" << b << endl;
	cout << "c=" << c << endl;

}

int main()
{
	//Fun();//由于有参数未进行默认赋值,此时不再允许不传参数
	Fun(1);
	Fun(1, 2);
	Fun(1, 2, 3);
	return 0;
}
半缺省操作中缺省必须从右往左连续缺省,不能ac缺省,b不缺省。
函数重载
函数重载:是函数的一种特殊情况,C++允许在同一作用域中声明几个功能类似的同名函数,这些同名函数的形参列表(参数个数或类型或类型顺序)不同,常用来处理实现功能类似数据类型不同的问题。
int Add(int x, int y)
{
	return x + y;
}

float Add(float x, float y)//类型不同
{
	return x + y;
}

int Add(int x, int y, int z)//个数不同(0个也可以)
{
	return x + y + z;
}

void Printf(char* x,int y);
void Printf(int x,char* y);
//类型顺序不同

//函数重载的调用会自动进行识别
int main()
{
	Add(1, 2);
	Add(1.0f, 2.0f);
	Add(1, 2, 3);
	return 0;
}
但是,为什么C++能够支持函数重载,而C不可以?
在C/C++中,一个程序要运行起来,需要经历以下几个阶段:预处理、编译、汇编、链接。
预处理->头文件展开/宏替换/条件编译/去除注释.得到 .i 文件
编译->检查语法,生成汇编代码
汇编->把汇编代码转成二进制机器码,得到.o目标文件
链接->将多个目标文件链接到一起
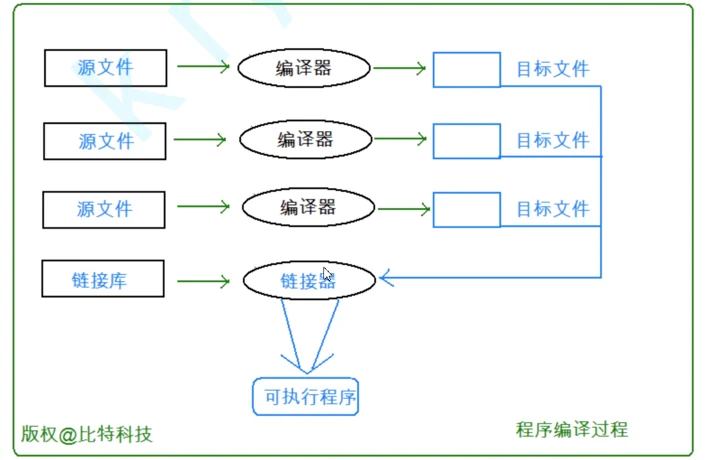
假设有一个test.c文件,里面调用了fun.c文件内定义的函数Fun();在汇编过程中,test.o文件内会对Fun进行调用,生成如下语句call Fun(函数地址),但是这个时候test.o文件下没有这个地址,因为此时只展开了头文件,Fun的定义(由函数地址指向)却找不到. Fun.o底下有Fun的定义,里面有一个部分叫符号表,它存储了函数的函数名和函数的地址.为了找到这个地址,就必须有链接这一步.在链接前,test.o中是call Fun(?),表示这个函数只有声明,没有定义,所以无法找到它的地址,这个时候,链接过程会到其他目标文件中找这个函数的地址,如果找不到,就会报链接错误.
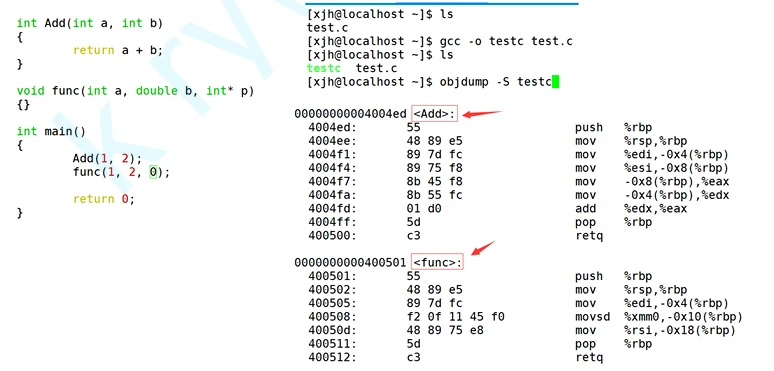
而c语言中,调用Fun函数生成的语句就是call Fun(函数地址),但是C++会根据函数对函数名进行修饰,并call 经过修饰后的函数名.
采用C语言编译器编译后结果:
采用C++编译器编译后结果:
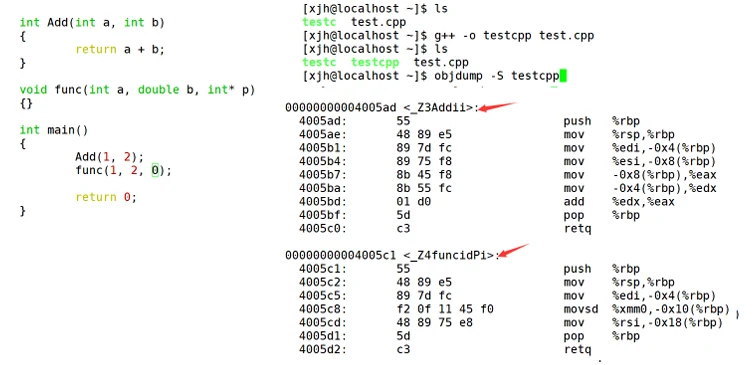
C++对函数的修饰是根据一些规则进行的,这样就能够实现同样的函数名在修饰后得到的名称不会相同,因此在C++中就能定义同名的函数,并实现函数重载.vs的修饰规则如下:
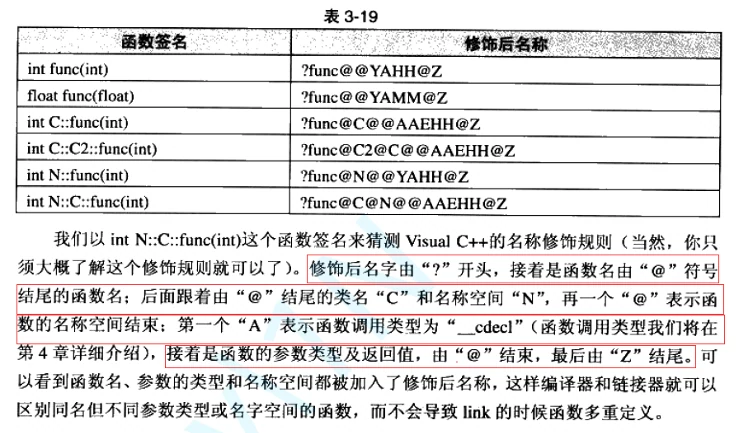
那么到这里,我们可以对为什么一定是”类型顺序”不同进一步做出解释:
int Add(int x,int y);
int Add(int y,int x);
这两个函数不构成重载,因为它们在修饰后,得到的函数名都是 _Z4Addii.最后两个i指的是函数的参数为是两个int.既然修饰后还是一样的,当然不构成重载.
关于extern “C”:
如果我有一个C语言程序,但是我希望调一个C++的库,就无法实现,因为链接时使用的是call + 函数名(),但是在C++中是 call+修饰后的名称.那么有没有办法让我的C程序能用C++的静态库呢,也就是让C和C++在链接的时候都能找到它.那么C++给出了一种方法
extern "C" int Add(int x,int y);这句话类似于头文件的作用,将C++的静态库对C进行声明.但是这样做以后这个函数就不支持重载了,C++对该函数进行查找的时候也就不再按照C++的规则了,而是按C的方式直接进行查找.
引用
引用
引用相当于给已经存在的变量取了一个”别名”
int main()
{
	int a = 1;
	int& ra = a;//ra是a的引用,也就是别名
	int& rb=ra;
	ra=10;
	return 0;
}
在物理空间上,我们开辟了一块空间,起名为a,然后通过引用,又给他起了一个别名ra,ra和a是完全等价的,编译器不会为ra单独再开辟空间,ra和a共用一个空间.
注意:
1.引用在定义的时候必须初始化,否则无法确定是谁的引用.
2.一个变量可以有多个引用.
3.引用一旦形成,就不能再引用其他实体.
常引用
int main()
{
	const int a = 1;
	int& ra = a;//error
	return 0;
}
编译不通过,原因是a是常量,相当于是只读的,但是ra是a的引用,类型是int型,是可读可写的,相当于起个别名后const限定符被丢失了,这显然是不可取的.所以引用要保持限定符的一致.
int main()
{
	const int a = 1;
	const int& ra = a;//√

	const int*pa=&a;
	int *ppa=pa;//error
	return 0;
}
但是,这样是可以的,相当于我在引用时给原来的变量加了修饰.a可读可写,ra变成了只读.对于引用而言,权限可以缩小,但是不能放大,该原则对于指针也适用,本质上来说对同一块内存进行的操作都要遵循这个原则。
int main()
{
	int a = 1;
	const int& ra = a;//√

	int* pa=&a;
	const int* ppa=pa//√
	return 0;
}
现在我对原变量进行隐式类型转换,将int转为double.这样是不行的,但是加上const限定符就可以
int main()
{
	int a = 1;
	double i = a;
	double& ri = a;//error
	return 0;
}
int main()
{
int a = 1;
double i = a;
const double& ri = a;//√
return 0;
}原因是在执行这段语句double& ri = a时,由于a是int型,而ri是double型.所以ri并不是直接引用a,而是a先进行隐式类型转换产生一个double类型的临时变量,然后ri再对该临时变量进行引用.而临时变量有常属性,因此需要使用const修饰.
引用的作用
1.引用作参数
void swap_c(int* a, int* b)
{
	int tmp = *a;
	*a = *b;
	*b = tmp;
}

void swap_cpp(int& r1, int& r2)
{
	int tmp = r1;
	r1 = r2;
	r2 = tmp;
}
int main()
{
	int a = 0, b = 1;
	swap_c(&a, &b);
	swap_cpp(a, b);
}
对于交换函数,在C语言中,我们采用传入地址的方式,但是在C++中,我们可以通过传入引用来进行。当调用swap_cpp(a,b)时,函数内部创建了a的引用r1和b的引用r2,然后通过交换两个引用来交换ab,在这个过程中并没有发生新空间的创建,因此可以直接交换.
2.引用做返回值
int Count1()
{
	static int n = 0;
	n++;
	return n;
}

int& Count2()
{
	static int n = 0;
	n++;
	return n;
}
int main()
{
	int& a = Count1();//error
	const int& c = Count1();
	int& b = Count2();
	return 0;
}
对于函数1,执行到return n时会创建一个临时变量,将n的值赋给临时变量后返回该临时变量,这个过程是要开辟一个临时变量的空间的.而对于函数2,也可以认为它产生了一个临时变量,但这次产生的临时变量是n的引用,不会再开辟新的空间.可以这么认为:函数1返回的是n的拷贝,函数2返回的就是n本身.
在main函数中,第一句话由于函数1返回的是临时变量,具有常属性,因此直接定义引用进行接收就会报错,但是加常变量修饰后就能正常接收.
int& Add(int a, int b)
{
	int c = a + b;
	return c;
}
int main()
{
	int& ret = Add(1, 2);
	Add(3, 4);
	cout << "Add(1, 2) is :" << ret << endl;
	return 0;
}输出在x86平台上是7,x64平台上是一个负极大数,都不是我们想要的,为什么?首先,我们获得的是c的引用,也就是c本身.但是c的生命周期就在Add函数里面,执行完就被销毁了,那拿到的当然就是一块未定义的空间.对于x86平台,内存被释放后里面的数据并不会进行销毁,而是等待被再次覆盖.我们直接再次调用Add(3,4)函数,两次调用作用在同一块空间,第二次调用Add后c的值变为了7,那么ret也会是c.但是假设我们在Add(3,4)前任意调用一次其他函数都会导致原本的空间被覆盖,最终输出随机值;而x64平台则因为非法访问内存直接返回负极大数.所以使用引用进行局部变量的返回是不安全的.
那么,加上static能解决问题吗?一定程度上可以,但是由于静态变量只会进行一次初始化,这就导致假设你之后想用Add函数计算其他数据的和,最终得到的结果也还是3.
那引用返回有什么好处呢?引用返回可以少创建一个临时变量,这样可以提高效率,而且还有一些其他好处,具体以后再说.最后强调,只有出了函数还存在的变量能使用引用返回,如全局变量,静态变量等.
指针和引用的区别
在实际情况下,能用引用实现的东西基本也可以用指针实现,但是实际上它们是有区别的
int main()
{
	int a = 10;
	int& b = a;
	int* p = &a;
}
1.从语法概念上来说,b是a的别名,而p是开辟了一段空间来存储a的地址.但是这只是从语法概念上.我们转到汇编,发现引用实际上也是通过指针实现的.
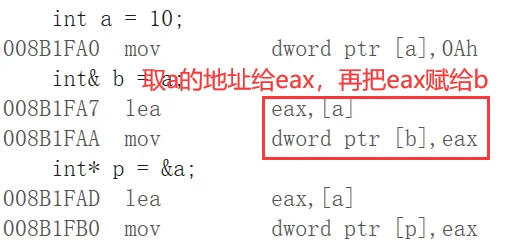
2.引用必须初始化,而指针不需要.
3.有空指针,但是没有空引用.
4.引用初始化后不能再引用其他实体,而指针可以.
5.sizeof意义不同,sizeof(引用)指引用对象的大小,而sizeof(指针)指地址空间的大小(32位平台下均为4字节)
6.有多级指针,但是没有多级引用.
7.指针+1表示向后移动一位,引用+1表示引用的实体+1
内联函数
概念
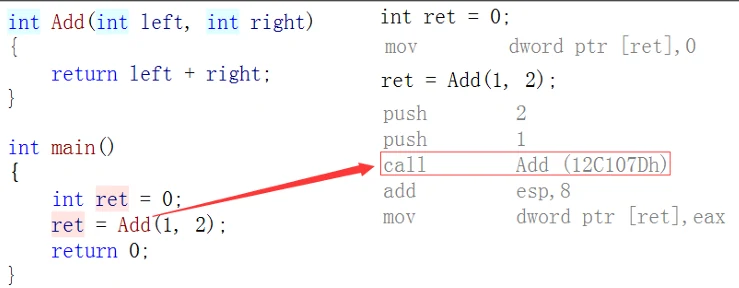
函数在调用(call)的时候会建立一个栈帧,而传参的过程本质上是在入栈.而创建栈帧这一过程必然会带来效率的损耗.为了解决这个问题,C语言中使用宏函数可以解决此问题,宏函数在预处理阶段就已经展开,不用每次都因调用而创建栈帧.但是宏函数也有很多缺点;而C++则使用内联函数.
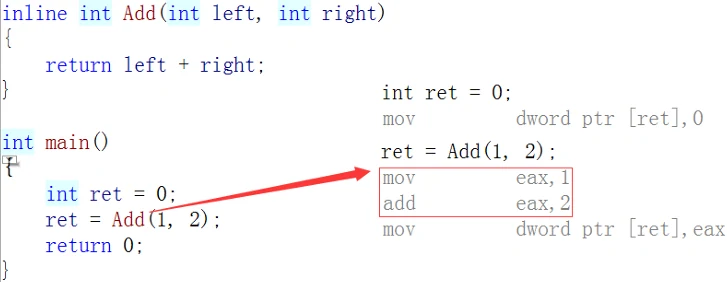
内联函数只需要在函数名前添加inline即可,这样该函数会在调用它的地方被展开.
inline int Add(int x, int y)
{
	return x + y;
}
int main()
{
	int ret = Add(1, 2);
	return 0;
}
设置为inline后,一般debug模式下也不会起作用,但是当切换为release后就会直接展开,不再建立栈帧
特点
内联函数是一种空间换时间的方法,如果函数被inline修饰,在编译阶段,会用函数体代替函数调用,不再有call的阶段,而是直接展开,这样可能会导致目标文件变大.
解释:假设一个函数有10行指令,在程序中被调用了1w次,如果是常规函数类型,消耗的空间是10010(1w次调用+10行函数指令存储),而如果修改为内联函数,每调用一次都会进行一次展开,最终消耗的空间是10w.
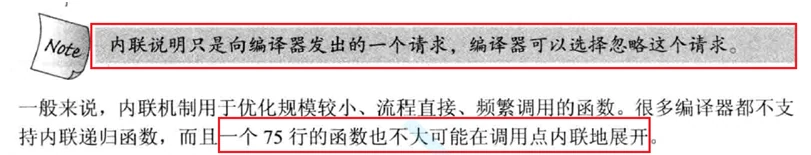
所以:代码较为短小,非递归的函数才适用于内联函数,而且编译器会自行决定是否启用内联优化.
此外,内联的声明和定义不能分离.
// F.h
 #include <iostream>
 using namespace std;
 inline void f(int i);
 // F.cpp
 #include "F.h"
 void f(int i)
 {
	 cout << i << endl;
 }
 // main.cpp
 #include "F.h"
 int main()
 {
	 f(10);
	 return 0;
 }
 // 链接错误:main.obj : error LNK2019: 无法解析的外部符号 "void __cdecl
f(int)" (?f@@YAXH@Z),该符号在函数 _main 中被引用
因为内联函数在调用的时候就直接被展开了,压根没有地址,所以会找不到.
内联函数是对宏函数的替换,宏不方便调试,可读性差,并且没有安全检查,而内联解决了这个问题.此外,C++建议宏定义常量用const enum进行替代
#define a 1
const int a=1;
auto关键字(C++11)
在C++11中,auto关键字支持自动推导变量.
int main()
{
	int a = 0;
	auto b = 0;//b的类型是根据a的类型推导的,推导出b的类型为int。
	int& c = a;
	auto& d = a;
	auto* e = &a;
	cout << typeid(a).name() << endl;
	cout << typeid(b).name() << endl;
	cout << typeid(c).name() << endl;
	cout << typeid(d).name() << endl;
	cout << typeid(e).name() << endl;
	return 0;
}
输出:int,int,int,int,int *
auto的作用
实际上,前面我们几乎不会使用auto,但是当学习完map后就能知道它真正的意义,这里只做了解,此外,auto还有其他作用,后续再说
#include <map>
int main()
{
	std::map<std::string, std::string>dict;//使用map
	std::map<std::string, std::string>::iterator it1 = dict.begin();//调用一个函数遍历这个map
	auto it2 = dict.begin();//这一句和上面很长的代码完全等价
	return 0;
}
auto不能推导的场景
1.auto不能作为函数参数
2.auto不能用于声明数组.
void test(auto a)//error
auto b[];//error
范围for
int main()
{
	int array[] = { 1,2,3,4,5 };
	//要求将数据中的数值x2后打印一遍,C语言实现
	for (int i = 0; i < sizeof(array) / sizeof(array[0]); i++)
	{
		array[i] *= 2;
	}
	for (int i = 0; i < sizeof(array) / sizeof(array[0]); i++)
	{
		cout << array[i] << ",";
	}
	cout << endl;
}
而在C++中,为我们提供了范围for,它的意义在于会基于范围自动进行遍历,直到结束.至于它的底层实现,我们以后再讲String
int main()
{
	int array[] = { 1,2,3,4,5 };
	//要求将数据中的数值x2后打印一遍,C++实现
	for (auto& e:array)//把array的每个值取出来依次赋给e,而e是array的值的引用
	{
		e*= 2;
	}
	for (auto e : array)
	{
		cout << e << ",";
	}
	cout << endl;
}
范围for与普通循环类似,可以用continue跳过,也可以用break跳出.此外,要注意如下这种代码是无法使用范围for的
void TestFor(int array[])
 {
	 for(auto& e : array)
	 cout<< e <<endl;
 }
因为传入的是数组首元素的地址,不再是数组,因而不知道数组的大小,也就无法确定什么时候遍历结束.
指针空值nullptr
int main()
{
	//C语言
	int*p1=NULL;
	//C++
	int*p2=nullptr;
	return 0;
}
为什么C++推荐使用nullptr?
void fun(int n)
{
	cout << "整形" << endl;
}
void fun(int* n)
{
	cout << "整形指针" << endl;
}
int main()
{
	fun(NULL);
	fun(0);
	fun(nullptr);
	return 0;
}
输出:整形 整形 整形指针
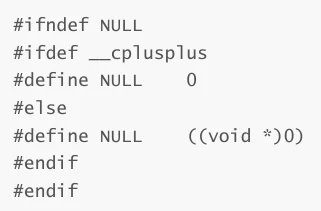
现在fun构成重载,NULL被匹配到整形,而nullptr被匹配到指针.因为在C++中,NULL实际上是一个宏,定义得到的就是0,在预处理后NULL就被处理成了0,并不能很好的代替空指针,而nullptr也是0,但是会被处理为(void*)0.